
 立即咨询
固定资产与设备台账问数
资产占制造企业固定资产的较大比重,账实清晰是管理的重要基础。技术上,业务人员用自然语言问数看清账实,靠的是一条四段链路:字段地图统一口径,问句转查询取数,检索与图谱补上语义和关系,系统再按意图出图和下钻。下面拆开讲这条链路怎么搭。
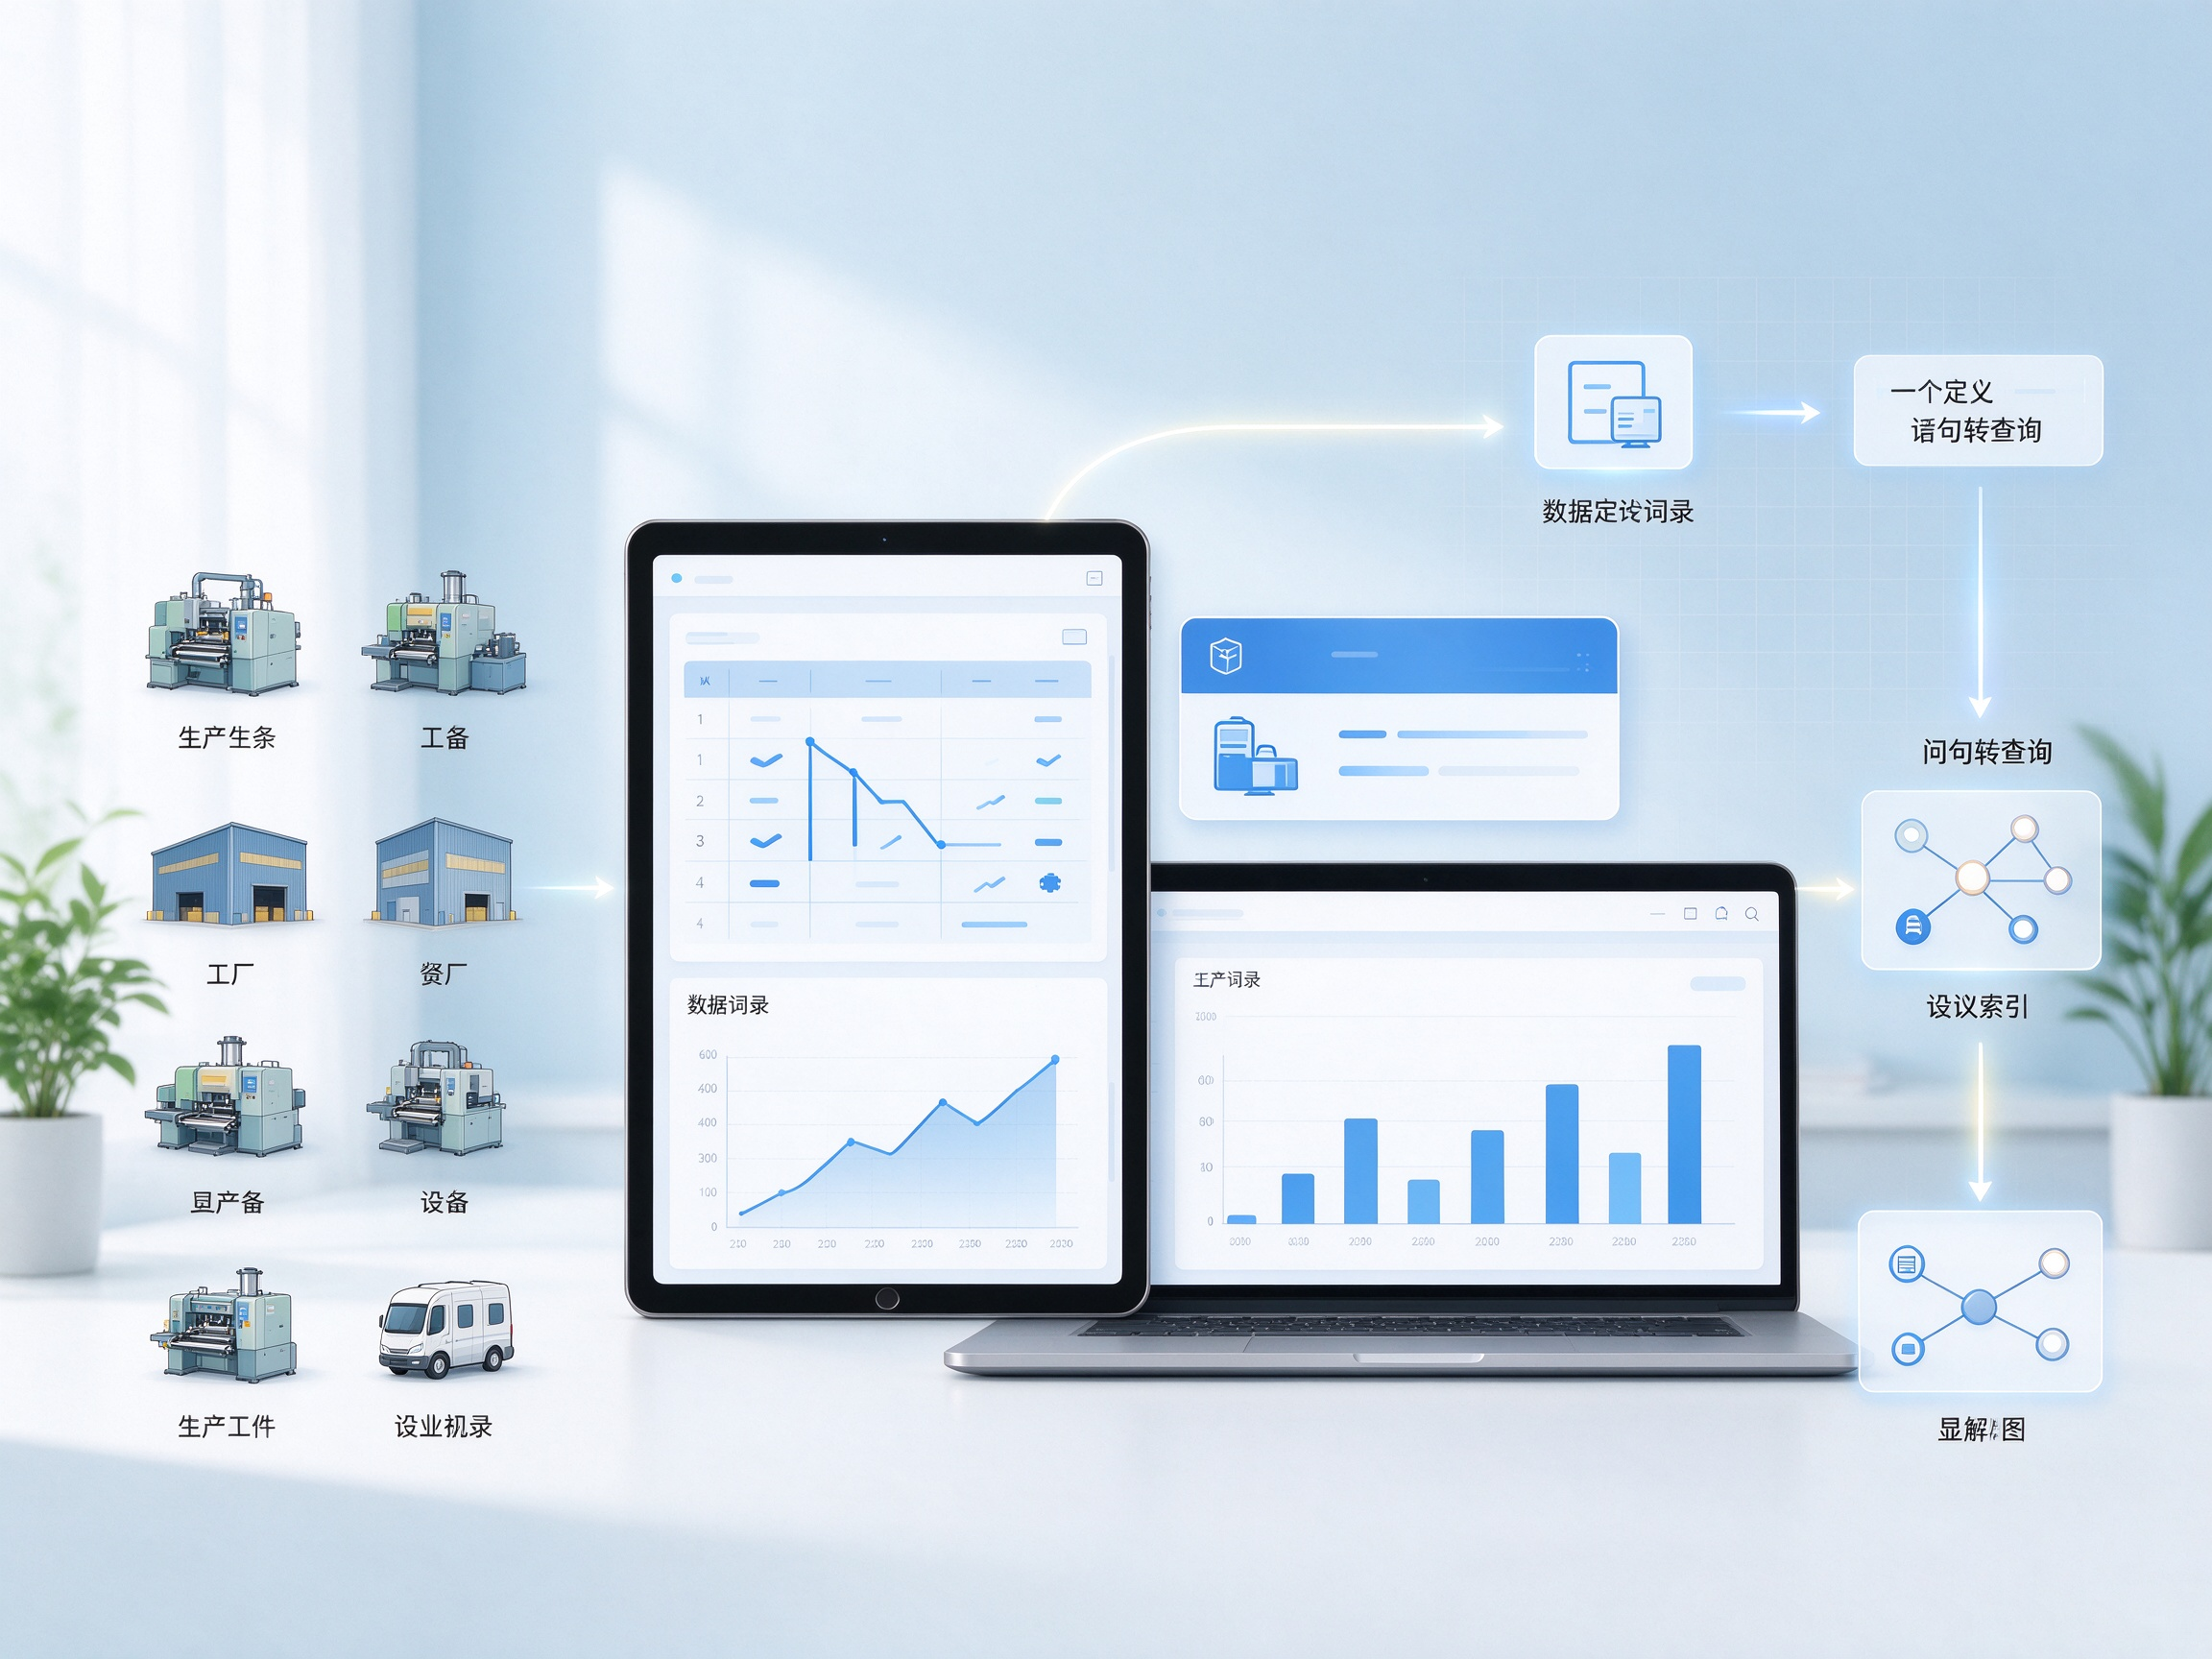
字段地图统一口径
资产数据地图本质是字段注释层。它把"原值""累计折旧""净值""月利用率"这些业务词,逐一绑到底层表的实际字段,并写清类型与口径。原值和累计折旧都标 decimal,前者口径写清含不含运费,后者按财务月计提走。净值没有独立存储,靠原值减累计折旧实时算出,地图里写明这个公式。月利用率定为 float,定义成开机时长除以排班时长。这套思路来自数据仓库的语义层,后被 RAG 的字段注释机制承接,把"人话"和"表字段"的翻译固定下来。NL2SQL 生成的 SQL 需要了解字段在哪张表、什么类型、什么口径,地图缺少信息时,查询可能指向错误列,结果可能产生偏差。口径不一致的后果较为明显:A 表原值含运费、B 表不含,同一台设备查询结果可能差出运费那笔,跨表汇总可能重复或缺失,地图把口径写成可选项,提问时指定,结果才可比。
问句转查询
业务人员打"各分公司设备原值合计排个序",系统先把问句做意图识别,判断这是聚合排序而非趋势。意图分四类:聚合算合计或平均,对比看谁多谁少,趋势看随时间变化,下钻做逐层细化,系统通常先判类,再据此选择生成聚合 SQL 还是带时间窗口的 SQL。实体对齐接住"分公司""设备""原值",认到地图对应字段。查询生成按字段类型拼 SQL,分组落到 GROUP BY 分公司,金额汇总走 SUM(原值),排序交给 ORDER BY 合计 DESC。一句中文最终变成 SELECT 分公司, SUM(原值) FROM 设备表 GROUP BY 分公司 ORDER BY SUM(原值) DESC。模糊问法靠向量检索补:把问句和字段说明转成向量做语义匹配,模型认出"合计"对应 SUM、"排个序"对应 ORDER BY。
检索补语义
纯 NL2SQL 处理不了"那种老设备""常用的型号"这类模糊指代,因为库里没有对应字段。向量检索用 BGE-M3(北京智源研究院发布)把问句和字段、实体说明转成高维向量,按语义相似度找近邻,容错性较高。ES 全文检索管精确字符串,设备编号、型号代号这类硬匹配交给它。两套结果不能简单相加:余弦相似度落在 [-1,1],BM25 没有上界,量纲不同直接加权会被大尺度那路主导。工程上用 RRF 做融合排序,或上 cross-encoder 做重排,再取 Top 片段喂给生成。这一步在很大程度上影响进模型的片段是否准确,是值得重点投入的环节。向量库 Milvus 支持 IVF_FLAT、HNSW 多种索引,数据规模小用 IVF_FLAT 省内存,规模大用 HNSW 提速度。
实体关系靠知识图谱
设备挂在哪个部门、部门属于哪个分公司,这类归属存在图库里。图谱可通过从设备手册、采购合同里做实体识别和关系抽取自动构建,新增设备时可增量更新。问"华东分公司 CNC 利用率最低的设备",NL2SQL 先取数值排名,Cypher 再沿 (分公司)-[:包含]-(部门)-[:拥有]-(设备) 的路径定位到具体节点。图谱给多轮下钻提供了结构:上一轮锁定的"华东分公司"作为过滤条件,下一轮直接复用,不用每句重说。
图表按意图自动选
系统可根据解析出的意图选择图表。比较类意图可输出柱状图,趋势类可输出折线图,占比分布可输出饼图或堆叠图。
每轮问答的过滤条件和实体焦点写进会话状态,下一问继承上一问。问完“全公司设备利用率”再问“华东分公司呢”,华东作为分公司过滤可自动接上。这套状态管理借用 LangGraph Checkpointer 的思路,任务中断能从检查点续跑。
资产账实要清,可借助字段地图加 NL2SQL、检索融合、图谱下钻这条技术链路。小艾智能体在资产管理场景可支持这套链路落地:字段注释可承接多表语义,RAG 加知识图谱可支撑问数,服务可支持私有化。把台账用技术手段盘点清楚,资产管理部门才更有可能用数据辅助决策。