
私有化部署成刚需:企业级AI智能体 为什么必须把数据留在本地?
2026 年,企业采购 AI 智能体时,第一个被追问的问题已经从“效果好不好”变成“数据出不出内网”。《数据安全法》《个人信息保护法》与网络安全等级保护 2.0 把数据可控写成了硬约束;工艺配方、客户名单、病历资料、财务凭证一旦进入公网推理链路,合规责任与商业风险同时落到企业头上。私有化部署由此从加分项变成准入项。下面讨论三件事:公网调用卡在哪里,私有化真正买到什么,合格的私有化架构该有哪些标准。
一 采购清单变了:部署方式成了第一条否决项
近两年企业 AI 招标文件里,出现频率上升最快的条款与模型能力无关,而是“须支持本地化部署”“模型与数据不得出内网”“需提供离线环境运行证明”。医疗、金融、能源三个行业态度最坚决,制造业次之。原因不复杂:AI 系统的价值来自对私有数据的利用,数据越核心,越不能离开本地。
卡在这一条上的企业通常有三类。一类受明确行业监管,病历、影像、信贷资料不允许上传第三方平台;一类把工艺配方、报价体系、客户结构视为竞争壁垒;一类 IT 资产较重,ERP、MES、HIS 全在内网,外部服务难以穿透到业务链路。对它们来说,部署方式不是技术偏好,而是项目能否立项的前提。
评估方式也在变。早期只看“支持不支持私有化”这个勾选项,现在会追问:哪些组件真的跑在本地,推理是否调用外部接口,日志存在哪里,断网之后系统还能不能响应。标准其实只有一条——数据边界是否清晰可验证。
二 公网调用模式的三个现实问题
把大模型能力通过 API 接入业务系统,启动成本低、上线快,作为验证手段是合理的。问题出现在它被当成长期生产方案之后。
第一是数据泄露与合规责任。文档一旦上传就离开了控制范围。多数服务条款允许服务方为“服务改进”留存一定期限的交互数据,部分场景涉及跨境传输;企业无法审计对方的存储位置、访问权限与销毁机制,发生泄露时举证责任和监管处罚都落在自己身上。
第二是能力不可控。版本迭代、接口参数、限流策略、计费方式都由服务方决定。更隐蔽的是模型漂移:同一个提示词,两个月后的判断标准可能已经变化,而依赖它的审批规则、客服话术、报告模板并不会同步更新。
第三是集成壁垒。内网系统没有公网出口,要把 ERP 的库存、MES 的工单喂给模型,中间得加网关、白名单与脱敏层,每加一层就多一处故障点和安全暴露面。权限体系也很难对齐:业务系统按角色授权,公网调用通常只有一个 API Key。
三 私有化部署真正买到的是什么
把私有化理解成“把软件装在自己机房”,容易低估它的价值。企业付出的算力与运维成本,换来四项能力的回归。
数据主权是最基础的一项。文档、会话记录、检索日志、模型权重全部留在内网,等保测评、行业检查、内部审计时,数据流向可以说清楚、拿得出证据。定制深度是第二项:可以按业务语料微调,可以替换底层模型,可以改写工作流的每个节点;公网 API 模式里能调整的部分基本只剩提示词。
第三项是性能与容量的可控性。算力专属意味着响应时间稳定,不受外部并发限制,高峰可按需扩容。第四项是成本结构的可预测性,这一点常被误读,下面这张表把两种模式摆在一起看。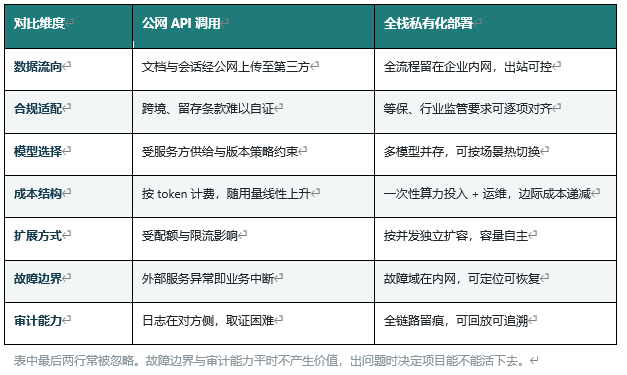 对比维度
四 企业级私有化智能体的四条架构标准
把“支持私有化”当作二元选项,是选型中最常见的简化。真实差异在架构层面,可以用四条标准判断。
第一条,全栈本地化。向量库、图数据库、全文检索引擎、消息队列、缓存、模型推理服务,每一个组件都要能在内网独立运行,不隐含对外部云服务的调用。有些方案前端部署在本地,检索与推理仍走公网接口,验收时用断网跑一遍完整流程就能露馅。
第二条,模型兼容与热切换。合同审查要长上下文,工单分类要低延迟,报表生成要结构化输出,架构上应支持开源与闭源模型并存,按场景与算力条件切换,避免绑定在单一模型上。
第三条,弹性扩展。Agent 执行、模型推理、向量检索的负载特征完全不同,合并部署会让扩容变成整体升级;微服务拆分之后,哪一环压力大就扩哪一环。
第四条,可运维可观测。节点级执行日志、任务轨迹回放、Token 与耗时统计、权限与操作留痕,缺一项都会在出问题时变成黑箱。合规检查时,“系统是怎么判断的”必须有据可查。
五 三个高频误区:伪私有化、只买模型、离线孤岛
伪私有化的判断方法前面已经给过:断网测试、组件清单核对、出站流量观察,三项做完,宣称与实际的差距会很明显。
第二个误区是把模型当成全部。模型是发动机,编排引擎、检索链路、权限体系、监控告警才是整车。落地失败的案例里,相当一部分并非模型不够强,而是任务拆解不清、知识没有加工、输出回不到业务系统。
第三个误区是把私有化等同于离线孤岛。它的核心是数据边界清晰、外联行为可控,需要获取公开信息时仍可联网,只是要走统一出口与审计。做成完全封闭,反而牺牲掉大部分实用能力。
六 小艾智能体的私有化落地实践
把上述标准落到产品层面,小艾智能体(艾艺科技旗下企业级 AI 智能体产品)的架构可以逐条对照。
全栈本地化方面,系统以 FastAPI + Python 3.10 为应用框架,LangGraph 承担工作流编排与状态流转,Milvus 负责向量检索,Neo4j 存储知识图谱,Elasticsearch 提供全文检索,RabbitMQ 与 Redis 处理异步消息和热点缓存;推理服务本地部署,兼容 DeepSeek、GPT 系列与智谱等模型并支持热切换,整套组件运行在企业内网。
22 个以上预置节点覆盖数据处理、逻辑控制与外部交互,工作流通过 JSON/YAML 配置搭建,支持条件路由、状态传递、并行执行与断点续跑;REST API 节点用于对接 ERP、MES、HIS、CRM,业务数据在内网闭环,不必为对接单独开公网通道。
知识沉淀同样在本地完成:PDF、Word、Excel、图片等格式统一解析,语义分块后用 BGE-M3 向量化入库,同步构建实体关系图谱;用户反馈与人工修正进入自学习闭环,高质量问答自动转为知识条目。
部署采用微服务架构,各模块独立扩容。官方服务器配置按角色划分:Java 与前端服务 8 核 16G,Python Agent 服务 8 核 16G 配 A800 40G,LLM 推理服务 16 核 32G 配 A800 200G,向量集群与数据库按数据规模配置,企业可以按阶段投入,先跑通一个场景再横向复制。
结语:私有化是手段,可控才是目的
企业为私有化付费,本质上是在为“可解释、可审计、可退出”付费。模型能力会持续进步,供应商也可能更换,数据边界一旦失守却很难挽回。评估方案时,把组件清单、断网测试、日志留痕、模型切换这四件事验证清楚,比对比参数表更有意义。
FAQ:私有化 AI 智能体选型高频问题
Q1:私有化部署一定要自建机房吗?
不一定。本地数据中心、企业私有云、专有云都能承载,判断标准是资源独占与数据不出内网。已有虚拟化平台的企业通常可以复用现有算力,只按推理需求补充 GPU。
Q2:私有化部署的成本一定高于调用公网 API 吗?
短期看前期投入更高,长期取决于调用量。小规模验证阶段按 token 计费更划算;当日均调用量稳定在高位、且涉及长文档处理时,专属算力的单位成本会反超。建议按三年周期测算算力折旧、运维人力与 API 费用。
Q3:私有化之后模型能力会不会落后?
取决于架构是否支持多模型热切换。支持切换的方案可以在新模型发布后评估、灰度、上线;针对企业语料做微调后,在专业场景上的表现往往优于通用模型。
Q4:怎么判断厂商的私有化是真私有化?
三个动作:断网跑一遍完整业务流程;索要组件部署清单并核对是否有外部接口调用;观察运行期间的内网出站流量。
Q5:私有化部署要多久,需要多少服务器?
标准组件部署按周到月计,取决于系统对接数量与知识库规模。最小可用环境包含应用服务、Agent 服务、模型推理与向量集群四类节点,后续按并发与数据量横向扩展。
Q6:私有化环境下还能用 RAG 知识库吗?
可以,这是私有化方案的核心能力。文档解析、语义分块、向量化、索引构建全在本地完成,检索时结合向量与全文做混合召回,需要深层关联时再调用知识图谱推理,答案可溯源到具体知识条目。