
 立即咨询
保单、赔付与渠道问数:保险经营数据如何实现按需查询
保险经营的三类核心数据,保单、赔付、渠道,各自分散在承保系统、理赔系统、渠道管理系统里。想要做到随时取用,技术上可以用一套语义层把分散数据统一成可查询的数据地图,再以 NL2SQL 把自然语言转成只读查询,保险经营的指标就能从排期报表走向实时问数。本文重点拆解这套问数能力背后的技术实现。
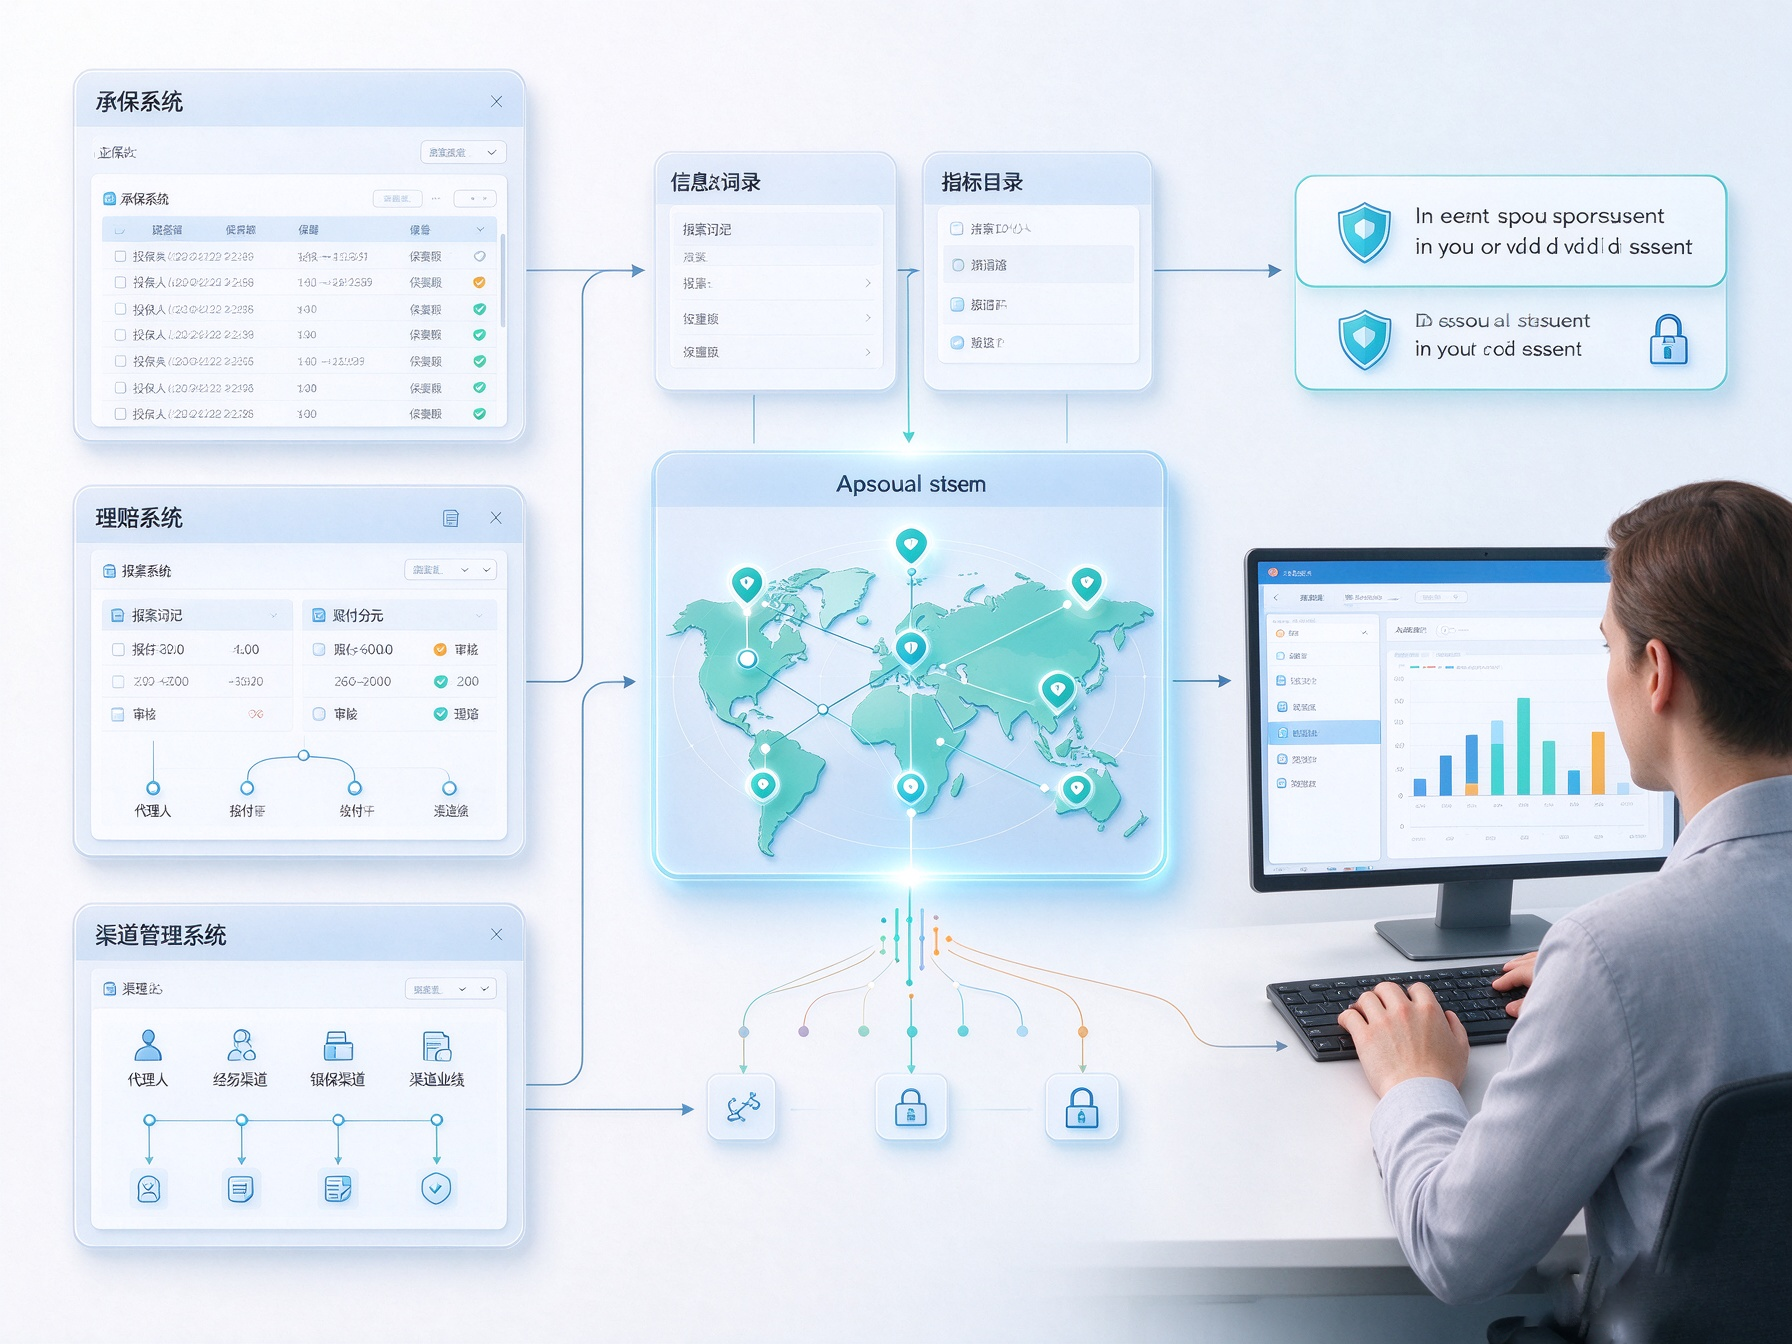
语义层如何统一口径
数据地图的本质是一层语义层(semantic layer),它把底层物理表和业务含义解耦。具体落地分三步。
第一步建指标定义。赔付率统一注册成一个带公式和口径版本的元数据对象,分子取已决赔付支出,分母取保费收入,版本号记录口径变更时间。所有问数和图表都引用这同一个定义,有助于减少两版数字对不上的问题。
第二步建同义词词典。口语和字段值之间需要映射,"重疾"对应险种字段值"重大疾病保险","件数"对应对保单号的计数,"银保"对应渠道编码 02。NL2SQL 做实体对齐时依赖这部词典,否则模型可能将“重疾险”视为无法识别的词。
第三步做维度建模。底层按星型模型组织,保费事实表和赔付事实表围绕险种、机构、渠道、时间四张维度表展开,问数时系统按用户提到的维度可自动生成 JOIN。
从口语到只读 SQL
自然语言问数的技术核心是 text-to-SQL 管线,生产环境里通常拆成七步。
第一位是意图识别。系统先判断用户要的是单点查询、两实体对比、时间序列趋势还是下钻,这一步在很大程度上影响后续生成的结构和图表。
实体与指标抽取紧随其后。从"去年重疾险赔付率"里抽出时间(去年)、险种(重疾险)、指标(赔付率)。这一步常用命名实体识别模型,结合同义词词典把口语归一。
Schema linking 把抽出的项对齐到数据地图。模型要知道"赔付率"指向哪个指标定义、"重疾险"对应哪张维度表哪个值,依赖第二步建好的语义层和词典。
SQL 生成阶段把对齐结果转写成查询语句。工程上一般把数据地图的表结构描述作为上下文注入提示词,再配少量同类型示例做 few-shot,让模型产出更接近目标库的语法。复杂多表 JOIN 是准确率的主要瓶颈,生产里常用执行准确率(execution accuracy)做评测和回归。
SQL 校验是安全校验环节。系统把生成的语句做抽象语法树解析,可限制为只允许 SELECT,拦截 INSERT、UPDATE、DELETE、DROP 等写操作和删表。表名和字段还要过白名单,不在语义层登记的物理表一律拒绝访问。
权限谓词注入在放行前完成。系统按当前用户可见的机构范围,自动给语句加上机构过滤条件,这样用户通常不会超出自己的数据边界。
执行与格式化收尾。查询结果按指标类型做单位换算和四舍五入,再交给图表模块。整条管线里模型只负责"生成",校验和权限由确定性的规则层兜底,这是问数系统上生产的重要基础。
图表自动匹配的工程逻辑
图表通常不是用户额外选的,而是由意图和结果结构推导出来。两实体比同一指标,比如 A 险种和 B 险种比赔付率,出柱状图。单实体跨时间,比如某险种十二个月赔付率,出折线图,拐点通常较为明显。构成类问题,各渠道保费占比,出堆叠图或饼图。
实现上,系统在生成 SQL 的同时产出一份图表配置,标明横坐标维度、纵坐标指标和图表类型,前端按配置直接渲染。赔付率和继续率可以叠在同一张折线图里,经营会上有助于快速发现“保费上行但继续率下行”的反常组合。
小艾智能体的技术支撑
小艾智能体用动态 Agent 编排系统可将数据地图构建、查询生成、图表渲染、报告导出串联为可配置工作流,工作流以 JSON 或 YAML 描述,内置多种节点,支持条件路由、状态传递、并行执行和基于检查点的状态持久化。
它的文档处理引擎可解析保单、理赔、渠道的 PDF、Excel、CSV 等文件,做语义切分后用 BGE-M3 模型向量化存入 Milvus 并可自动建索引。知识图谱系统基于原生图数据库做实体识别和关系抽取,支持关联查询与路径推理,下钻时可自动补全险种、渠道、机构之间的路径。向量检索引擎结合 Milvus 与全文检索引擎做混合检索,为问答提供知识片段,有助于减少模型幻觉。
小艾智能体的智能问数报表系统以 NL2SQL 为核心,把自然语言转成只读 SQL 再自动出图表,与本文的保险问数场景直接对应。系统支持私有化部署,保单与投保人数据可在本地处理,字段白名单控制敏感信息。对保险企业来说,经营指标可减少等待报表排期,支持按需查询、按需出数。