
 立即咨询
Schema Linking:NL2SQL 怎么知道数据对应哪张表
Schema Linking 是 NL2SQL 里把用户口语对准数据库真实表字段的环节。它先把"销售额""上月""各区域"这类业务词,映射到 sale_order 表的 amount、order_date、region 字段,模型才能写出跑得对的 SQL。判断一套 NL2SQL 靠不靠谱,可以重点看它怎么做 linking。
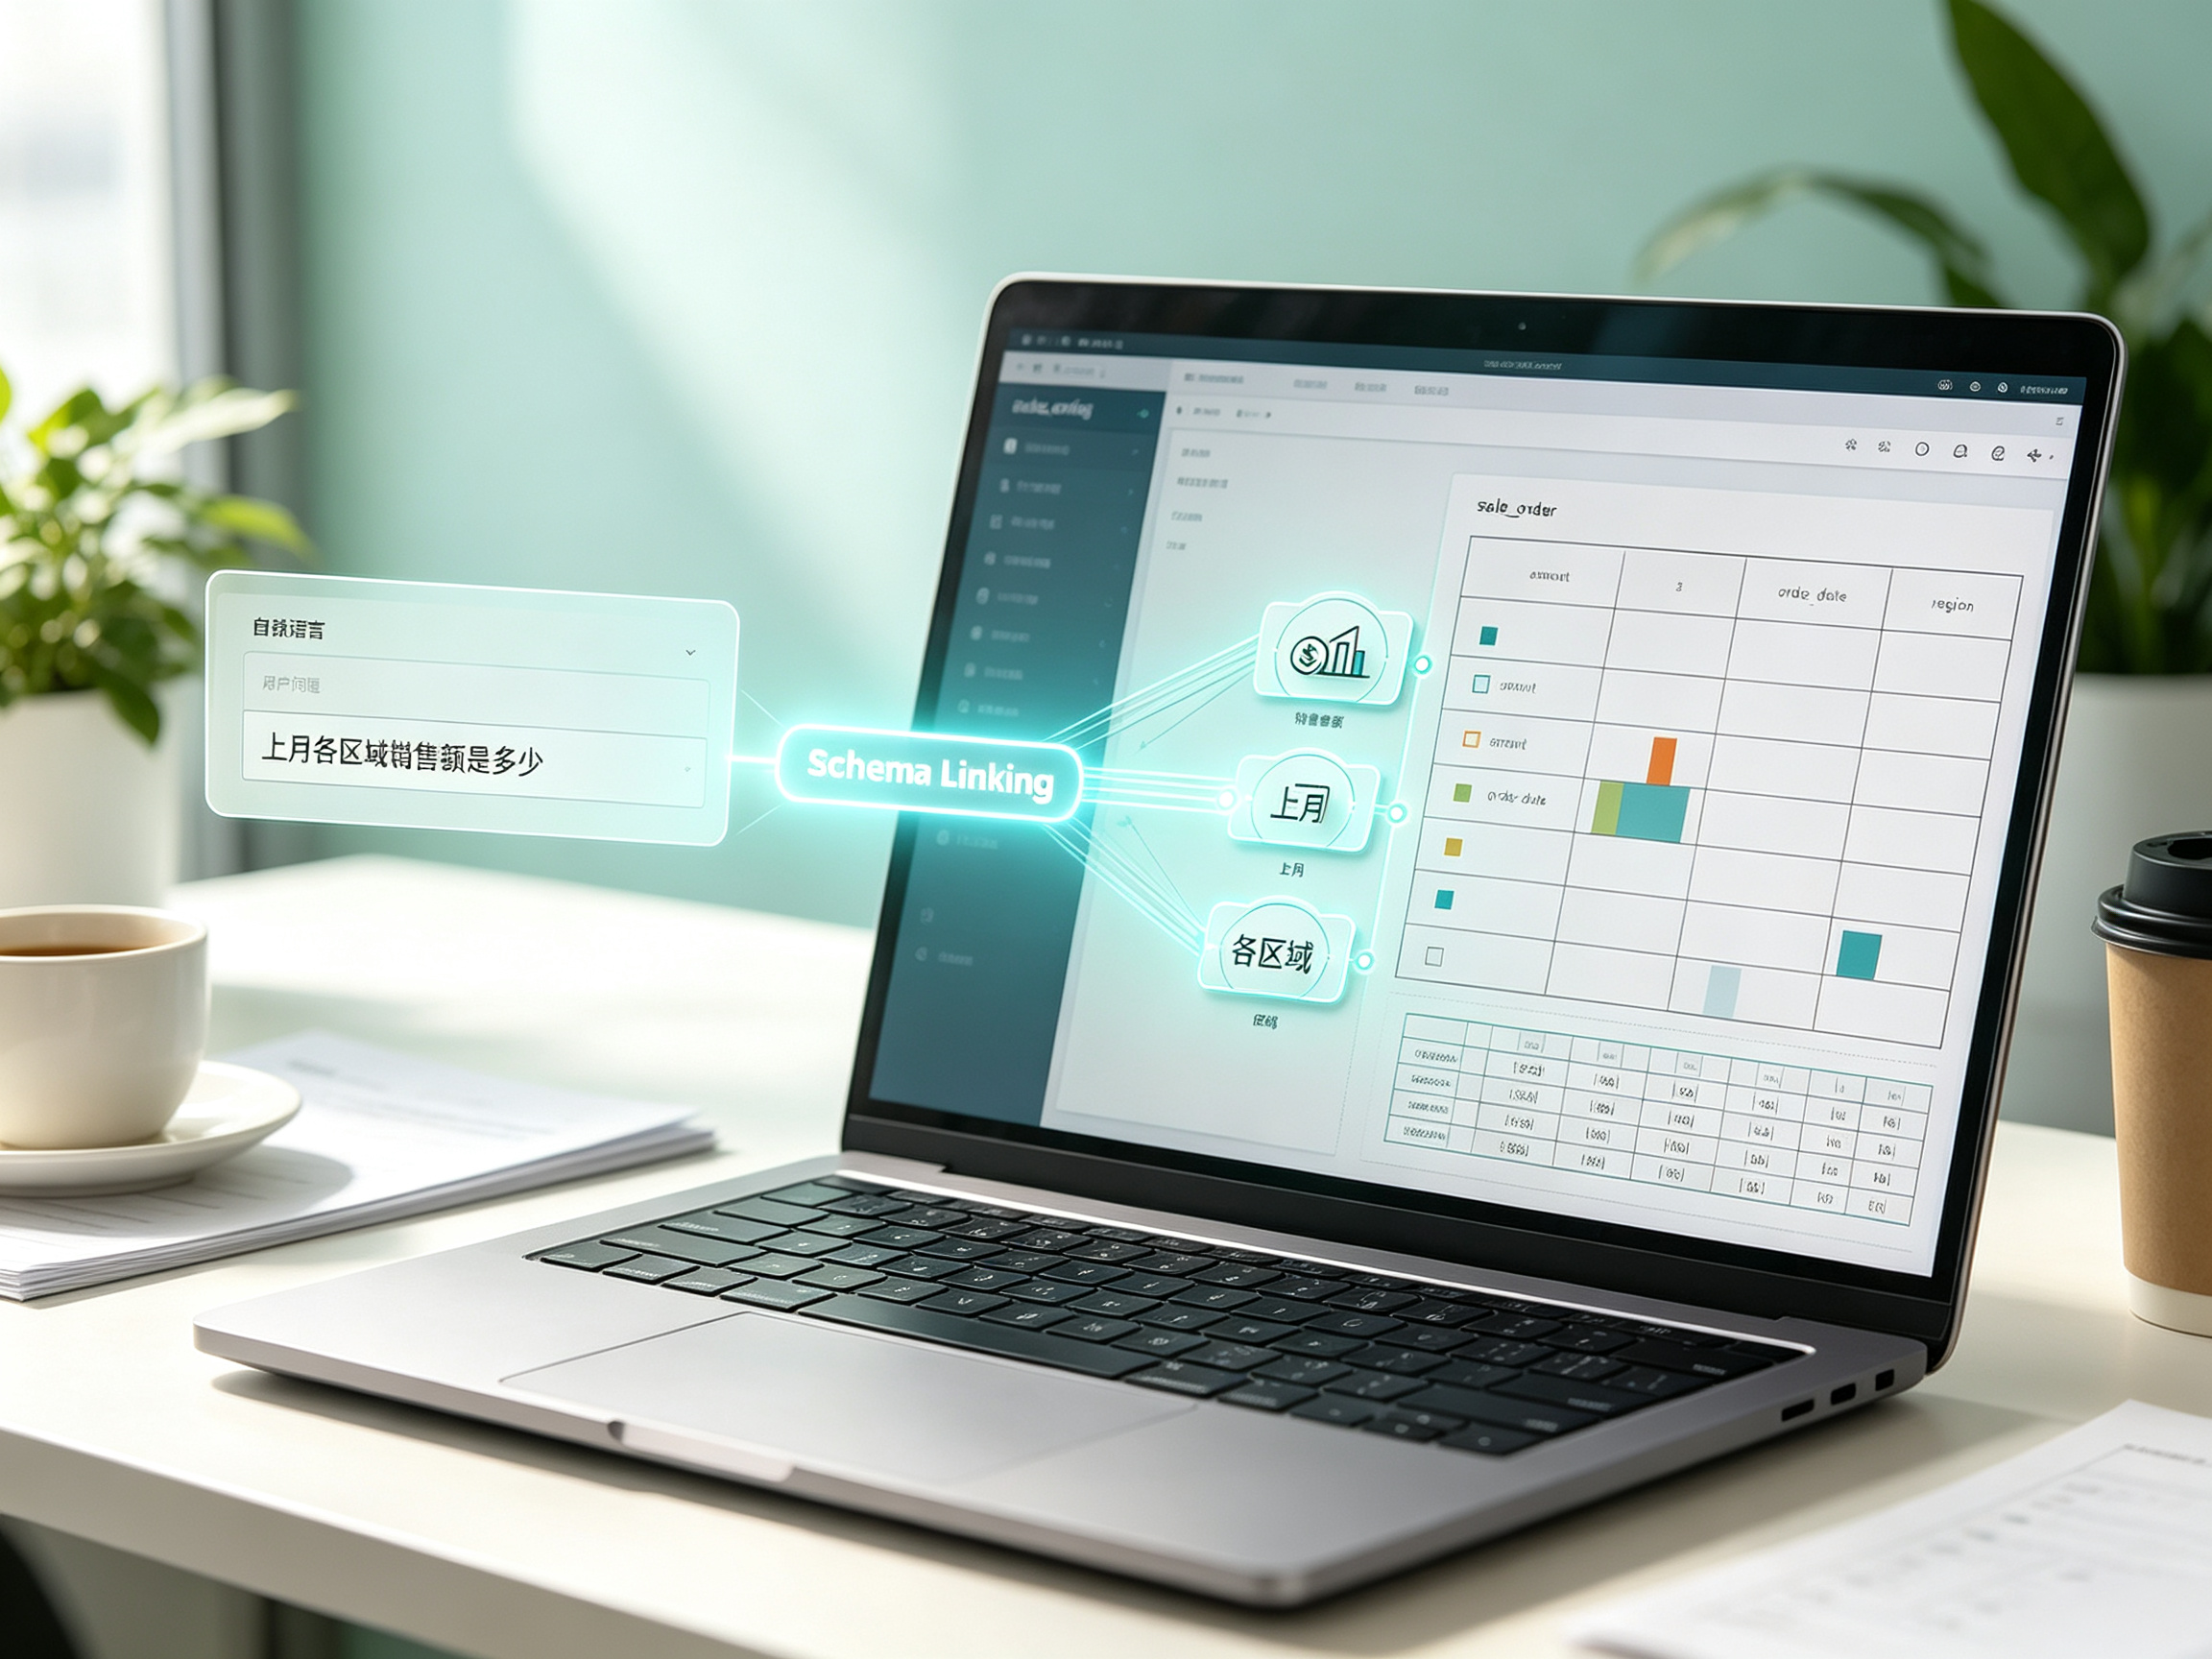
Schema Linking 是什么
Schema Linking 把自然语言里的业务词,准确映射到数据库真实的表名、字段名、字段注释上。用户嘴上说"上个月的销售额",数据库里没有叫"销售额"的字段,只有 sale_order.amount 和 sale_order.order_date。Linking 要建立的,就是"业务词到真实列"的对应关系。
大模型本身不懂你的库。它只见过训练语料里通用的建表方式,不知道你这张表叫什么、哪个字段存实付金额。不给它真实结构,它只能编一个看着合理的字段名,SQL 在真实库上直接报错或返回空。
这一环节的输入有四类:表名、字段名、字段注释、主外键与样例值。输出是被选中的表与字段集合,外加一句映射理由,供后续生成模块消费。凡是涉及"用中文问、拿数据答"的系统通常都需要经过这一环节,BI 自助取数、报表自动生成、数据问答助手、运营实时看板都算。
原理拆解:先读库结构,再对位业务词
Linking 分两步走,先理解库表结构,再把业务词对位到具体字段。第一步是读 schema。模型加载库里所有表的 DDL、字段注释、数据类型、主外键关系。region 字段的注释若是"收货地区",模型读到就能把它和"区域"连起来;amount 的注释若是"实付金额",模型才链到销售额,标价存在 list_price 这一列,二者不同。
第二步是对齐。销售额会落到 amount 这个数值字段,因为它的注释写的是金额。上月指向 order_date,还要补一段时间过滤(BETWEEN 上月首日 AND 上月末)。各区域则对应 GROUP BY region 分组。
业务词到字段的对应,由注释语义和字段类型共同约束,字段名形似只是辅助线索。库表多的时候,工程上常用向量召回缩小候选。把每个字段的"名称加注释"做成一段文本,embedding 后存起来;用户问题也 embedding,算相似度取靠前的 top-k 个字段交 LLM 精排确认。这种做法通常比让 LLM 直接扫描全库更为稳定,库表数量较多时差异较为明显。跨 ERP、CRM、WMS 多套系统的统一取数,指标平台里的口径对齐,通常需要这层先把字段认准。
工程意义
Linking 一旦指错字段,SQL 再工整也返回错误数据,而且错误藏得深,复核时不易发现。把销售额错链到 list_price(标价)这一列,实付金额在 amount,二者混淆会让结果整体偏高;把上月错链到 create_date(下单日),支付日在 pay_date,统计口径整个变了,两张报表对不上。
字段注释的质量在很大程度上影响 linking 的质量。注释只写"金额",模型分不清是实付还是标价;注释写成"实付金额,已减去优惠与退款",模型才链得准。Schema 设计阶段把注释写清楚,是提升准确率里较为有效的一步。
公开评测显示,linking 准确率下降可能导致最终 SQL 执行准确率更大幅度地下降。财务对账、经营分析、监管报送这类场景,错一个字段可能造成严重后果,linking 尤为重要。
小艾智能体里的实践
小艾智能体的元数据管理可自动抽取库表字段与注释,构建数据地图,NL2SQL 翻译前先做 linking,再生成只读 SQL。系统连上数据库后可自动读取 DDL 与注释,生成一张可检索的数据地图;用户提问时先在这一层完成 linking,确认涉及的表与字段,再交给翻译模块出 SQL。生成的 SQL 默认只读(SELECT),有助于避免误写误删。业务人员通常无需背表名即可取数,模型通常不会凭空造字段,取数结果可支持溯源到具体列。
NL2SQL 准不准,一半在 linking,一半在翻译。先做对映射,再谈生成,取数才更可靠住。