
 立即咨询
工时数据反哺排产:用真实工时校准标准工时与人效
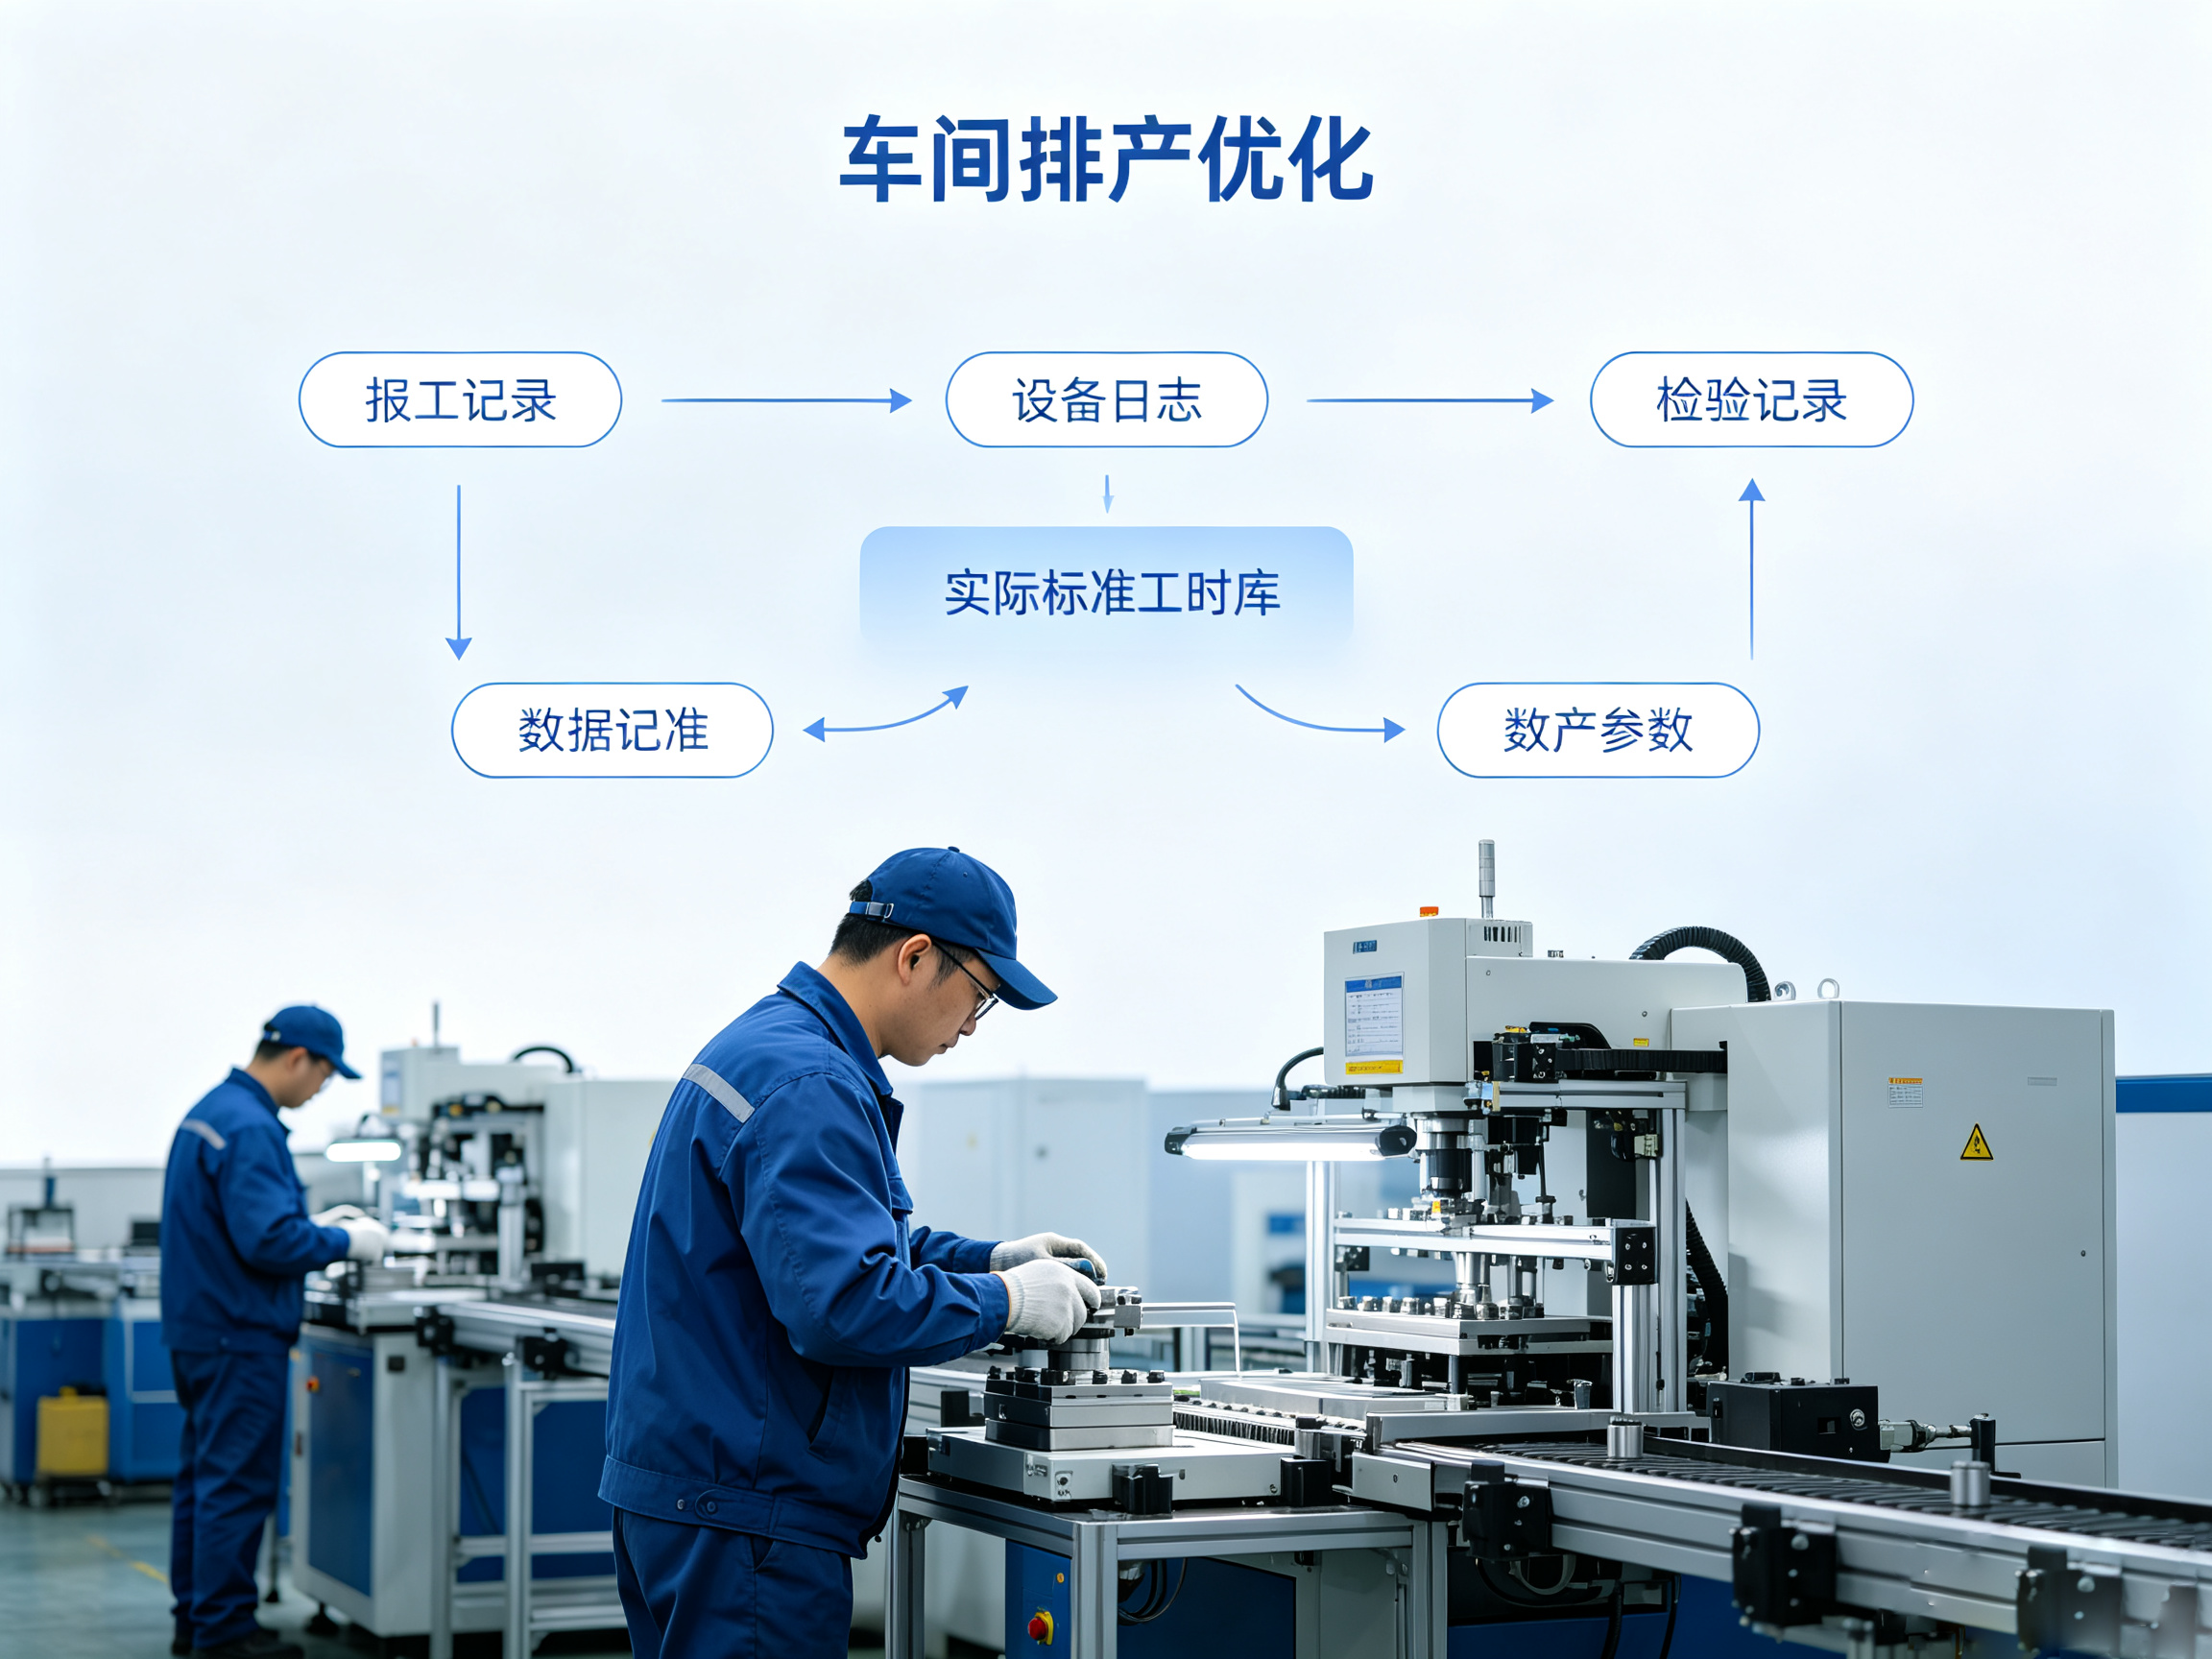
标准工时的可靠性与它被修正的次数密切相关,测定环节做得再细也需持续校准以维持长期准确。车间每天产生的报工记录、设备日志和检验记录是修正标准工时的重要原料,这些数据的常规去向是工资核算与成本核算,流回排产参数的很少。
标准工时从哪来,又是怎么过期的
大规模批量生产刚成型的年代,一件活该干多久没有准确的数字。后来有人把动作拆到最小单元,拿秒表逐段测时,经验被写成了工艺卡上的数字。再往后,研究者把伸手、握取、移动、对准这类基本动作预先测定成标准时间表,按动作序列累加就能算出工时,这条路后来叫预定动作时间标准。标准工时的算式在此基础上形成:
标准工时 = 观测时间 × 评比系数 × (1 + 宽放率)(仅示例)
评比系数把具体工人的快慢折算回标准速度,宽放率留给生理需要、疲劳和设备调整。
它们产生于一个特定时刻、一批特定工人和一种特定批量。一年后人员换过一轮,刀具夹具的状态不同,批量从 50 件降到 8 件,算式里的数字可能仍维持原值。
根据学习曲线理论(Wright, 1936),累计产量每翻一倍,单件工时按固定比例下降。学习率取 90%,第 200 件的工时就是第 100 件的 90%。新员工的实际工时高于标准工时,可能只是他还在曲线陡峭的那一段,判断异常要看工时的下降速度,单点数值说明不了问题。
排产这边更直接。物料需求计划(MRP)从成品交期倒推开工时间,靠的是提前期,提前期里的加工时间取自标准工时,整套逻辑假设产能无限。产品单一、批量稳定的年代这个假设问题不大,多品种小批量订单占比上来之后,标准工时的偏差会传导至提前期,进而影响开工日期的准确性,增加排产执行难度。后来的闭环 MRP 增加了能力需求计划这一层,再往后出现的有限产能排程算法,输入依然是工时。参数偏差会影响排产算法的输出精度。
人效差异同样记在数据里。同一道工序,两个班组的实际工时可能差出很多。
方案落地
关系型数据库靠外键把表连起来,跳数少的时候很好用。回答"这道工序上超工时的工单,执行人的技能等级是不是偏低",要跨工单、工序、人员、技能四张表,多跳关联的代价随跳数上升得很快,跨系统时实现难度较大。属性图模型允许在节点和边上挂属性,正好承接工业场景里那些带数值的关系,比如"某人在这道工序上报工 3 次,平均 1.55 小时"。用 Cypher(Neo4j图数据库查询语言)写一条多跳路径,一次查询就能回答上面的问题。
Agent 工作流把这些查询固化成定期执行的流程:从 MES 拉报工记录,与标准工时逐条比对,按工序、班组、班次、技能等级分层,生成偏差报告推给工艺和班组长。工作流引擎带的 checkpointer 支持断点续跑。
偏差要分类。某道工序上所有人都超,说明工艺给的工时本身偏紧,该改的是标准。只有一部分人超,且他们的技能等级集中在低档,那是培训缺口。判断规则可以先设置几条阈值,再让模型读历史数据补齐剩下的。
修正值经工艺人员确认后写入知识库,成为新基准,同时保留版本记录,某次调整的理由随时可回看。这是典型的反馈校正,工程上的难点之一在于收敛:修正频率高,参数会跟着噪声抖;频率低,又跟不上产线变化。常见做法是给偏差设死区。
排产和人效各自拿到了什么
以某工序为例,在特定条件下标准工时 1.2 小时,实际平均 1.55 小时,偏差 29%。按 8 小时班次,排产给出的计划是 6.7 件,实际只能出 5.2 件,一天差 1.5 件,一个月 22 天差 33 件。交期延误就是这么来的,看起来是计划没执行好,实际是参数从一开始就不对。不过在校准之后,同一条产线的排产可用率有望提升,而且有助于解释生产未按计划完成的原因。
人效这块的变化更实在。偏差被拆到人和工序两层之后,有助于识别哪个班组在哪道工序上慢,慢的人技能等级如何分布,可获得相应依据。培训排给谁、排什么内容也可随之明确。
工时数据连着薪资、技能等级和个人绩效,属于个人信息,处理不当会牵出合规问题。把报工记录、人员档案和工艺参数留在企业内网,向量与图数据同样本地存储,是这套方案能落下去的前提。小艾智能体可支持私有化部署,工时与人效数据在企业侧完成处理,可在本地网络中完成,与 MES 及人事系统的对接可通过 REST API 节点实现。