
 立即咨询
智能体辅助工时采集与合规监控
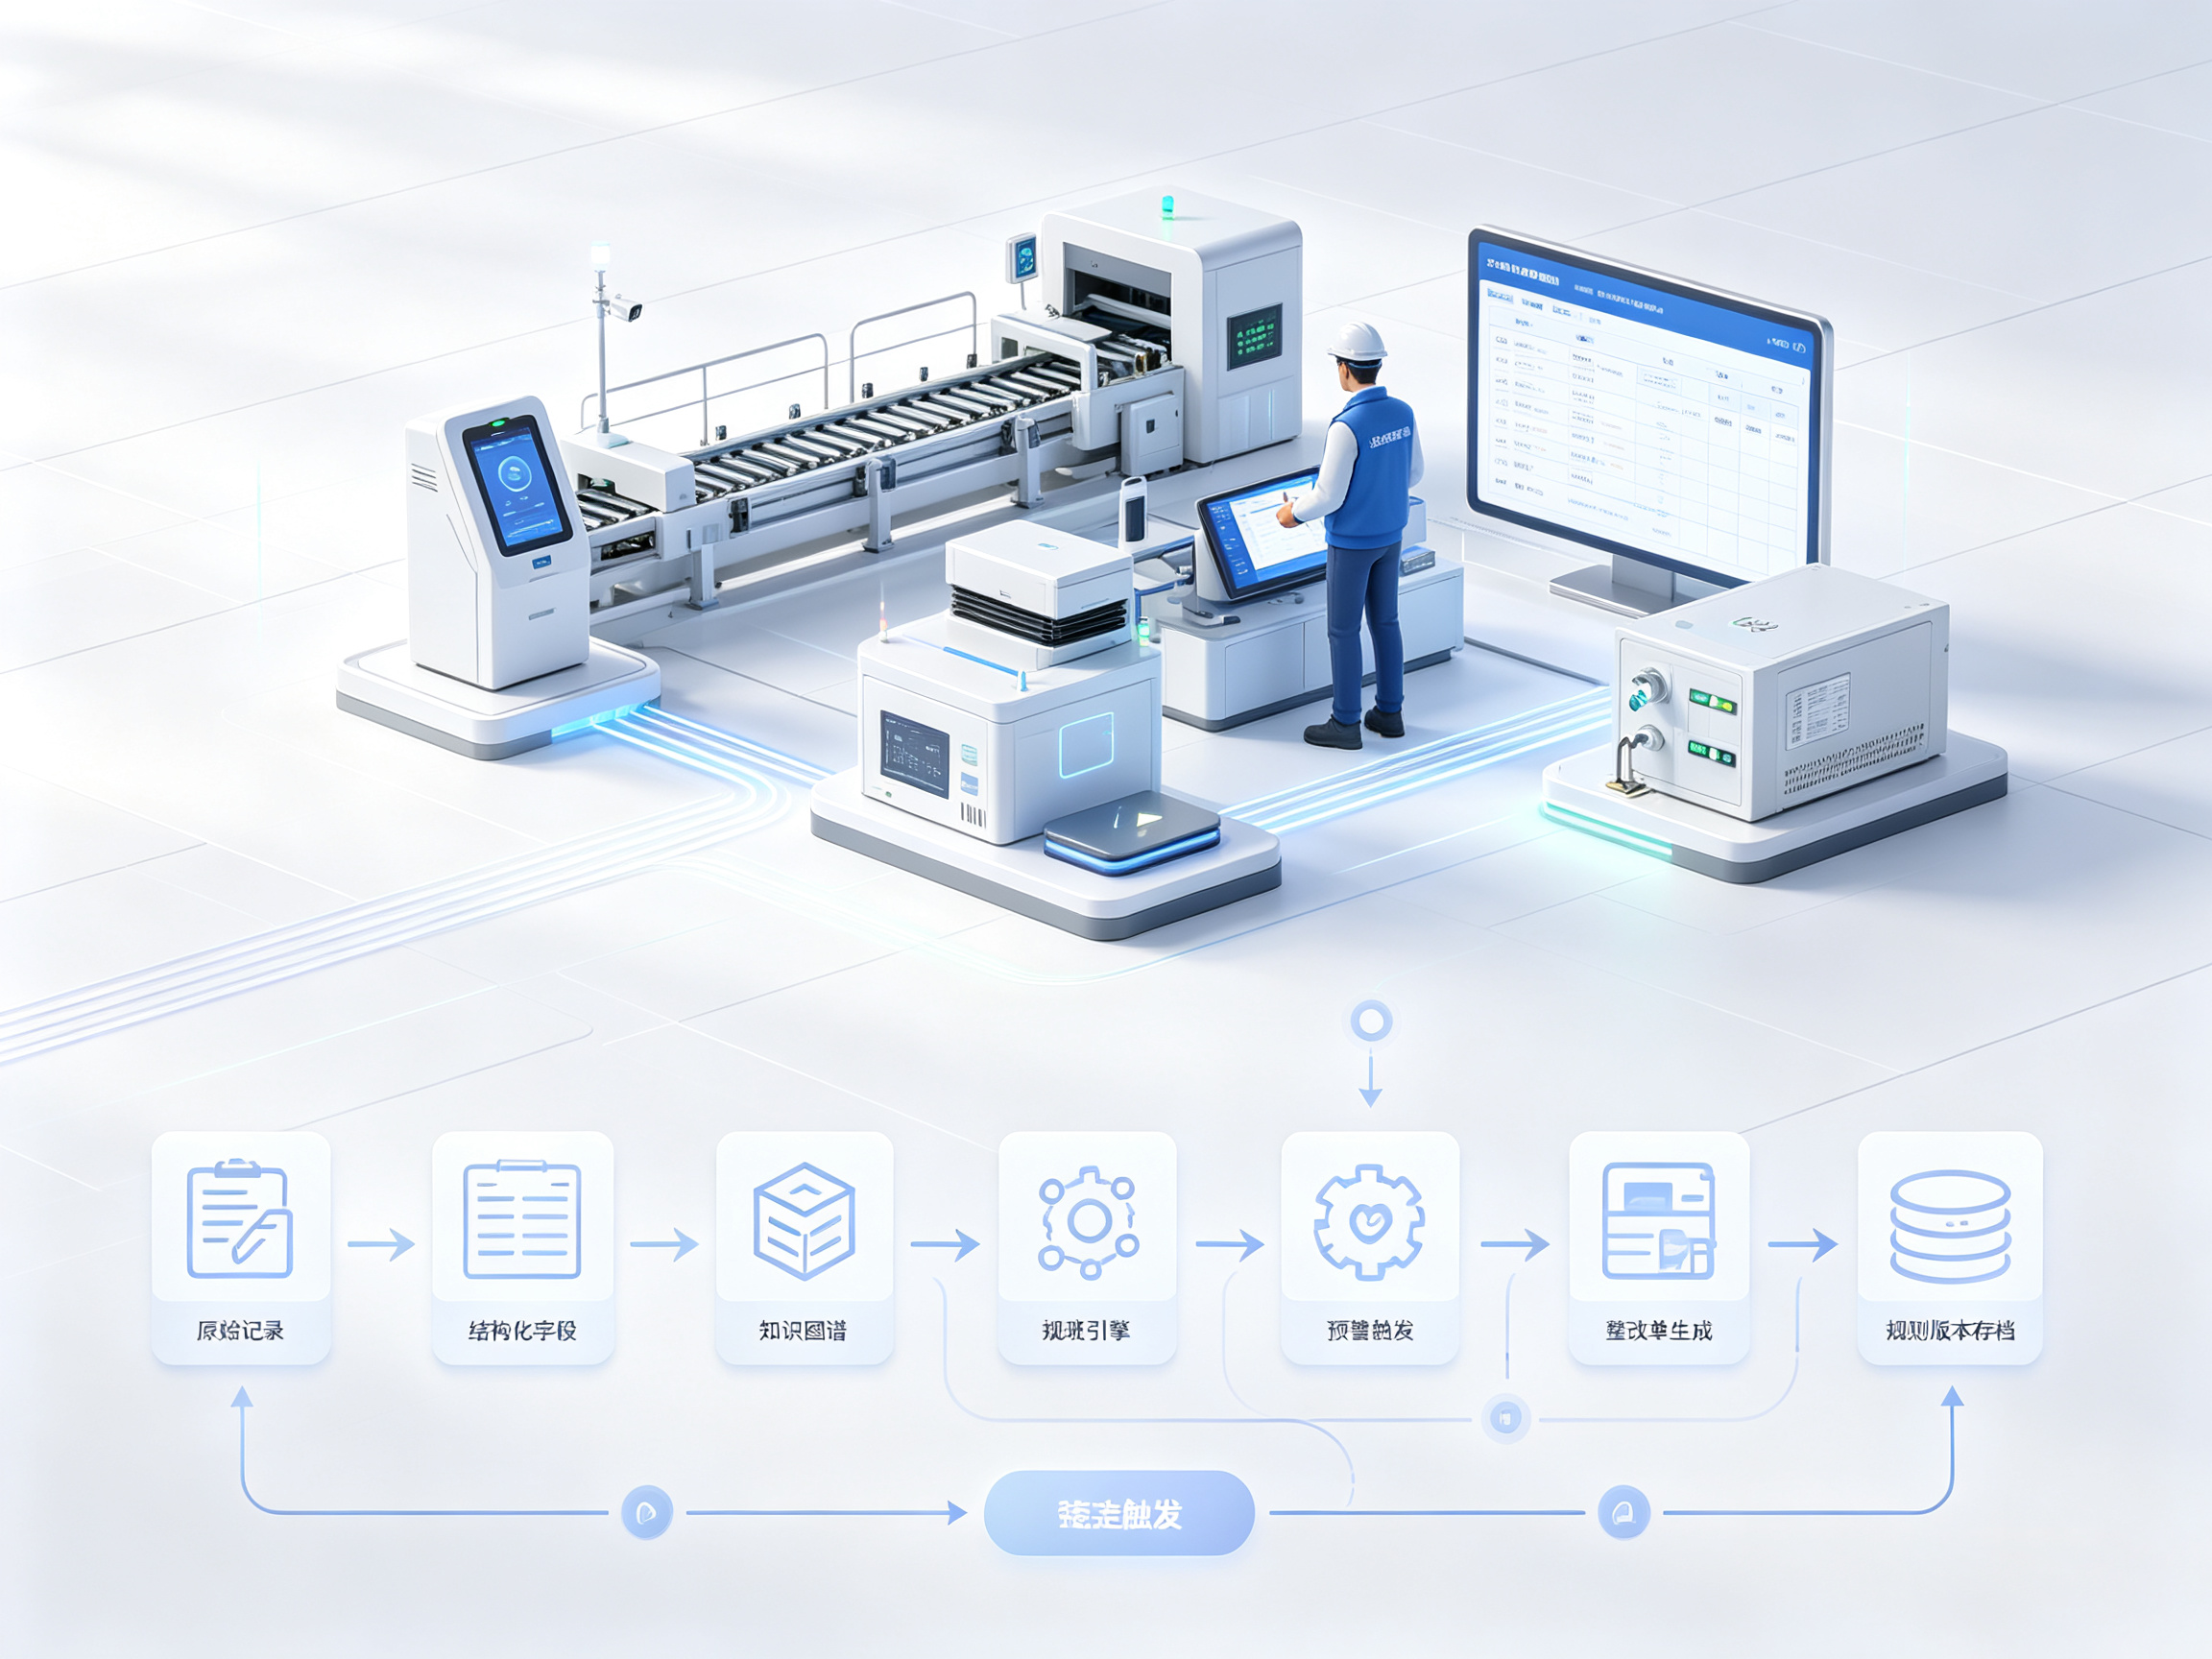
制造业工时合规的主要风险包括采集口径不统一、法规条款停留在自然语言、判定发生在事后。一种解法是将采集、结构化、规则判定、留痕这四件事整合进一条自动化链路:文档与设备侧的原始记录先被解析成结构化字段,知识图谱把人员、班组、班次、工时与法规条款连成可遍历的关系网,规则引擎把条款翻译成可比对的条件,Agent 工作流可在排班落库时进行扫描,命中阈值后可触发预警并生成整改单,全过程日志与规则版本可统一落库。
工时数据
工厂最早用的考勤工具是一台落地式打卡钟。工人把纸卡插进去,机器在卡上打印时间戳,月末由考勤员对着格子数小时数。那时人和时间在纸上对应。电子化之后纸卡消失,时间戳进了数据库,采集入口也随之增多。
门禁闸机留下一份通行记录,车间 MES 留下一份上工记录。加班审批单记的是申请时间,移动考勤记的是定位签到,工资系统另按自己的口径算一遍计薪时长。同一个人的同一天,可能对应多条不同来源的记录。
采集工具每升级一代会新增一套数据源。指纹机用于解决代打卡,人脸识别接着解决指纹磨损,两次升级各自在旧系统旁边新增一套数据源。碎片化带来的一个工程后果是口径打架:出勤工时按打卡算,在岗工时按产线工位算,计薪工时按财务规则算,三个数字同属一天却互不相等。合规判定必须选定其中一条作为基准,并留存换算关系。
采集链路
碎片数据要进入规则,得先过一道结构化处理。这条链路上的每一项技术都对应一个具体的采集难题。
多格式解析。考勤表与排班表在多数工厂仍以 Excel 和 PDF 流转,纸质签到表与外协人员的打卡截图则以图片形式存在。文档处理引擎可按文件类型分发解析器,PDF 走文本层抽取,无文本层的扫描件转由 OCR 处理,Excel 按表头映射列字段,图片走版面识别。识别结果可输出为文本片段,供后续环节使用。
字段抽取。非结构化文本里的"2026年8月夜班 20:00-08:00"这类表述无法直接参与计算,需要数据抽取节点把它拆成工号、班次类型、开始时间、结束时间四个字段。这一步由大语言模型配合结构化输出约束完成,抽取结果与原文片段一并保存,便于事后核对。
跨零点班次的归属。夜班从当日 20:00 跨到次日 08:00,按自然日切分会把一段班次算进两天,日延长工时的判定随之失真。工程上的通用做法是在班次记录上单独设一个归属日字段,全月累计与日判定都以归属日为准,自然日只用于展示。
设备时钟与异常数据。闸机与移动端的时钟漂移会让同一批人集体偏早或偏晚几秒,靠 NTP 校准加容差窗口吸收。忘打卡与重复打卡属于必然出现的脏数据,系统按"补卡申请—主管确认—留痕"的方式处理,修正动作本身也进入记录,原始值不被覆盖。
异步与缓存。月末与月初是采集峰值,上万条记录同时入湖会拖垮同步接口,消息队列(RabbitMQ)负责削峰,采集任务排队消费,失败自动重试。人员档案、班组排班这类高频热点数据放进 Redis,规则判定时不必每次回查主库。
语义检索与向量库。历史处置案例、内部工时制度、地方裁审口径这些材料是规则之外的补充依据,经 BGE-M3 (北京智源研究院发布)转成向量存入 Milvus,配合 Elasticsearch 做关键词检索,两路结果融合后供大模型参考。
规则可以计算,前提是先把条款拆成字段
工时条款本身具备可直接计算的结构。根据《中华人民共和国劳动法》第三十六条、第四十一条、第三十八条,每日工作时间不超过八小时、平均每周不超过四十四小时;延长工作时间一般每日不超过一小时,特殊原因下每日不超过三小时,每月不超过三十六小时;用人单位应当保证劳动者每周至少休息一日。这三组数字里,三十六小时是月度累计量,它跨班次、跨周、跨审批单,人工逐行核对难度较大。夜班频次与相邻班次间隔同理,判断依据不在单次打卡记录,而在两个班次之间的时间差。
把条款变成可执行逻辑,靠的是规则引擎。IF 条件 THEN 结论+ Rete 这类匹配算法在大量事实中找出被激活的规则。后来这套机制从研究项目下沉进业务系统,成为今天的风控引擎,核心结构没有变。
条款原文是自然语言,"因特殊原因""保障劳动者身体健康"这类表述需要先翻译成字段,包括工号、班次起止、班次间隔、月度累计加班时长、岗位类别、人员状态(是否孕期、是否未成年工)。翻译完成后,"每月加班不超过三十六小时"才成为一个可比较的数值条件,规则引擎只负责比对。项目里一种常见情形是跳过翻译直接写判断,规则能跑,但告警可能缺乏足够的解释依据。
合规还有一层容易被忽略的要求:规则要有版本。法规修订、地方口径调整、企业制度更新都会改变阈值,判定结果必须绑定当时的规则版本,否则两年前的判定在今年无法解释。
关系补齐之后,规则才算得到具体的人
规则比对的输入是数值,数值的来源是一条关系链。要算某人当月累计加班,系统得知道这个人属于哪个班组,班组的排班表里哪些班次算延长,哪些延长走过审批,审批单对应哪几个日期。这条链在关系型数据库里需要多表 JOIN 拼接,联表层级较多时,查询复杂度较高。
知识图谱走的另一条路。节点和边都允许携带属性,存储层用指针直接指向邻接节点,遍历一个节点的邻居时不需要走索引。Neo4j 是这种模型的代表实现,Cypher 是它的查询语言。
建图过程依赖两项抽取能力。实体识别从文档中定位人名、班组、产线、设备、条款编号;关系抽取识别它们之间的语义关联,例如"隶属班组""排定于班次""适用条款""审批通过"。抽取结果写入图库后,一次查询可以顺着"人员—班组—排班—班次—工时记录—适用条款"这条路径走到底。
能力要落在同一套系统里
小艾文档处理引擎可支持 PDF、Word、Excel、图片等多格式的解析与语义切分,数据抽取节点可将非结构化文本转为结构化工时字段;Neo4j 可承载人员、班组、班次、工时与法规条款的图谱关系,Cypher 可用于复杂关联查询;规则引擎与条件节点(If Node)可将条款翻译为可比对的条件并驱动分支;工作流引擎基于 LangGraph 实现,提供多种预置节点、条件路由、并行执行与基于 Checkpointer 的状态持久化,扫描任务可按天调度、中断后续跑;Elasticsearch 与 Milvus 可分别用于关键词检索与语义检索,历史处置案例与制度文件可以被相似案例检索复用。执行日志、规则版本、判定输入可统一落库,便于形成可回溯的证据链。