
 立即咨询
你的 RAG 回答不够准确?混合检索 + 图谱推理的工程实践探讨
RAG 系统出现的幻觉,相当一部分源自召回环节,另一部分来自推理环节。向量检索在语义层面找相似,判断哪一条才是正确答案属于排序与图谱环节的职责;大模型擅长语言组织,跨文档的事实链条需要外部替它补全。工程上可考虑的解法分三步走:向量检索与全文检索混合召回,有助于提升候选集的 Recall@K;知识图谱以实体关系帮助补齐跨文档的逻辑链条;大模型尽量在可验证的材料上作答,并逐句返回出处。验收时可重点考察忠实度(faithfulness)这一项,答案里的每条陈述都要能在给定上下文中找到依据。RAG 的可靠性由检索链路的设计决定。
基础 RAG 为什么会出现事实性错误
检索增强生成的思路很朴素,模型未掌握的事,先去资料里翻,翻到了再照着答。
相似度阈值放松一些,返回一堆沾边的段落,模型从中挑一段拼出答案,读起来通顺,事实是错的。阈值收紧,返回空集,模型退回自己的参数记忆,开始编。这是召回层的失效。
还有一种情况,召回的片段每句都对,但问题需要把三份文档的信息串起来才答得完整。模型手里只有三个孤立片段,难以识别 A 文档里的“李某”和 B 文档里的“李经理”是同一实体,也难以判断 C 文档的停线属于哪个项目。缺乏图谱关联时,推理容易产生偏差。这是推理层的失效。
向量检索
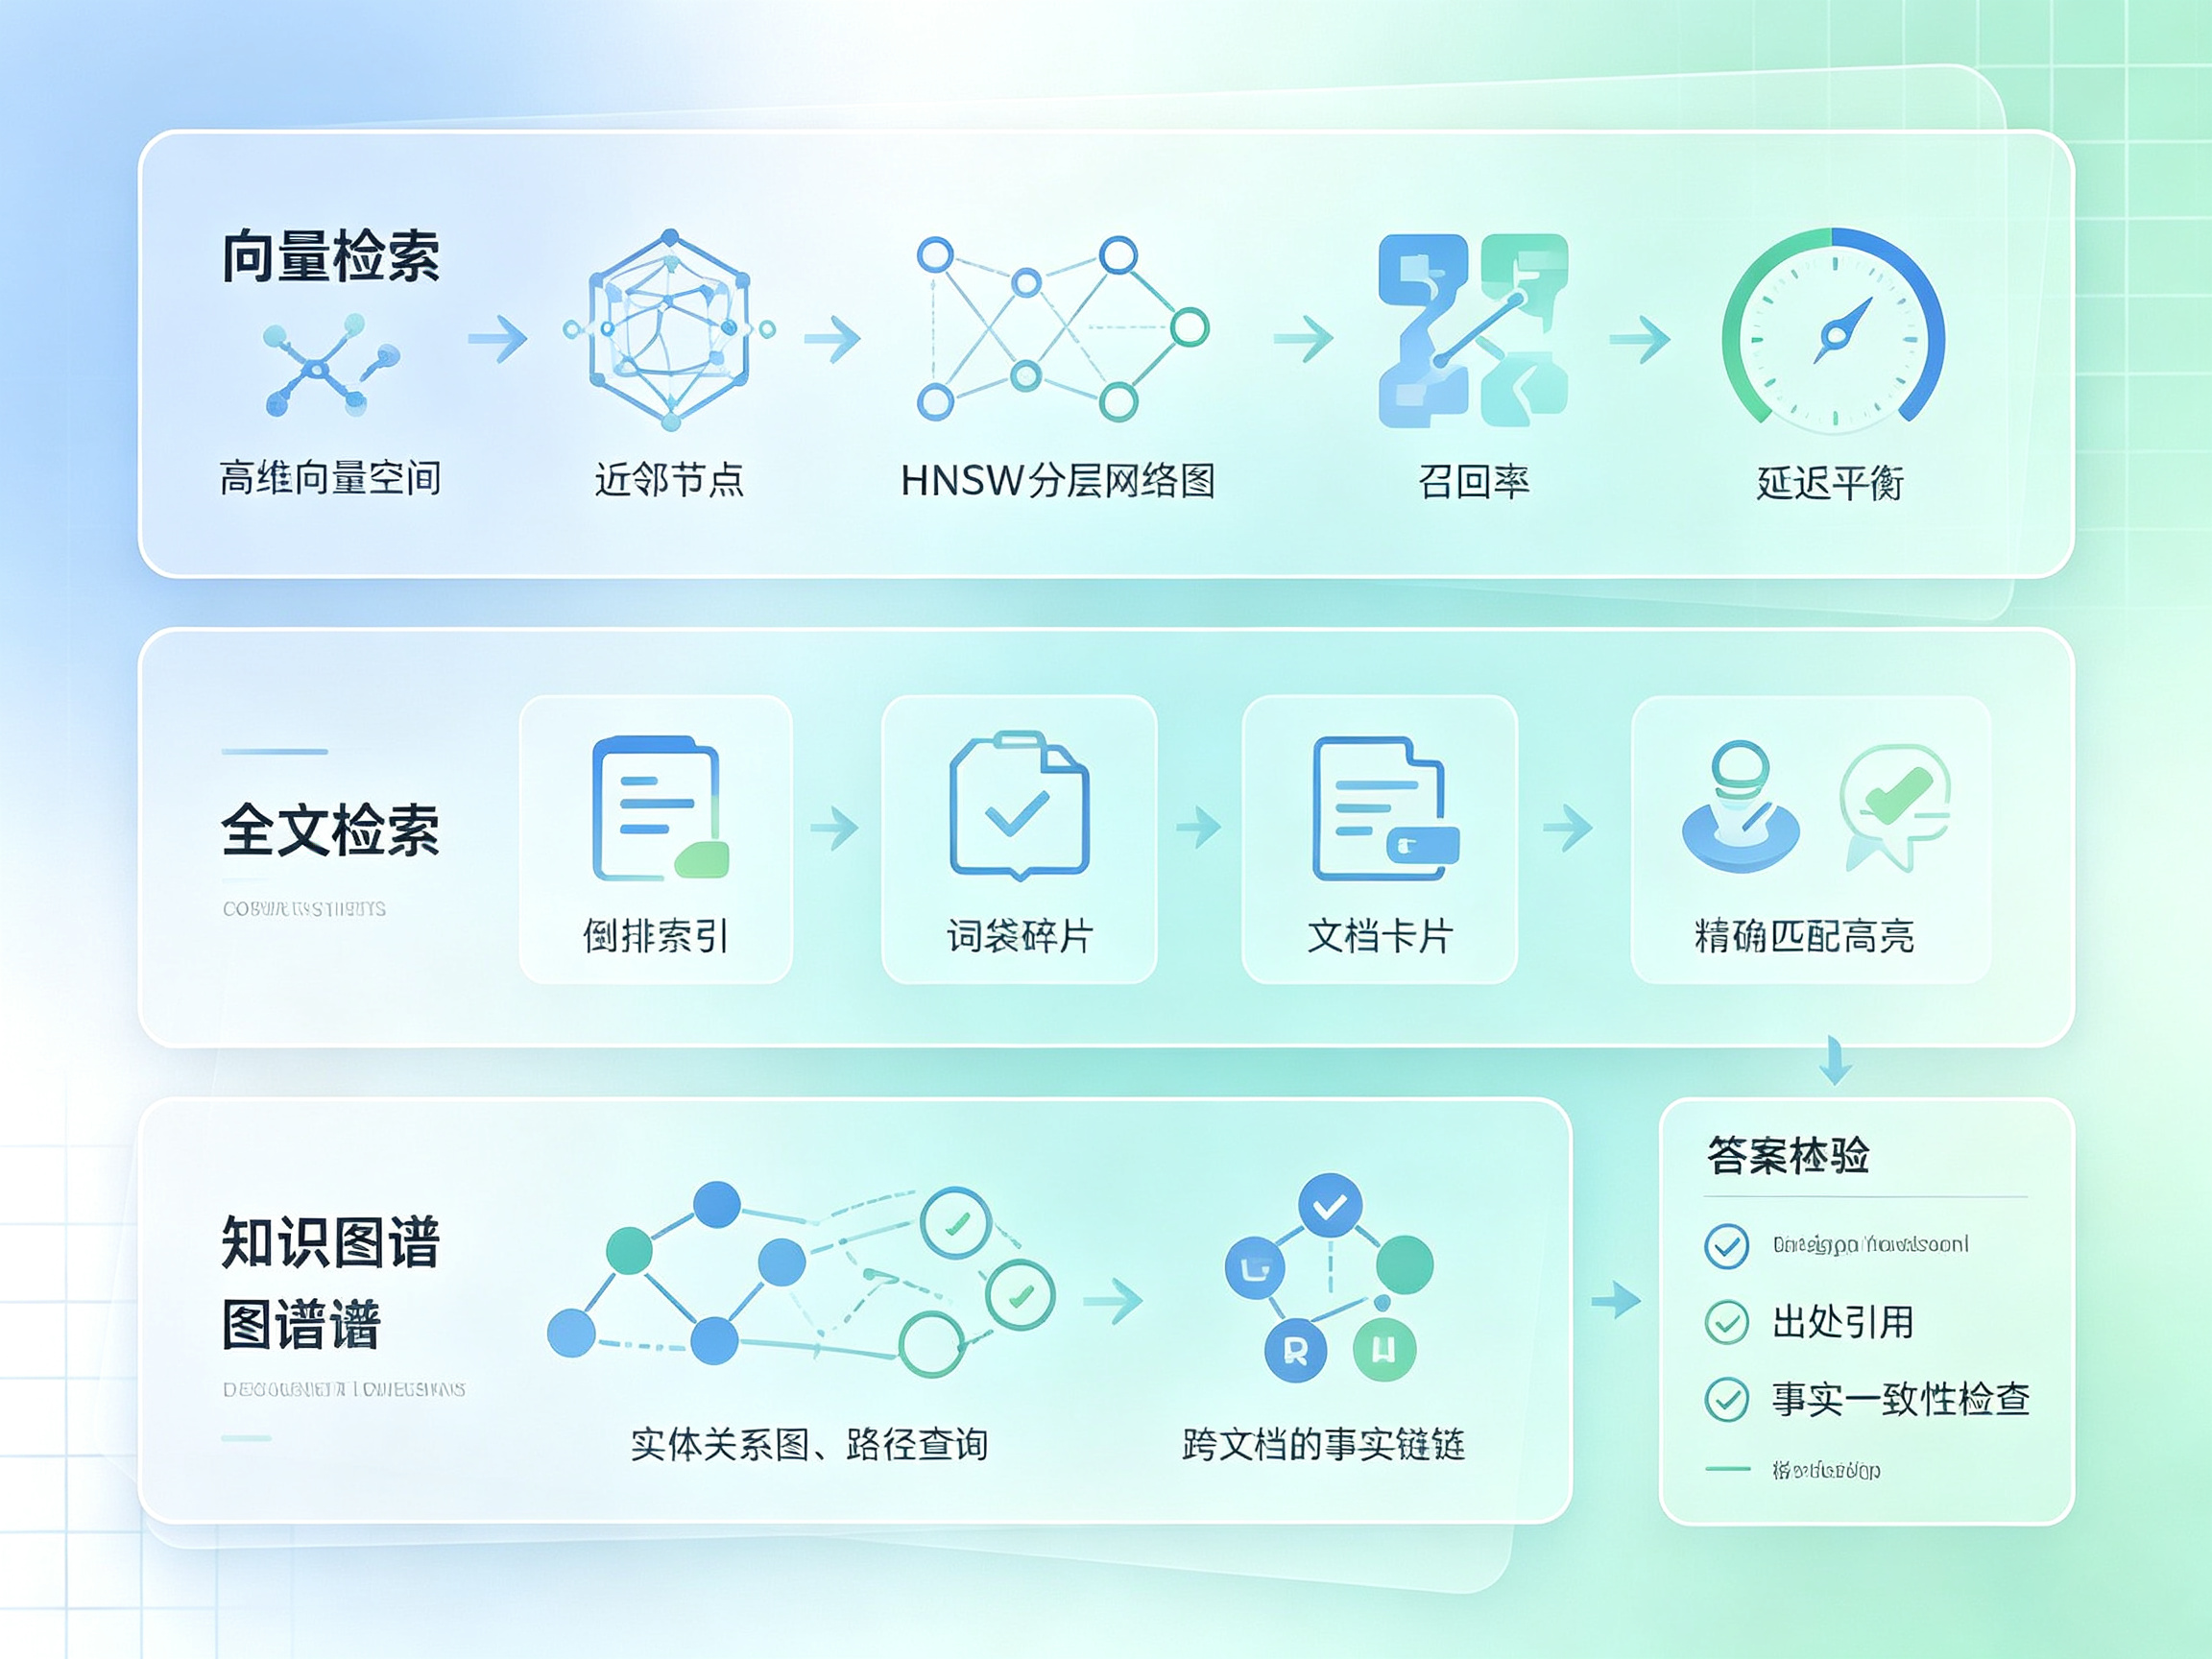
Milvus 这类向量数据库提供的 HNSW 用分层的小世界图可将查询复杂度控制在对数级附近,代价是构建参数 M 与 efConstruction 调大之后索引体积和构建耗时同步上升,查询阶段再靠 efSearch 在召回率与延迟之间取平衡。IVF_PQ 先把向量聚类成 nlist 个桶,查询时只扫 nprobe 个桶,并用乘积量化压缩存储,适合数据量上亿且内存受限的场景。
把一千字压成 1024 个浮点数,信息一定有损。损失最严重的是低频字符串:产品型号、零件编号、人名、金额、日期。这些词在训练语料中出现次数少,向量位置接近随机,对最终相似度的贡献微乎其微。
纯向量检索在处理专有名词时可能效果不佳,需要全文检索作为补充。
补救思路有两条。一条是 late interaction,ColBERT 一类的方案把相似度计算推迟到查询阶段按 token 逐一比对,保留细粒度的匹配信号,代价是存储放大。另一条是让同一个模型同时产出多种表示,BGE-M3 一次推理就能给出稠密向量、稀疏权重和多向量表示,便于工程上整合多路召回的原料。这是它在中文 RAG 场景里被较多采用的原因之一。
全文检索
向量检索广泛应用之前,检索主要依赖倒排索引。倒排索引的结构是"词 → 包含该词的文档列表",和书本末尾的索引页同构。打分用 TF-IDF:一个词在本篇文档里出现次数越多,同时在全部文档里出现的文档数越少,它对这篇文档就越有代表性
。
TF-IDF 的缺陷在于词频对得分的影响是线性的。文档里出现十次"功率"的得分是出现两次的五倍,可十次和五次在实际语义上差别不大。BM25 给词频加了饱和机制,词频增长的边际收益递减,同时把文档长度纳入归一化,长文档不会因为词多就天然占优。
中文场景还要额外处理分词。细粒度过粗的分词器会把长专名切成一整块,检索"长江大桥"匹配不到整块索引的条目,工程上通常配合细粒度分词器或字符级 n-gram 来兜底。
全文检索看字符层面的精确匹配,型号、编号、金额这类字符串命中后,得分通常较高。同义词在它眼里是两个无关的词,用户搜"计算机"搜不到"电脑"。向量检索恰好反过来,同义改写都能召回,专有名词却被稀释。两条链路的失效区域通常不重叠,这是混合检索能够发挥作用的重要基础。
融合有两条路。分数加权需要先把两路得分归一化,量纲不同导致调参成本高。倒数排名融合(RRF)只看每条结果在各自榜单里的名次,得分按 1/(k+排名) 累加,k为可调常数。它绕开了分数量纲,哪一路的结果稳定靠前,融合后依然靠前,工程上更稳,代价是丢掉了分数本身携带的置信度信息。真正要收敛,得用自家数据把 Recall@50 和 MRR@10 跑出来,再定权重和 k。
图谱补关系
图谱进入 RAG 链路的价值,在于把"片段"关联成"事实链"。文档 A 写"李某是 X 项目的负责人",文档 B 写"X 项目三月发生一起质量事故",文档 C 写"该事故导致 B 类物料停采"。向量检索能把三段都找出来,模型手上却没有显式的连接依据,它可能串对,也可能串错。
图谱的做法是先抽实体和关系,把三句落成一条链:李某负责 X 项目,X 项目发生质量事故,事故导致 B 类物料停采。抽取之后还有一步共指消解,"李某""李经理""李总"要归到同一个实体 ID,否则图上会出现三个孤立节点,路径查询照样走不通。这一步工业界普遍用规则加向量相似度结合的方式处理。
面对用户问的问题,系统用 Cypher 沿路径查询,把这条链返回给大模型。落到上下文有两条路:把子图序列化成文本片段送进 Prompt,通用性最好;用 Cypher 的返回结果直接拼结构化答案,适合指标类和清单类问题。前者覆盖面广,后者准确率更高。
工程实现
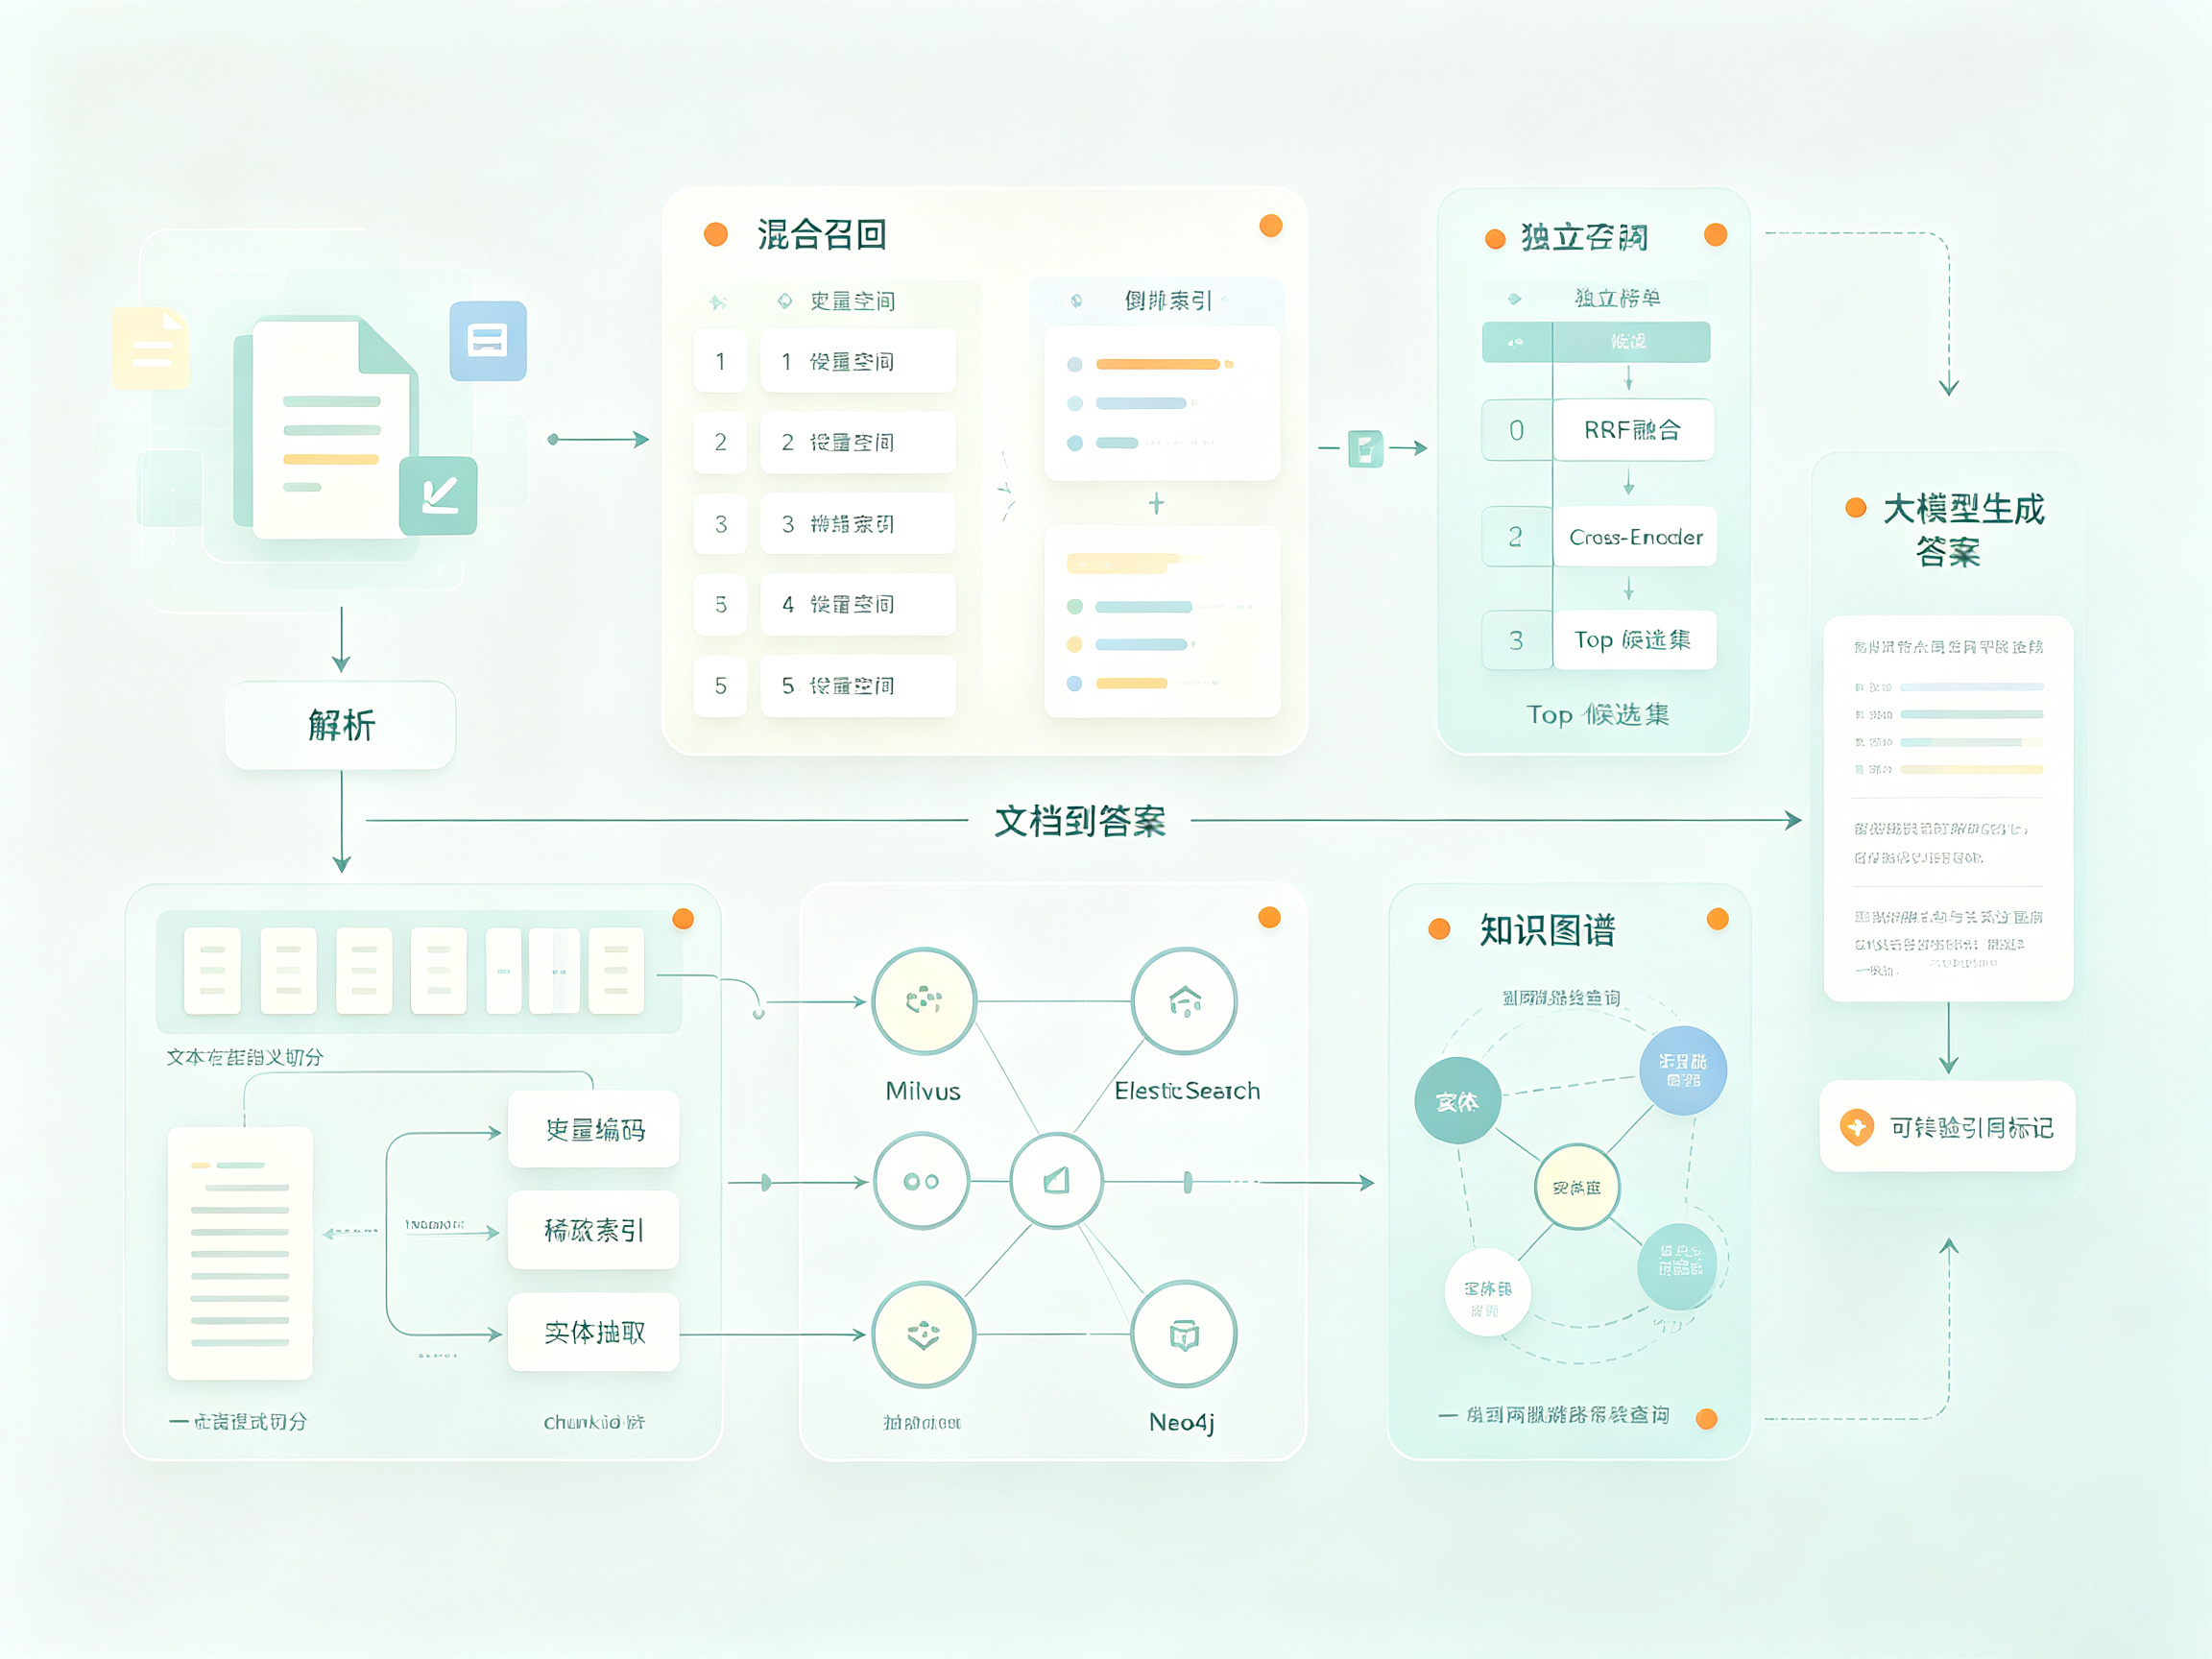
文档接入。 PDF、Word、Excel、CSV、图片等格式统一解析成文本,版面层级与表格结构尽量保留,表格转成纯文本流会丢掉行列对应关系。
语义切分。 按语义边界切块,避免一个完整论点被腰斩。切分质量对最终效果的影响,通常大于换一个 Embedding 模型。
向量化与入库。 BGE-M3 生成 1024 维稠密向量写入 Milvus,稀疏权重与原文写入 Elasticsearch,实体关系写入 Neo4j。三份数据由同一次解析结果派生,chunk_id 对齐,溯源时能互相定位。
混合召回。 向量与全文各取 Top-50,RRF 融合后截断到 Top-10。这一步的目标是把 Recall@50 做到 0.9 以上,宁可多召回,把精确筛选的活交给重排。
重排。 用 Cross-Encoder 结构的重排模型对这 10 条做全注意力交互打分,取 Top-5 进入上下文。这一步是整条链路里性价比最高的环节,召回可以不完美,重排的准确性至关重要。
图谱补充。 从问题里抽实体,在 Neo4j 里做一到两跳查询,把返回的路径文本化后作为独立上下文注入。
生成与溯源。 大模型主要依据召回片段、图谱事实、用户问题三部分作答,解码温度设 0 以减少随机性,Prompt 里建议模型在无依据时回答不知道。答案每句后面可挂引用编号,指向具体的 chunk_id 与图谱路径,生成之后可做引用校验,尝试剔除缺乏明确出处的句子。
这条链路的每一环通常可单独打日志和评测。召回集对不对,重排后的顺序对不对,图谱有没有命中,便于量化评估。出问题时有助于定位到具体环节。