
 立即咨询
园区能耗与碳管理:用智能体算清碳排放的账
园区要算清碳排放,通常要花很长时间。公式是公开的,那么时间都花在哪儿了?水电气热分属不同系统,电力数据来自能源管理系统,蒸汽和天然气走流量计,抄表周期与计量单位各不相同,人工汇总可能面临口径不一、录入差错或追溯困难等风险。排放因子的口径随主管部门的公布节奏逐年更新,因子更新可能影响核算结果,是否需要调整应依据适用规则和核查要求判断。核算过程只留结果、不留中间记录,第三方核查时就只能回头翻原始单据,工作量巨大。
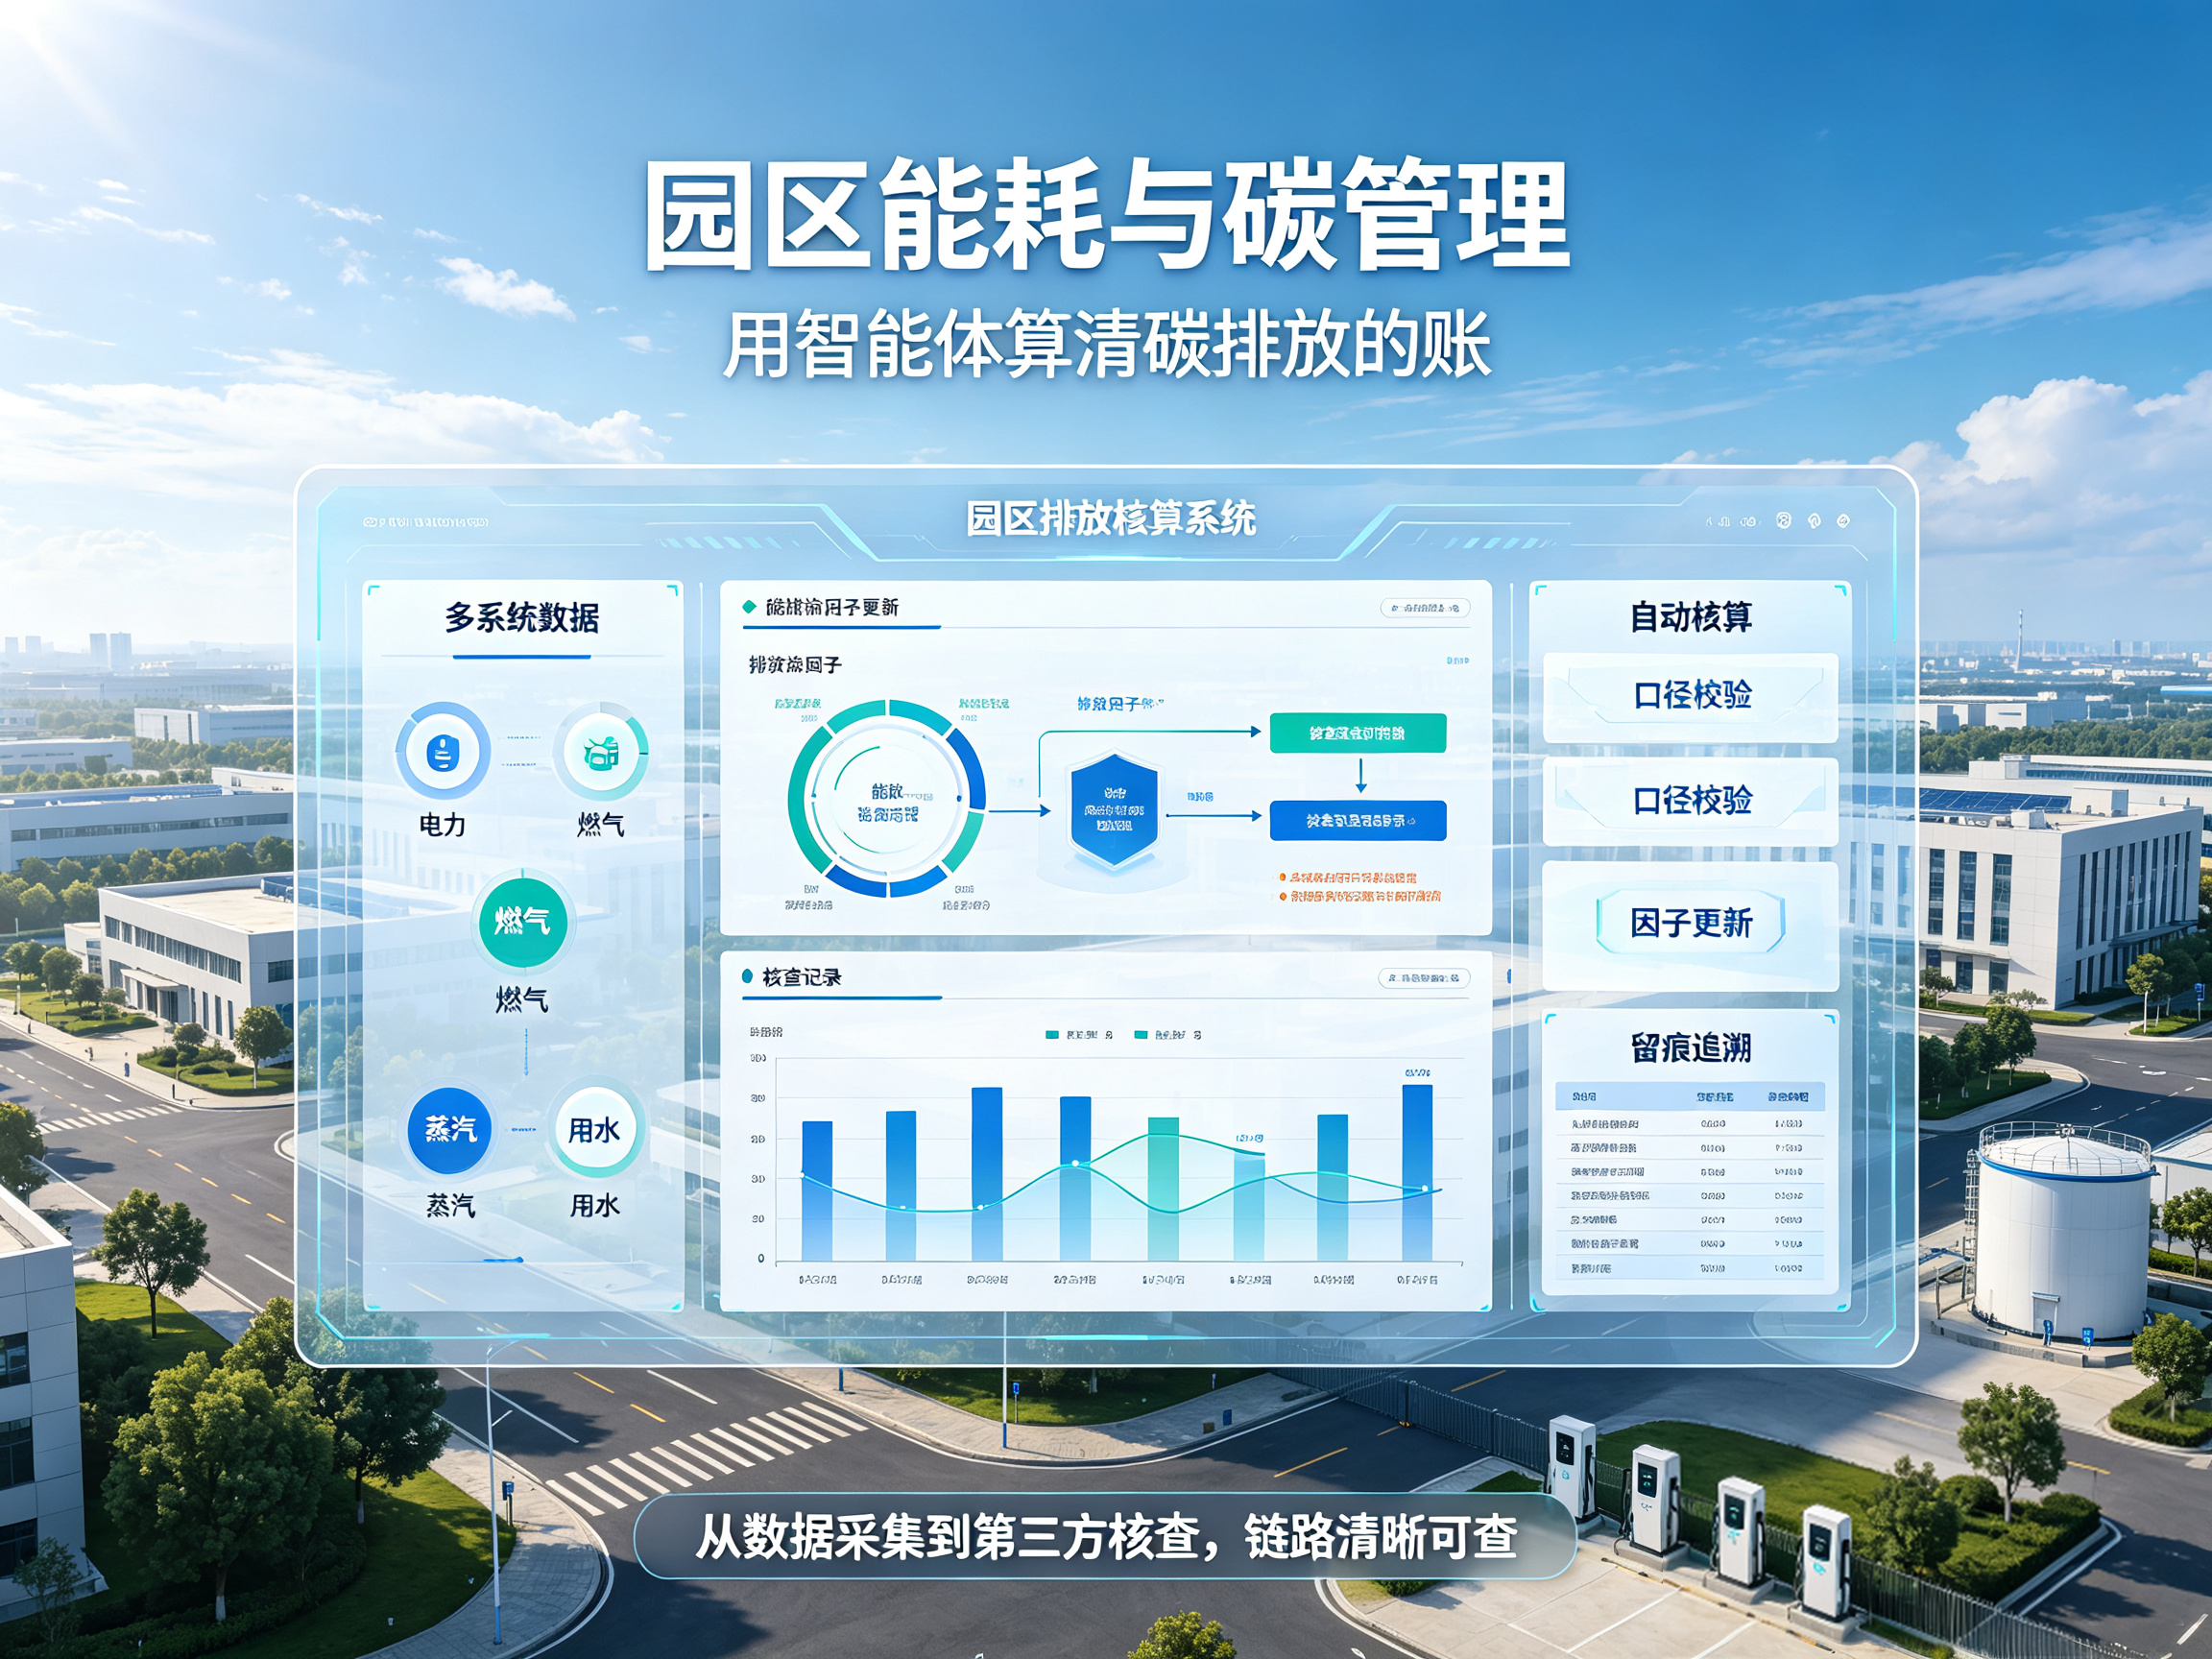
企业碳账本,最初是被规则逼出来的
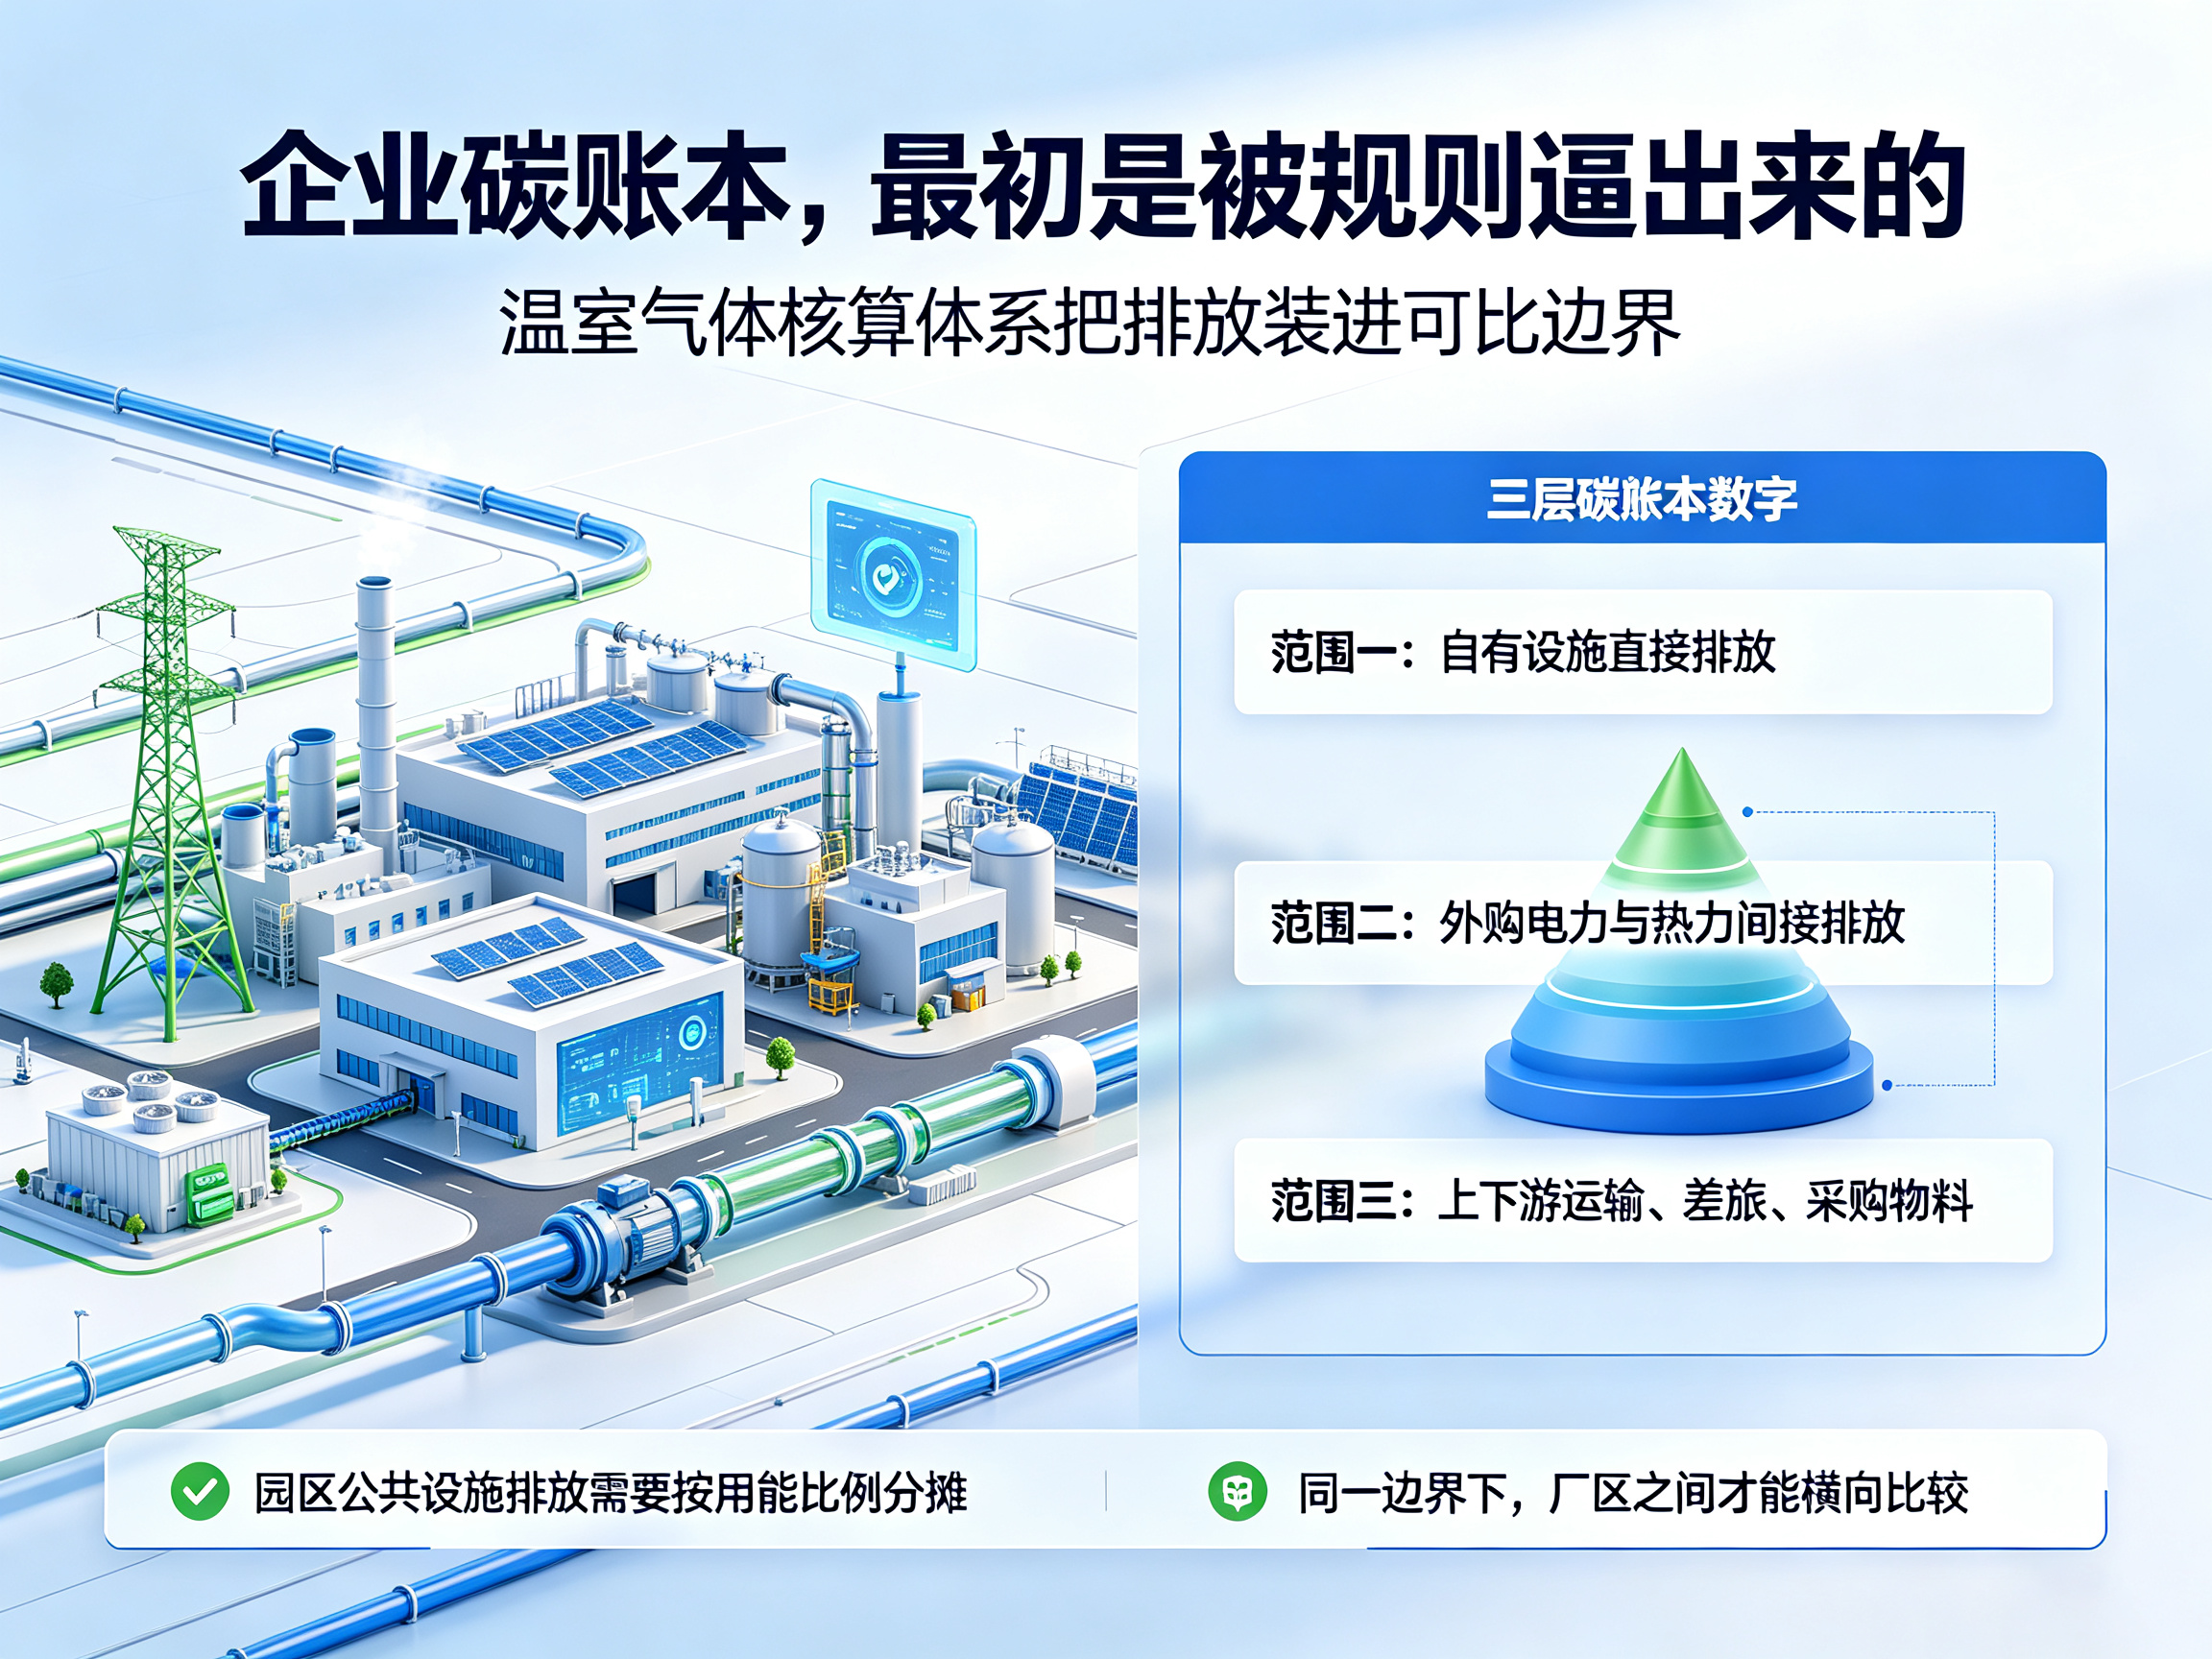
碳排放之所以能变成一个可比较的数字,起点是一套人为约定的边界。温室气体核算体系(GHG Protocol)最早由两家国际机构联合编写,用来回答一个看似简单的问题:一家工厂的排放,到底该算哪些。
它给出的答案是三个范围。范围一收录自有设施燃烧燃料产生的直接排放。范围二处理外购电力和热力在别处产生的那部分间接排放,企业对它的控制力有限,只能通过采购绿电或节能改造间接施加影响。范围三把上下游运输、差旅、采购物料等间接排放也纳入账本,这一块通常是数据最难收齐的部分。这套三分法后来被 ISO 14064 系列标准吸收。
这套规则的价值落在可比性上。同一集团下的两个厂区,只要遵循同一边界,数字就能横向对比。园区作为多企业共用能源基础设施的物理边界,情况更复杂一些,公共制冷站、蒸汽管网、污水处理设施的排放既记在运营方名下,也要按用能比例分摊给各家企业。
一度电排多少碳?答案一直在变
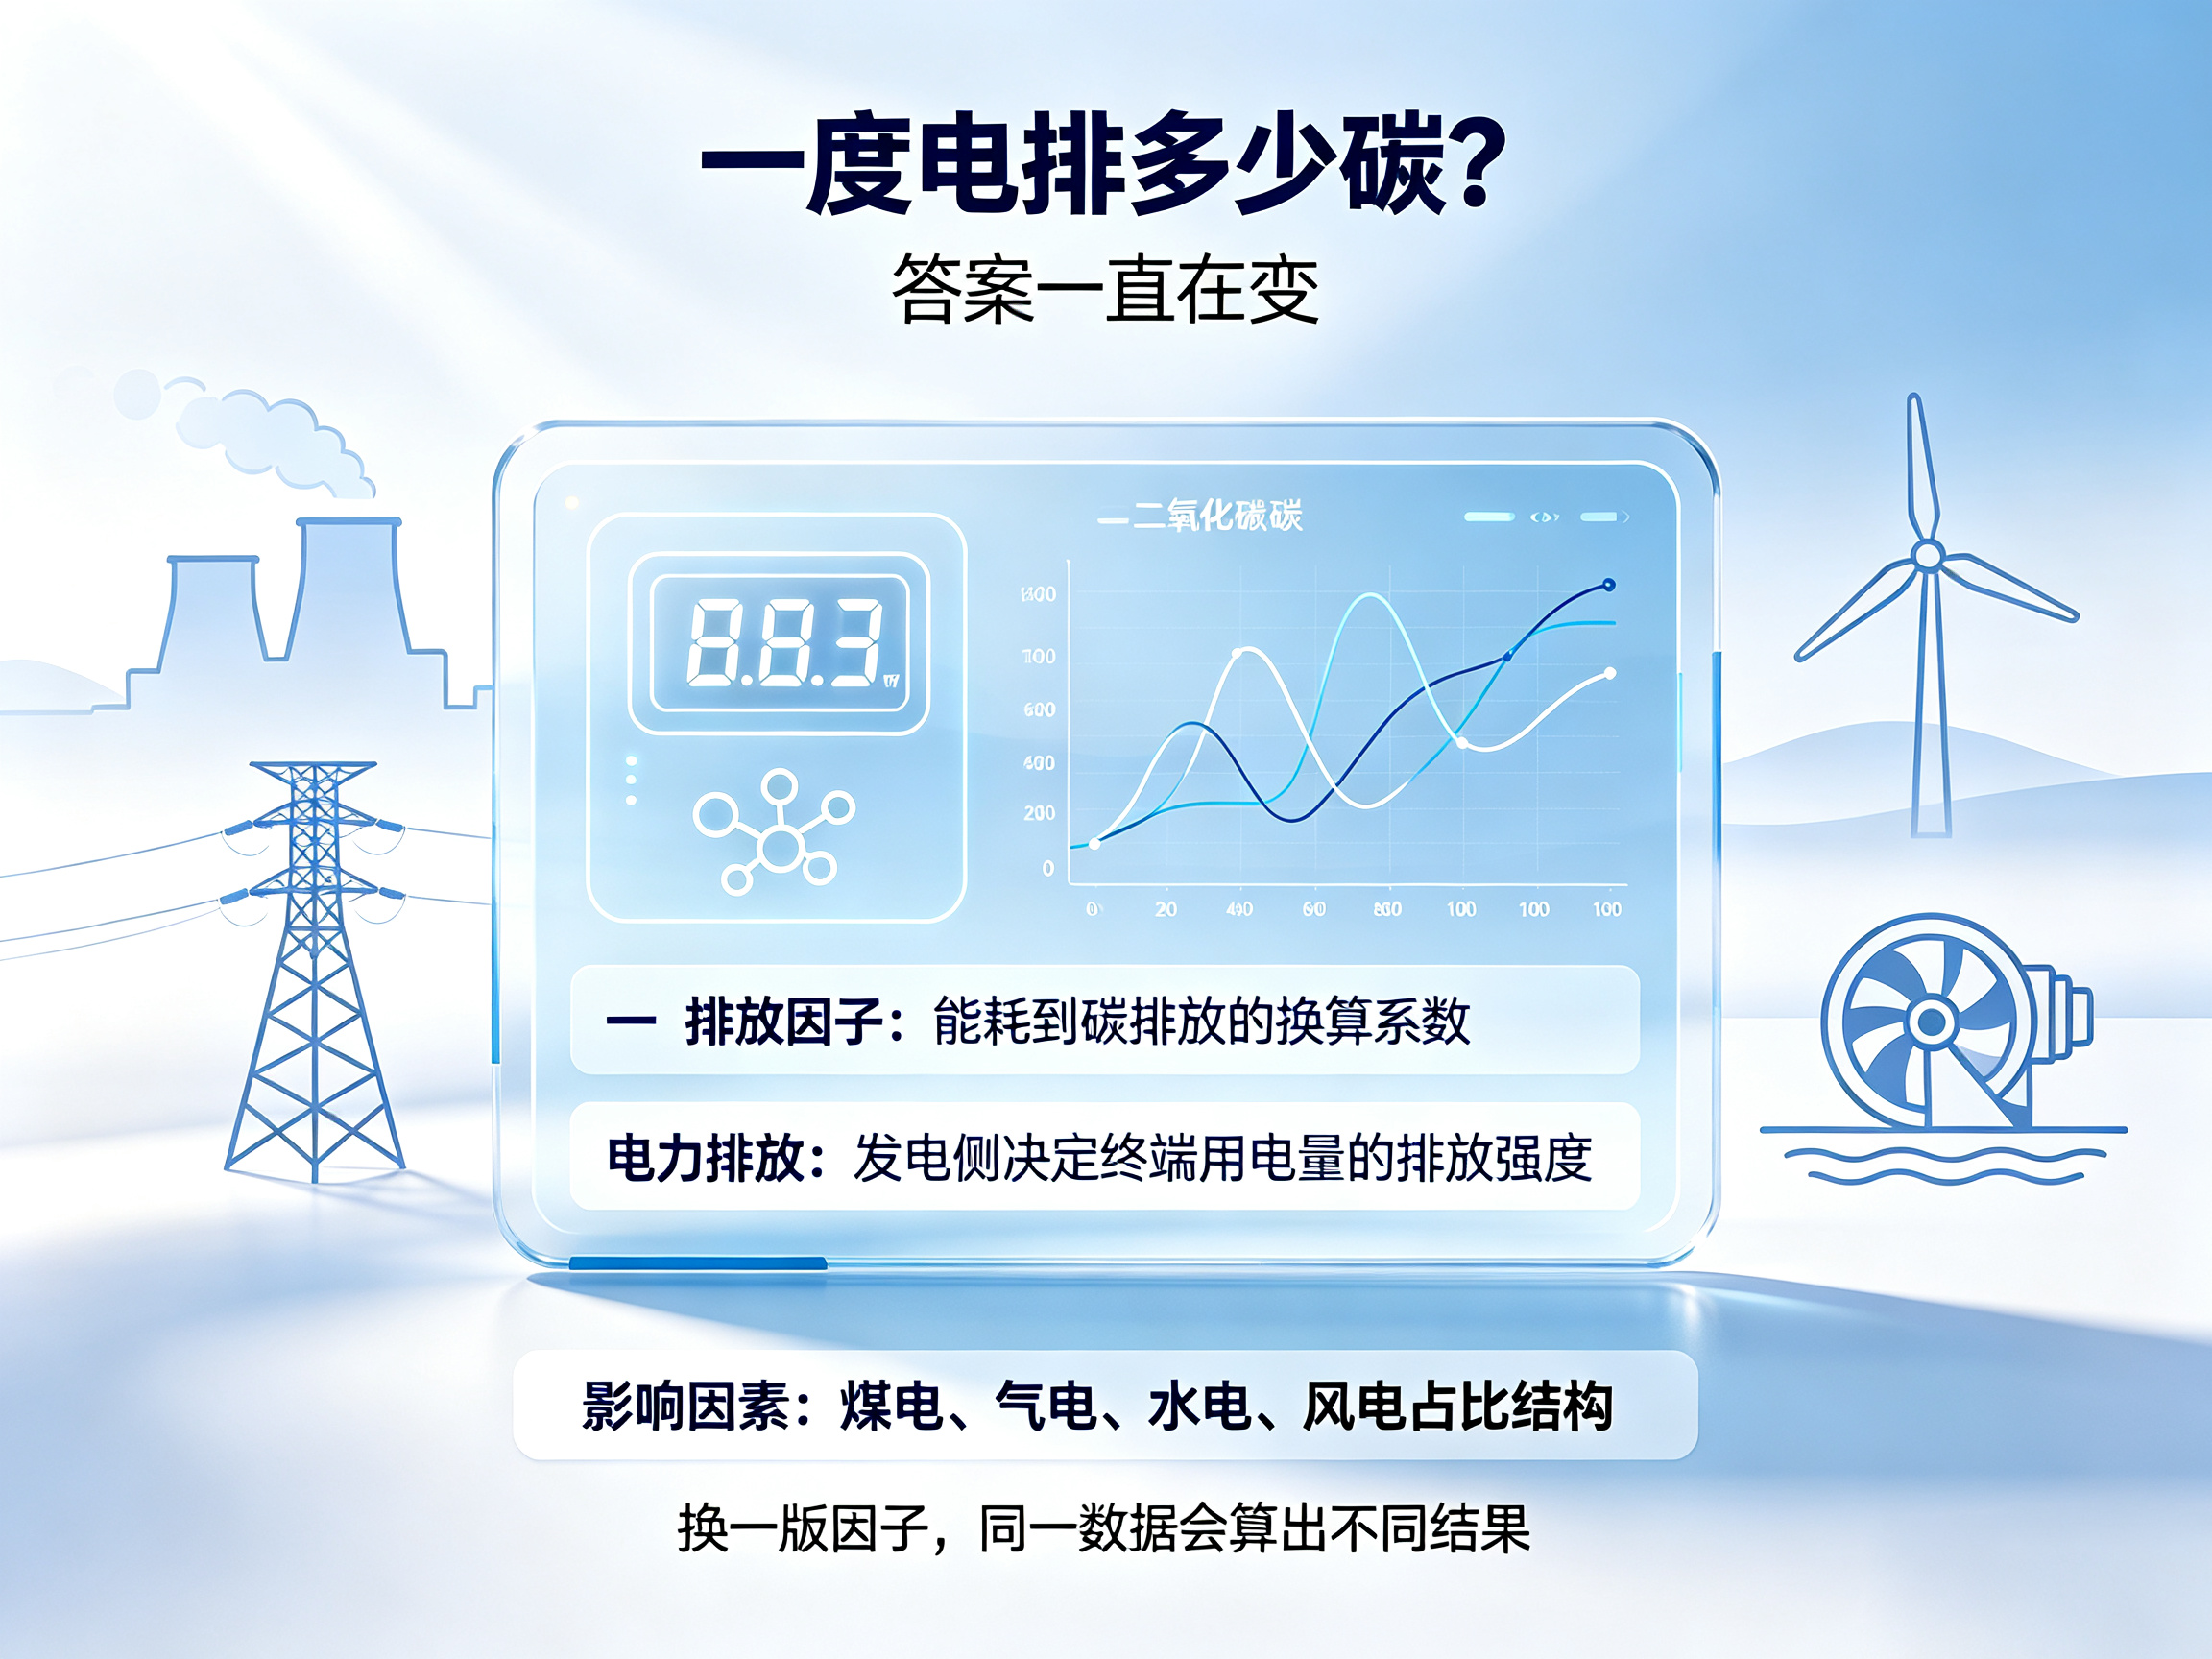
排放因子是把能耗换算成碳排放的换算系数,它的来历可以追到国家温室气体清单指南。这套指南最初服务于国家层面,向国际气候公约报送年度清单。基本思路是把活动量乘以排放系数。
化石燃料的系数由三个物理量相乘得到,燃料的低位发热量、单位热量的含碳量、燃烧过程的氧化率,再乘以 44/12 的分子量比,把碳元素折算成二氧化碳。
电力因子要绕一层。电在终端侧的排放为零,排放全部发生在发电侧,于是需要先算出一个电网的平均排放强度,再用它去乘用电量。这个值取决于电网里煤电、气电、水电、风电的占比结构,区域之间差异明显。同一份能耗数据,换一版因子会算出什么结果?隔一年,主管部门公布的基准线就变了。工程上常见的坑是核算表沿用了几年前的因子,只是表面数字看起来完整,实际口径已经过期。
数据抽取经历过三次换代
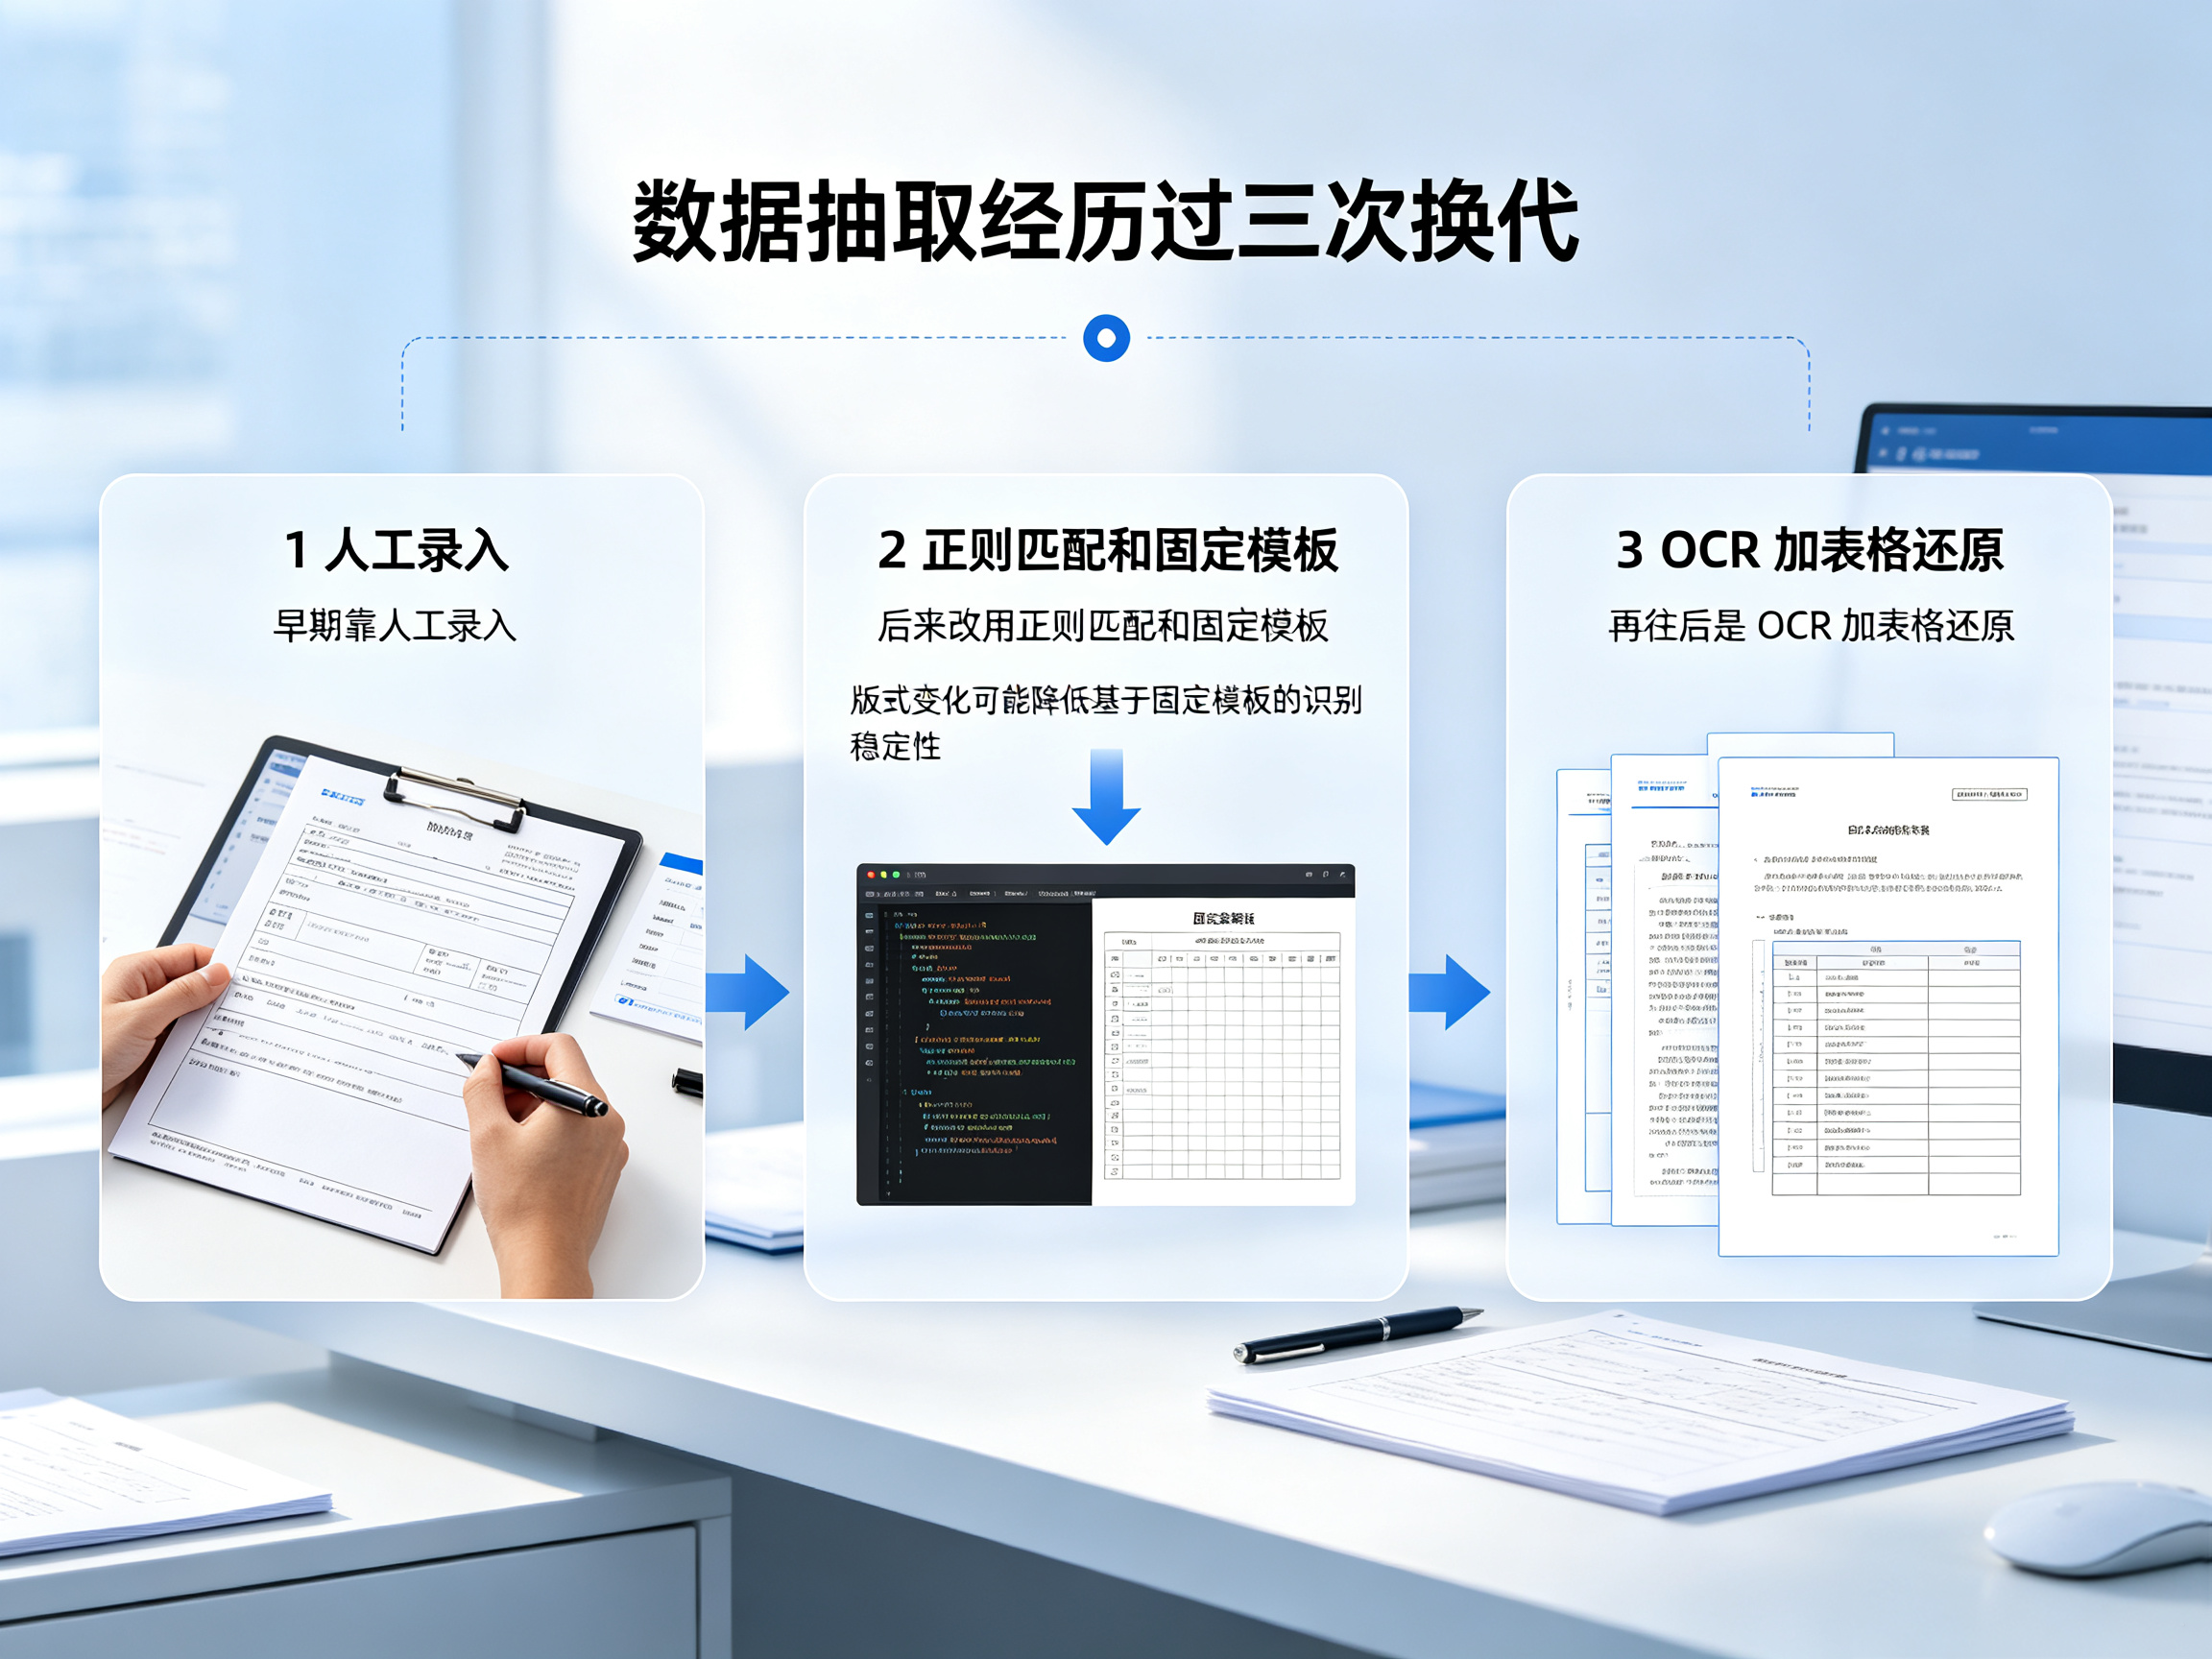
园区里水电气热分别由不同系统计量,格式涵盖数据库表、Excel 报表、PDF 发票和扫描件。把这些信息搬进核算表,早期靠人工录入,后来改用正则匹配和固定模板。
版式变化可能降低基于固定模板的识别稳定性。再往后是 OCR 加表格还原,能处理扫描件,对跨页表格和手写批注的稳定性就差一些。
大模型可辅助字段识别、定位和归一;关键计量、单位和因子仍应校验。发票上的用电量、抄表日期、计量单位被直接抽成结构化字段,单位同步换算成标准口径,比如把立方米天然气按热值折算成吉焦。
图谱解决的是分摊问题
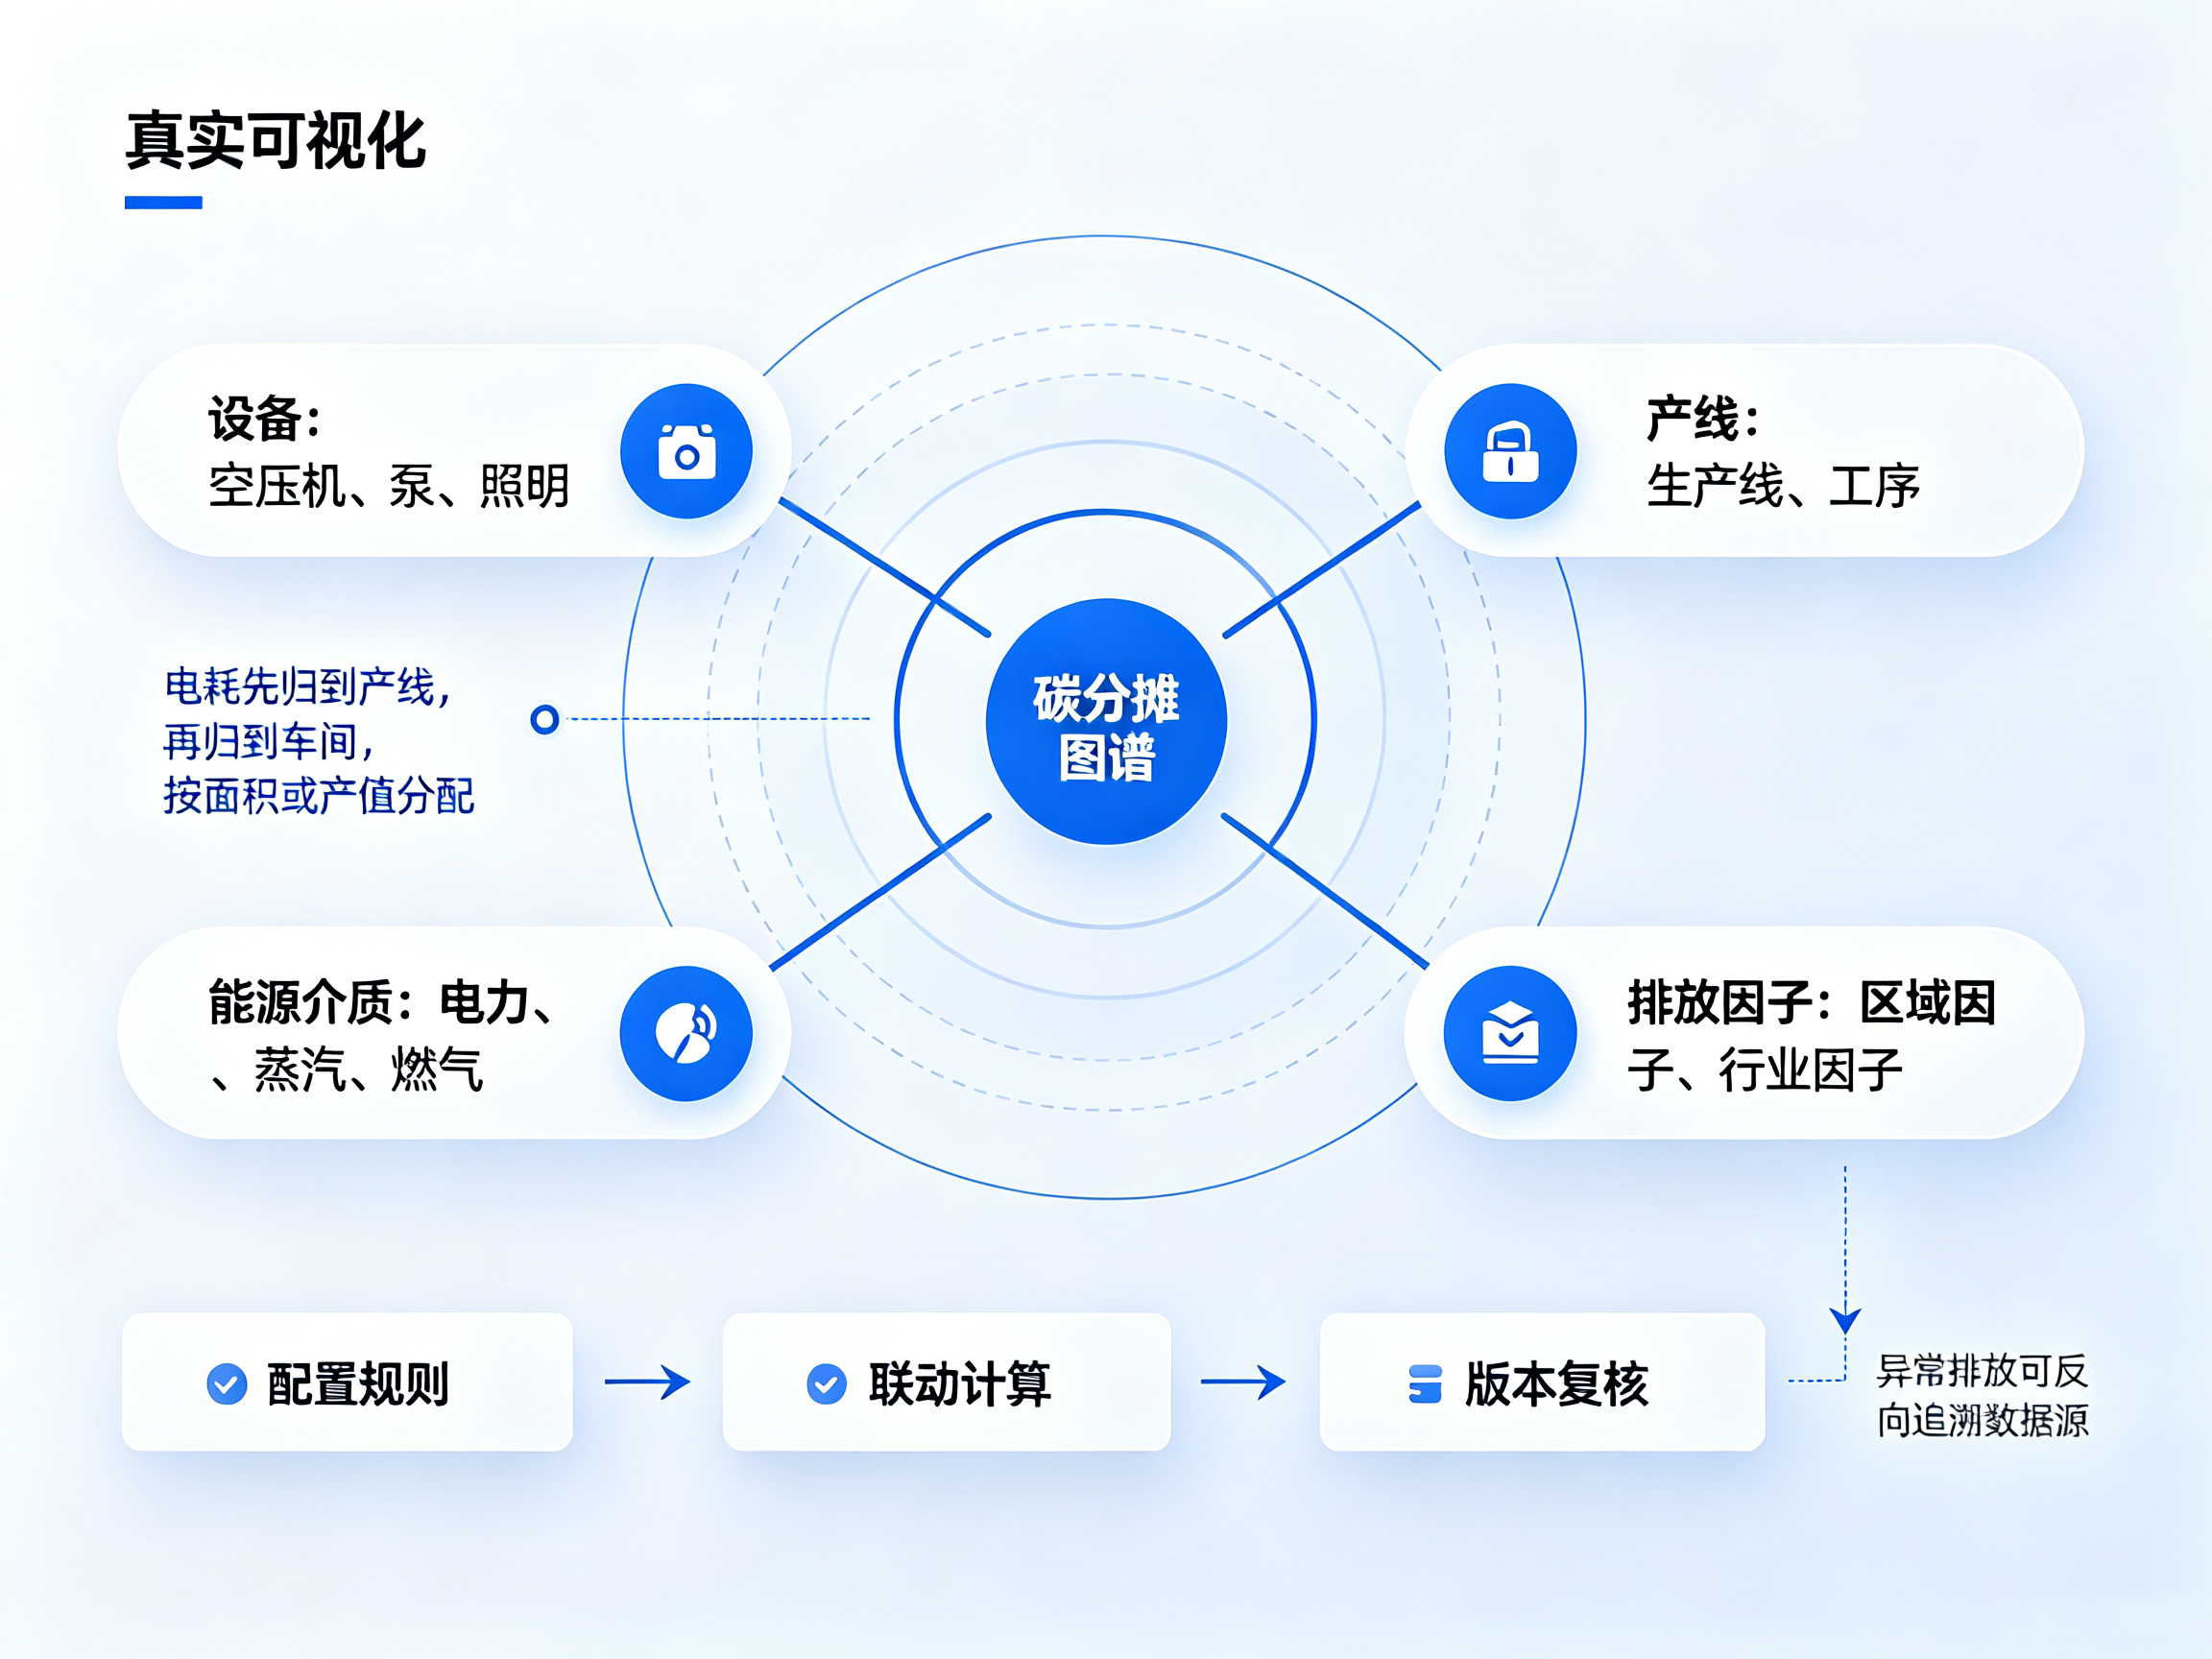
设备、产线、能源介质、排放因子之间的关系,用二维表表达会很吃力。关系型数据库靠外键和 join 处理关联,层级一深,查询语句迅速膨胀,性能跟着下降。图数据库换了思路,把实体和关系都作为一等对象存储,遍历相邻节点的开销基本恒定。属性图模型给节点和边都挂上标签与属性,配套查询语言 Cypher 用图案匹配的方式描述路径。
对碳核算而言,这张图的核心用途是分摊。一台空压机的电耗,该算给谁?先归到它服务的产线,产线再归到车间,车间按面积或产值分给不同企业。在因子映射与分摊规则正确配置后,可联动更新相关计算结果;应保留版本、复核和审计记录。
路径查询还支持反向追溯。某个排放数字异常升高时,可辅助追溯异常数据关联的设备、产线或计量环节。
核算标准要变成可执行的步骤流
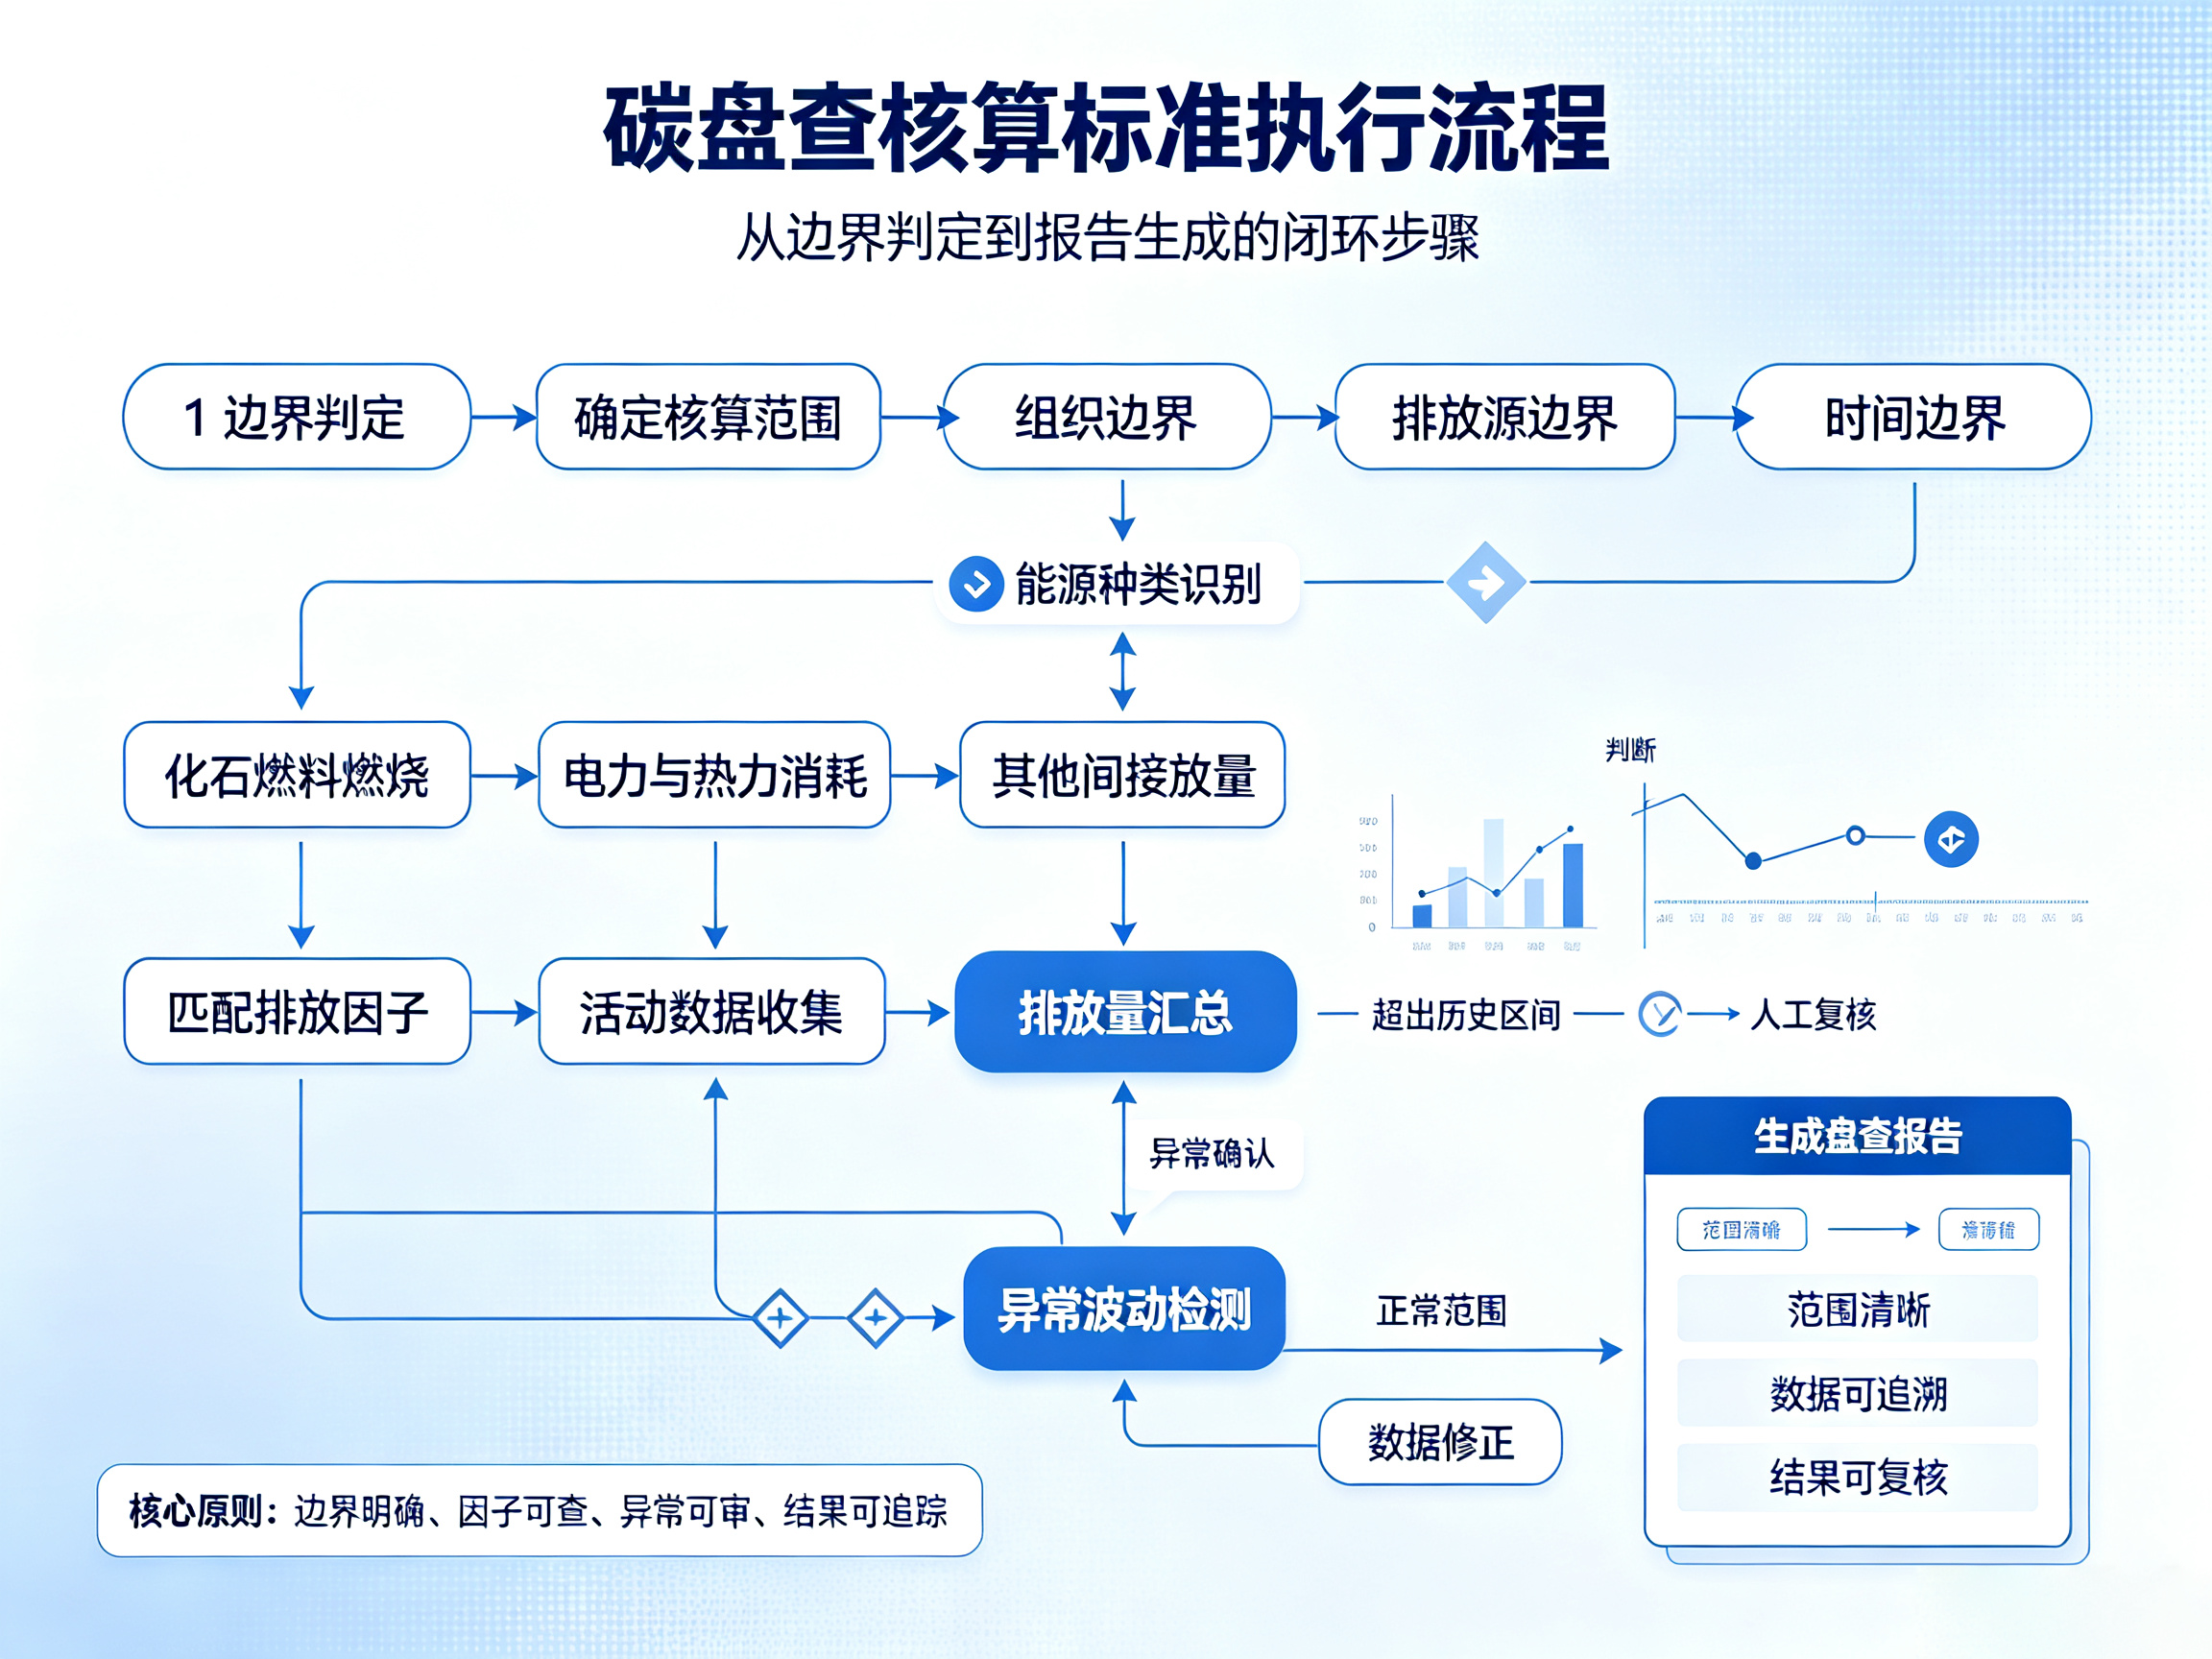
工作流编排技术经历了几代。最早的批处理脚本按顺序执行固定步骤,随后出现的业务流程管理标准用图形化语言描述流转,适合审批这类确定性流程,遇到循环和重试就力不从心。再往后是有向无环图调度器,能并行执行、能重试,结构上不含回环。大模型应用需要节点根据中间结果反复调整走向,于是出现了带状态和循环能力的编排框架,用状态图描述节点间的迁移,配合检查点机制把每一步的中间状态落盘。
碳盘查正好是这类流程的典型。边界判定节点先确定核算范围,接着按能源种类分流,每条支路匹配对应的排放因子,汇总后进入异常检测,超出历史波动区间的数据被标记出来走人工复核,通过后生成报告。
关于小艾智能体
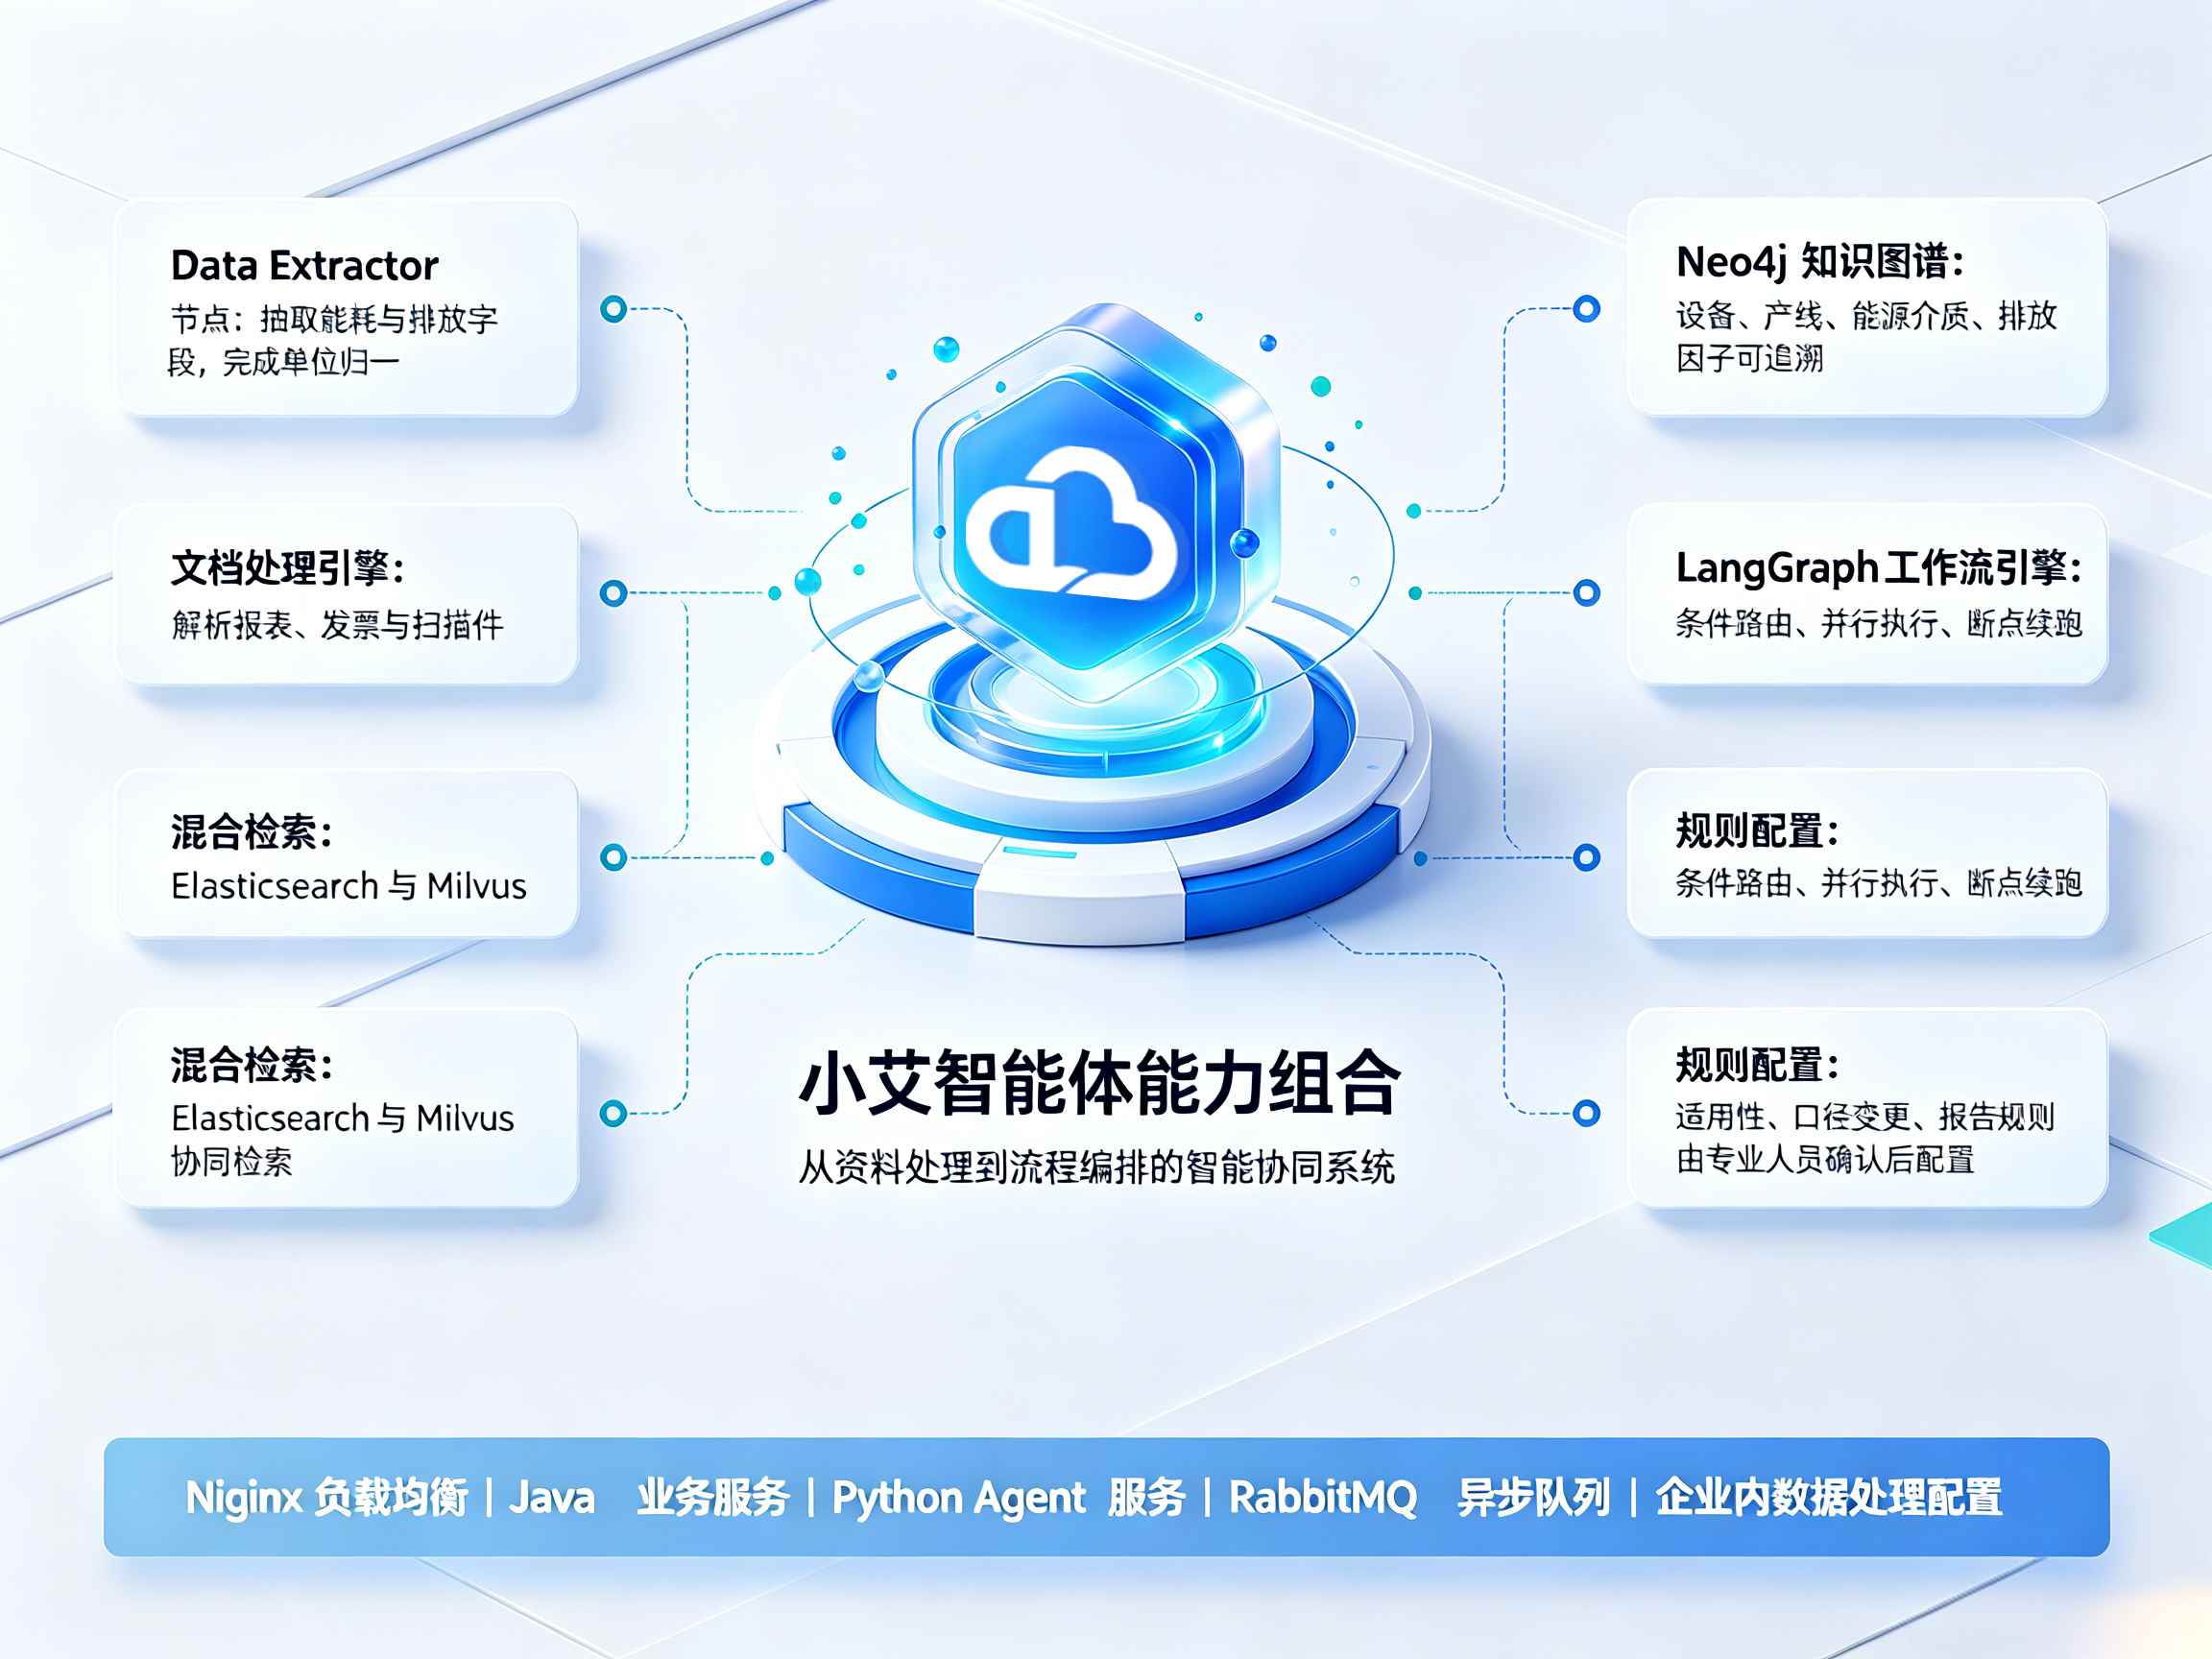
上面这套流程,对应的是小艾智能体已有的能力组合。Data Extractor 节点负责从报表、发票和扫描件中抽取能耗与排放字段,同步完成单位归一。Neo4j 构建的知识图谱把设备、产线、能源介质和排放因子连成可追溯的网络。LangGraph 驱动的工作流引擎支持条件路由、并行执行和基于检查点的断点续跑,把核算标准写成可配置的流程。文档处理引擎配合 Elasticsearch 与 Milvus 做混合检索,新文件可进入待评估资料库,适用性、口径变更及报告规则应由专业人员确认后配置。
部署层面,系统采用 Nginx 负载均衡加 Java 业务服务与 Python Agent 服务的微服务结构,RabbitMQ 承担异步队列,在约定的私有化部署、日志和外部接口策略下,相关数据可按配置在企业环境内处理。
系统用于辅助资料处理、数据汇总、检索与流程编排。输出结果应结合企业制度、数据质量、适用标准及具备职责人员的审核确认;具体功能以产品版本、部署方案和交付清单为准。