
 立即咨询
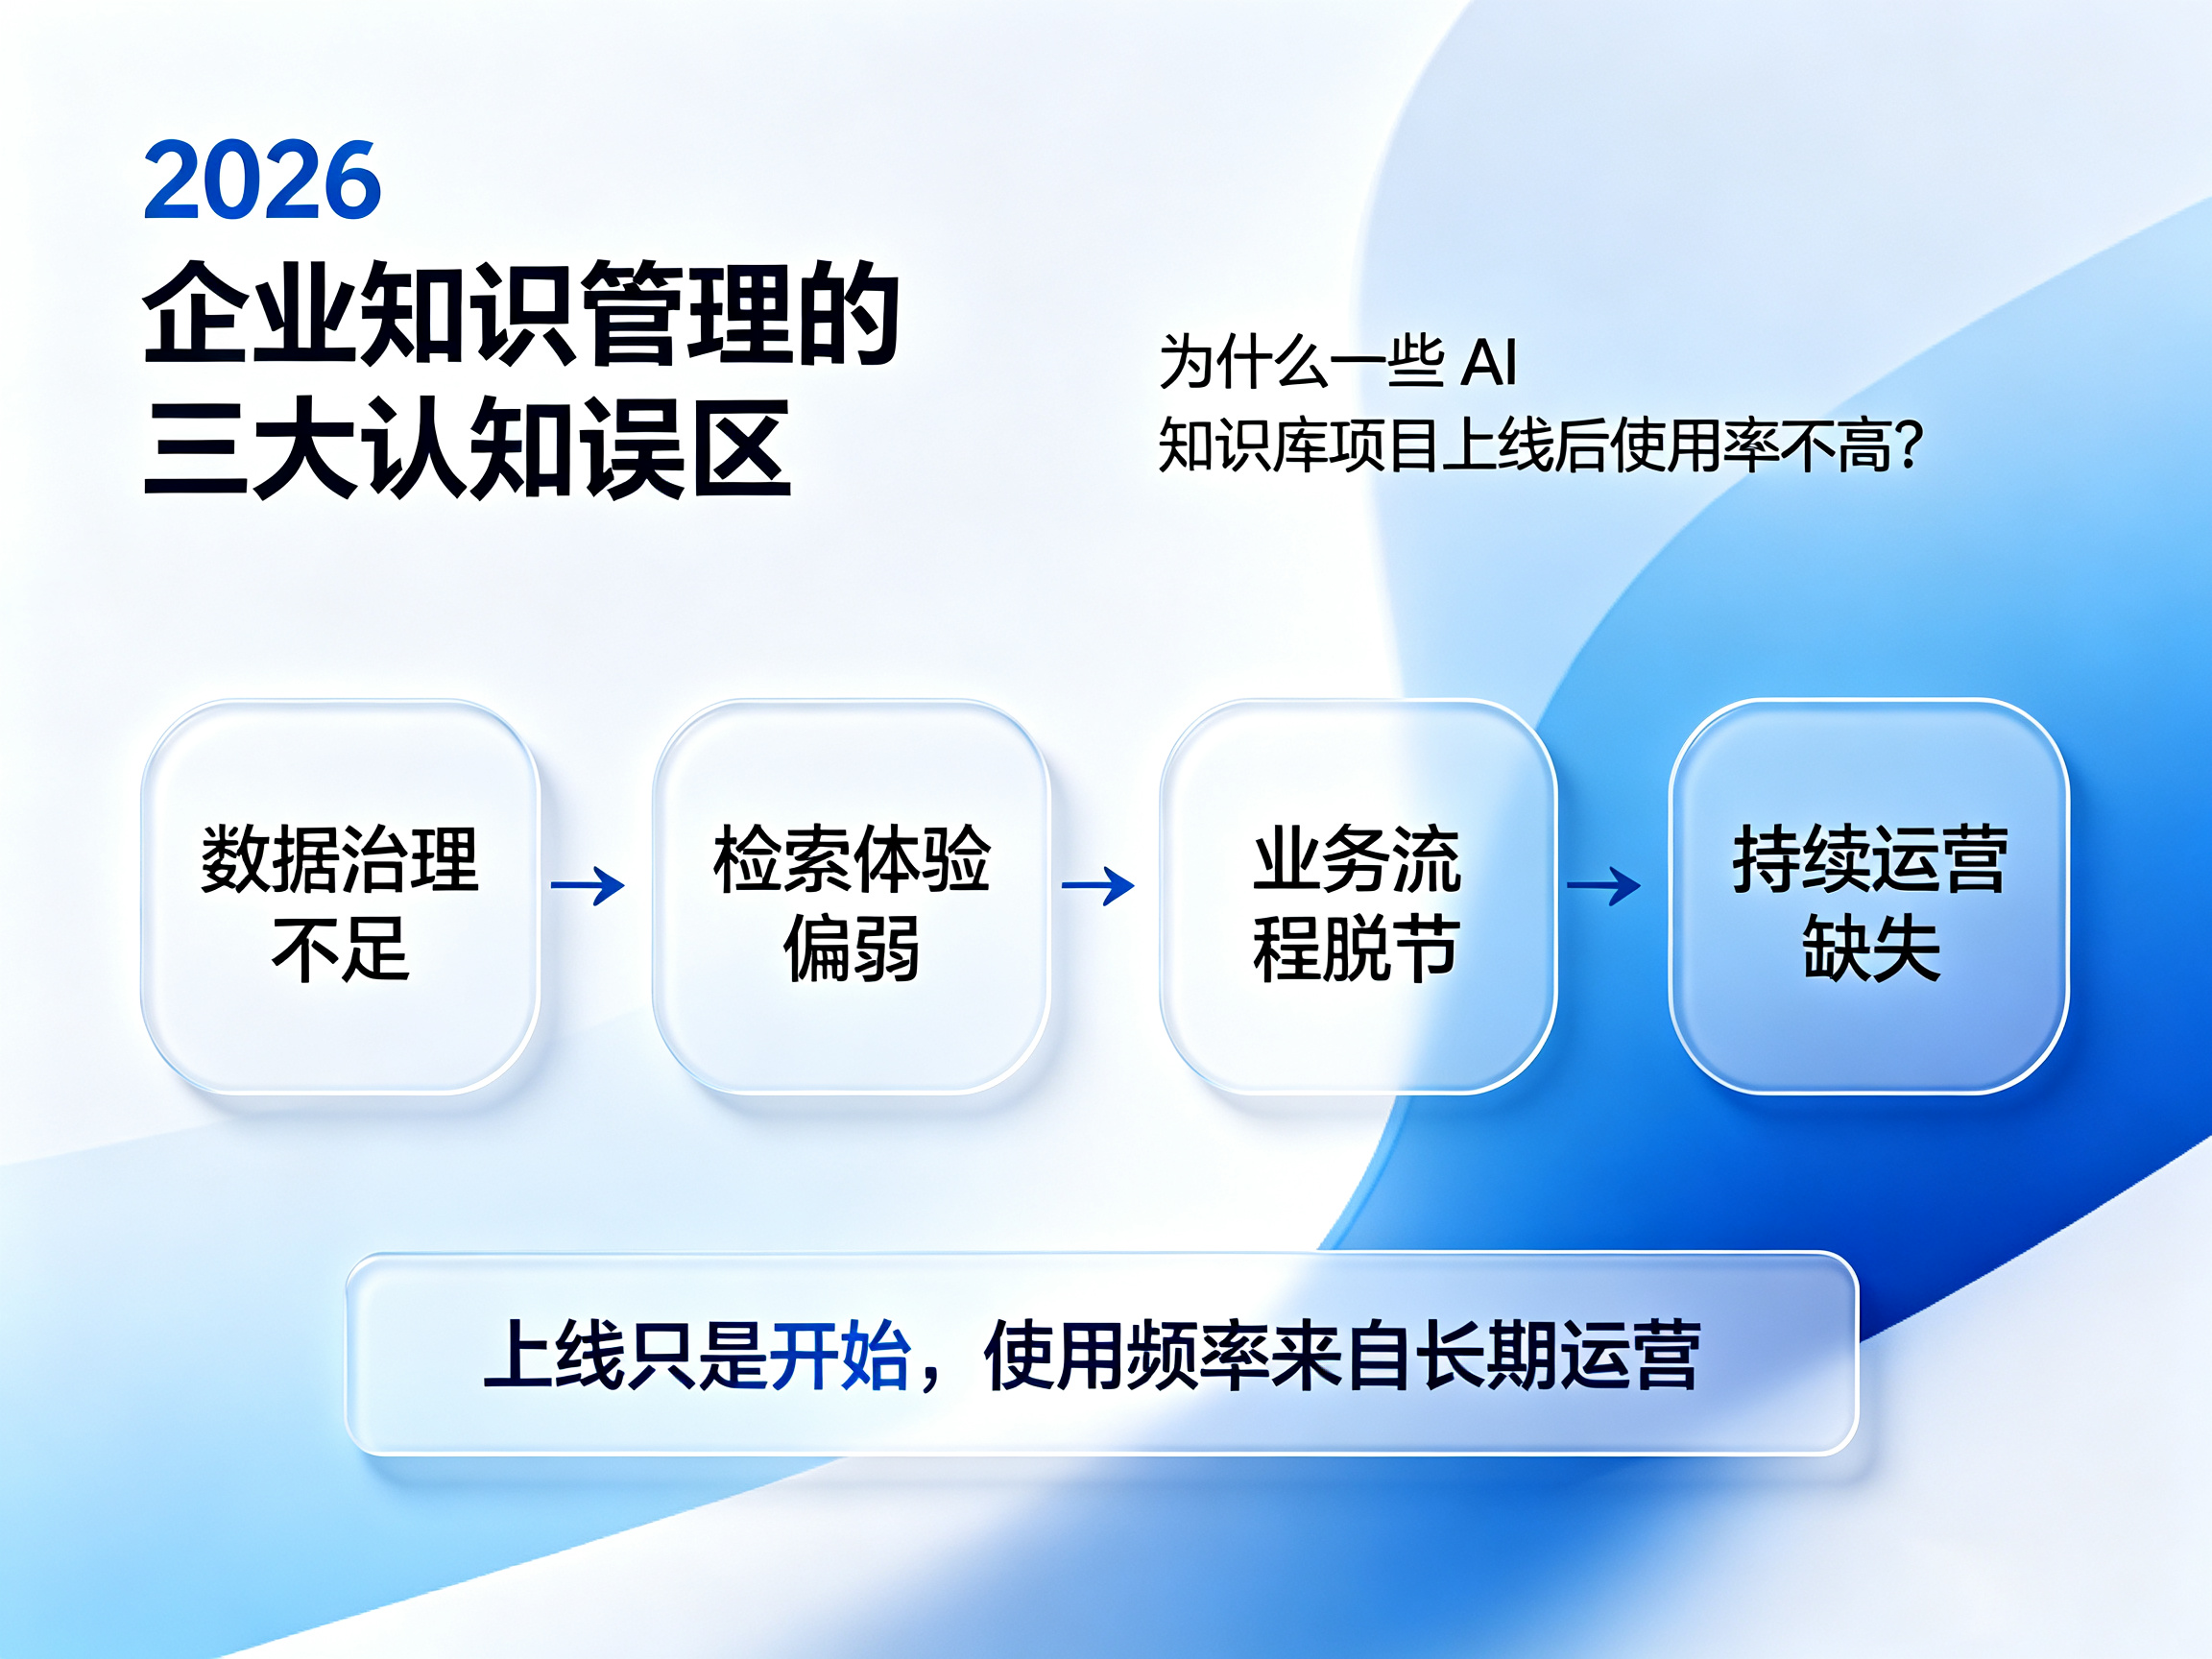
2026 企业知识管理的三大认知误区: 为什么一些 AI 知识库项目上线后使用率不高?
部分 AI 知识库项目在上线后会面临使用频率不高、检索体验不足或内容更新不及时等问题。其原因通常涉及数据治理、检索评测、业务流程和持续运营等多个方面。
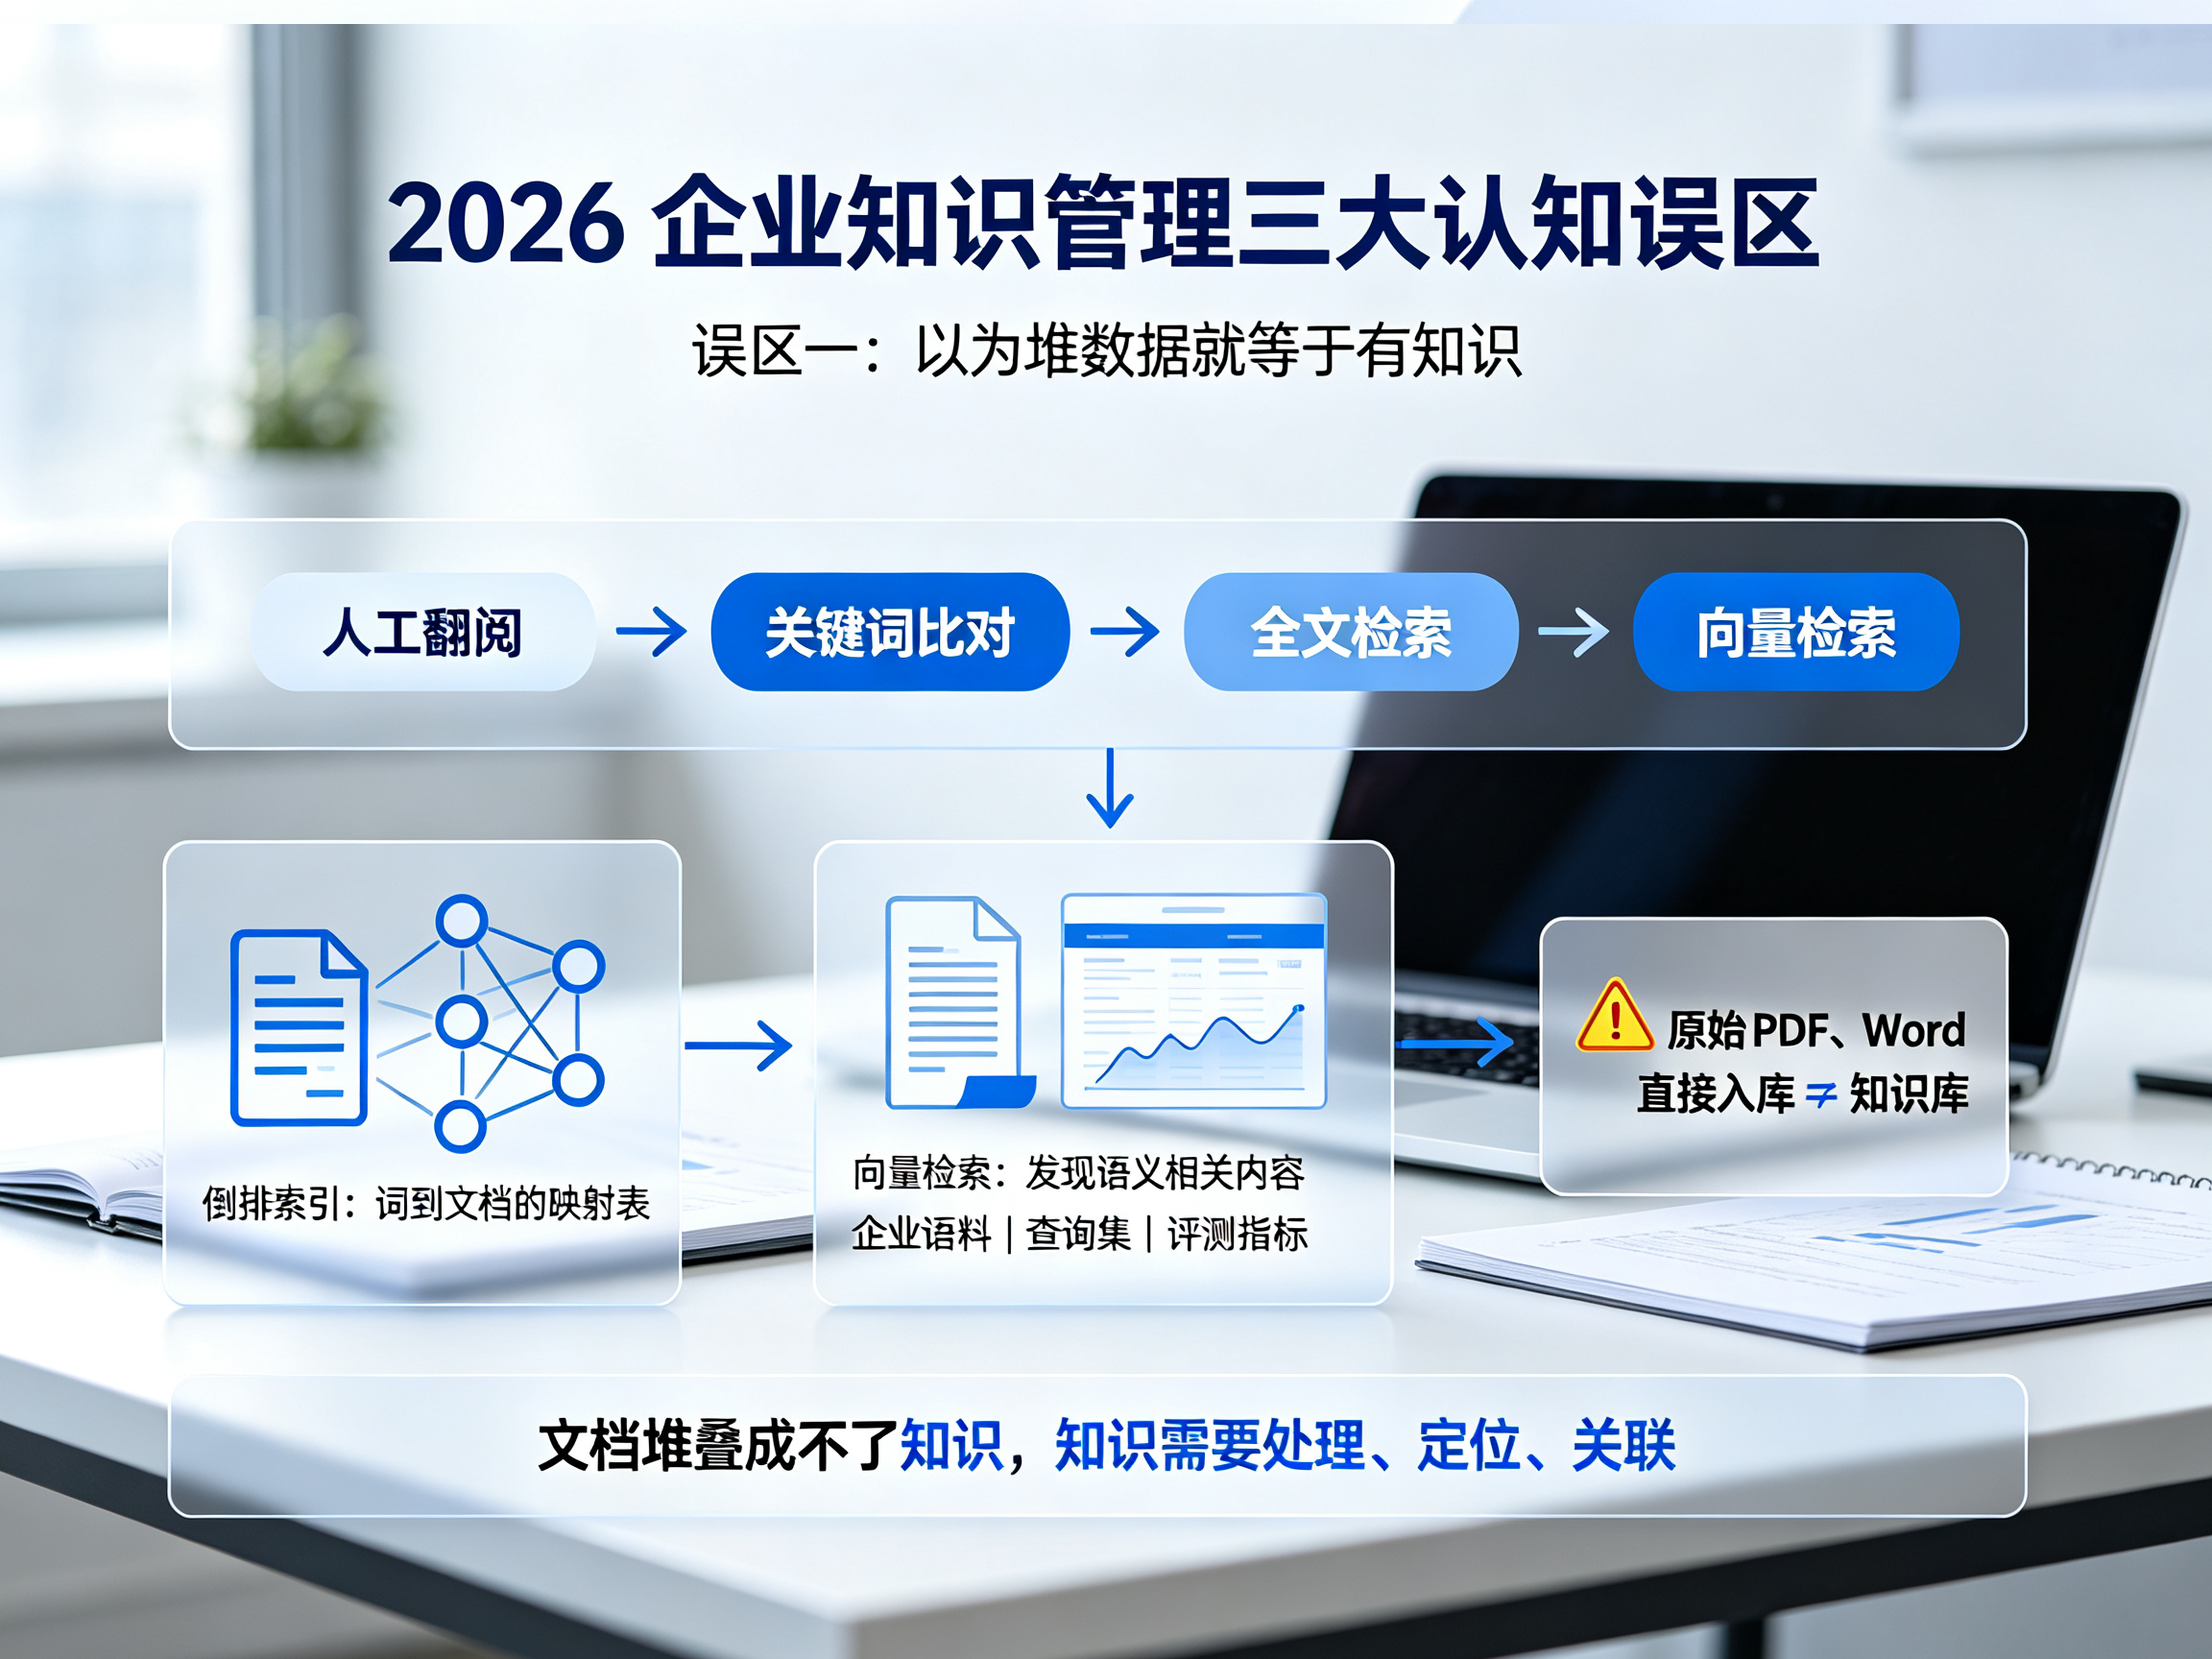
误区一:以为堆数据就等于有知识
要理解这个误区,得先说清楚"检索"这件事是怎么发展过来的。
信息查找最早依靠人工翻阅和关键词逐条比对。后来出现了全文检索技术,它建立在一个基础结构之上:把文档拆解成词,记录每个词出现在哪些文档,形成"词到文档"的映射表,查找时直接定位相关文档。这种结构叫做倒排索引,如今 Elasticsearch 这类引擎就是基于它运作。全文检索主要依赖关键词匹配;对表述差异较大的查询,通常需要结合词典、规则或语义检索增强。
向量检索可用于发现语义相关内容;其相对效果应结合企业语料、查询集和评测指标验。它的应用范围很广,除了企业语义搜索,还用在推荐系统、相似图片查找、重复内容检测等场景。
问题也在这里。如果企业只是把原始 PDF、Word 直接丢进库里,跳过了切分、向量化和内容关联这几步,那么在不少场景下,即使采用检索技术,都只是在一堆未经加工的原材料里翻找。检检索效果不足可能影响使用体验;项目使用情况还受内容覆盖、交互设计、推广培训和业务流程等因素影响。文档堆叠成不了知识,知识需要经过处理、更便于定位和关联,并为业务使用提供支持。
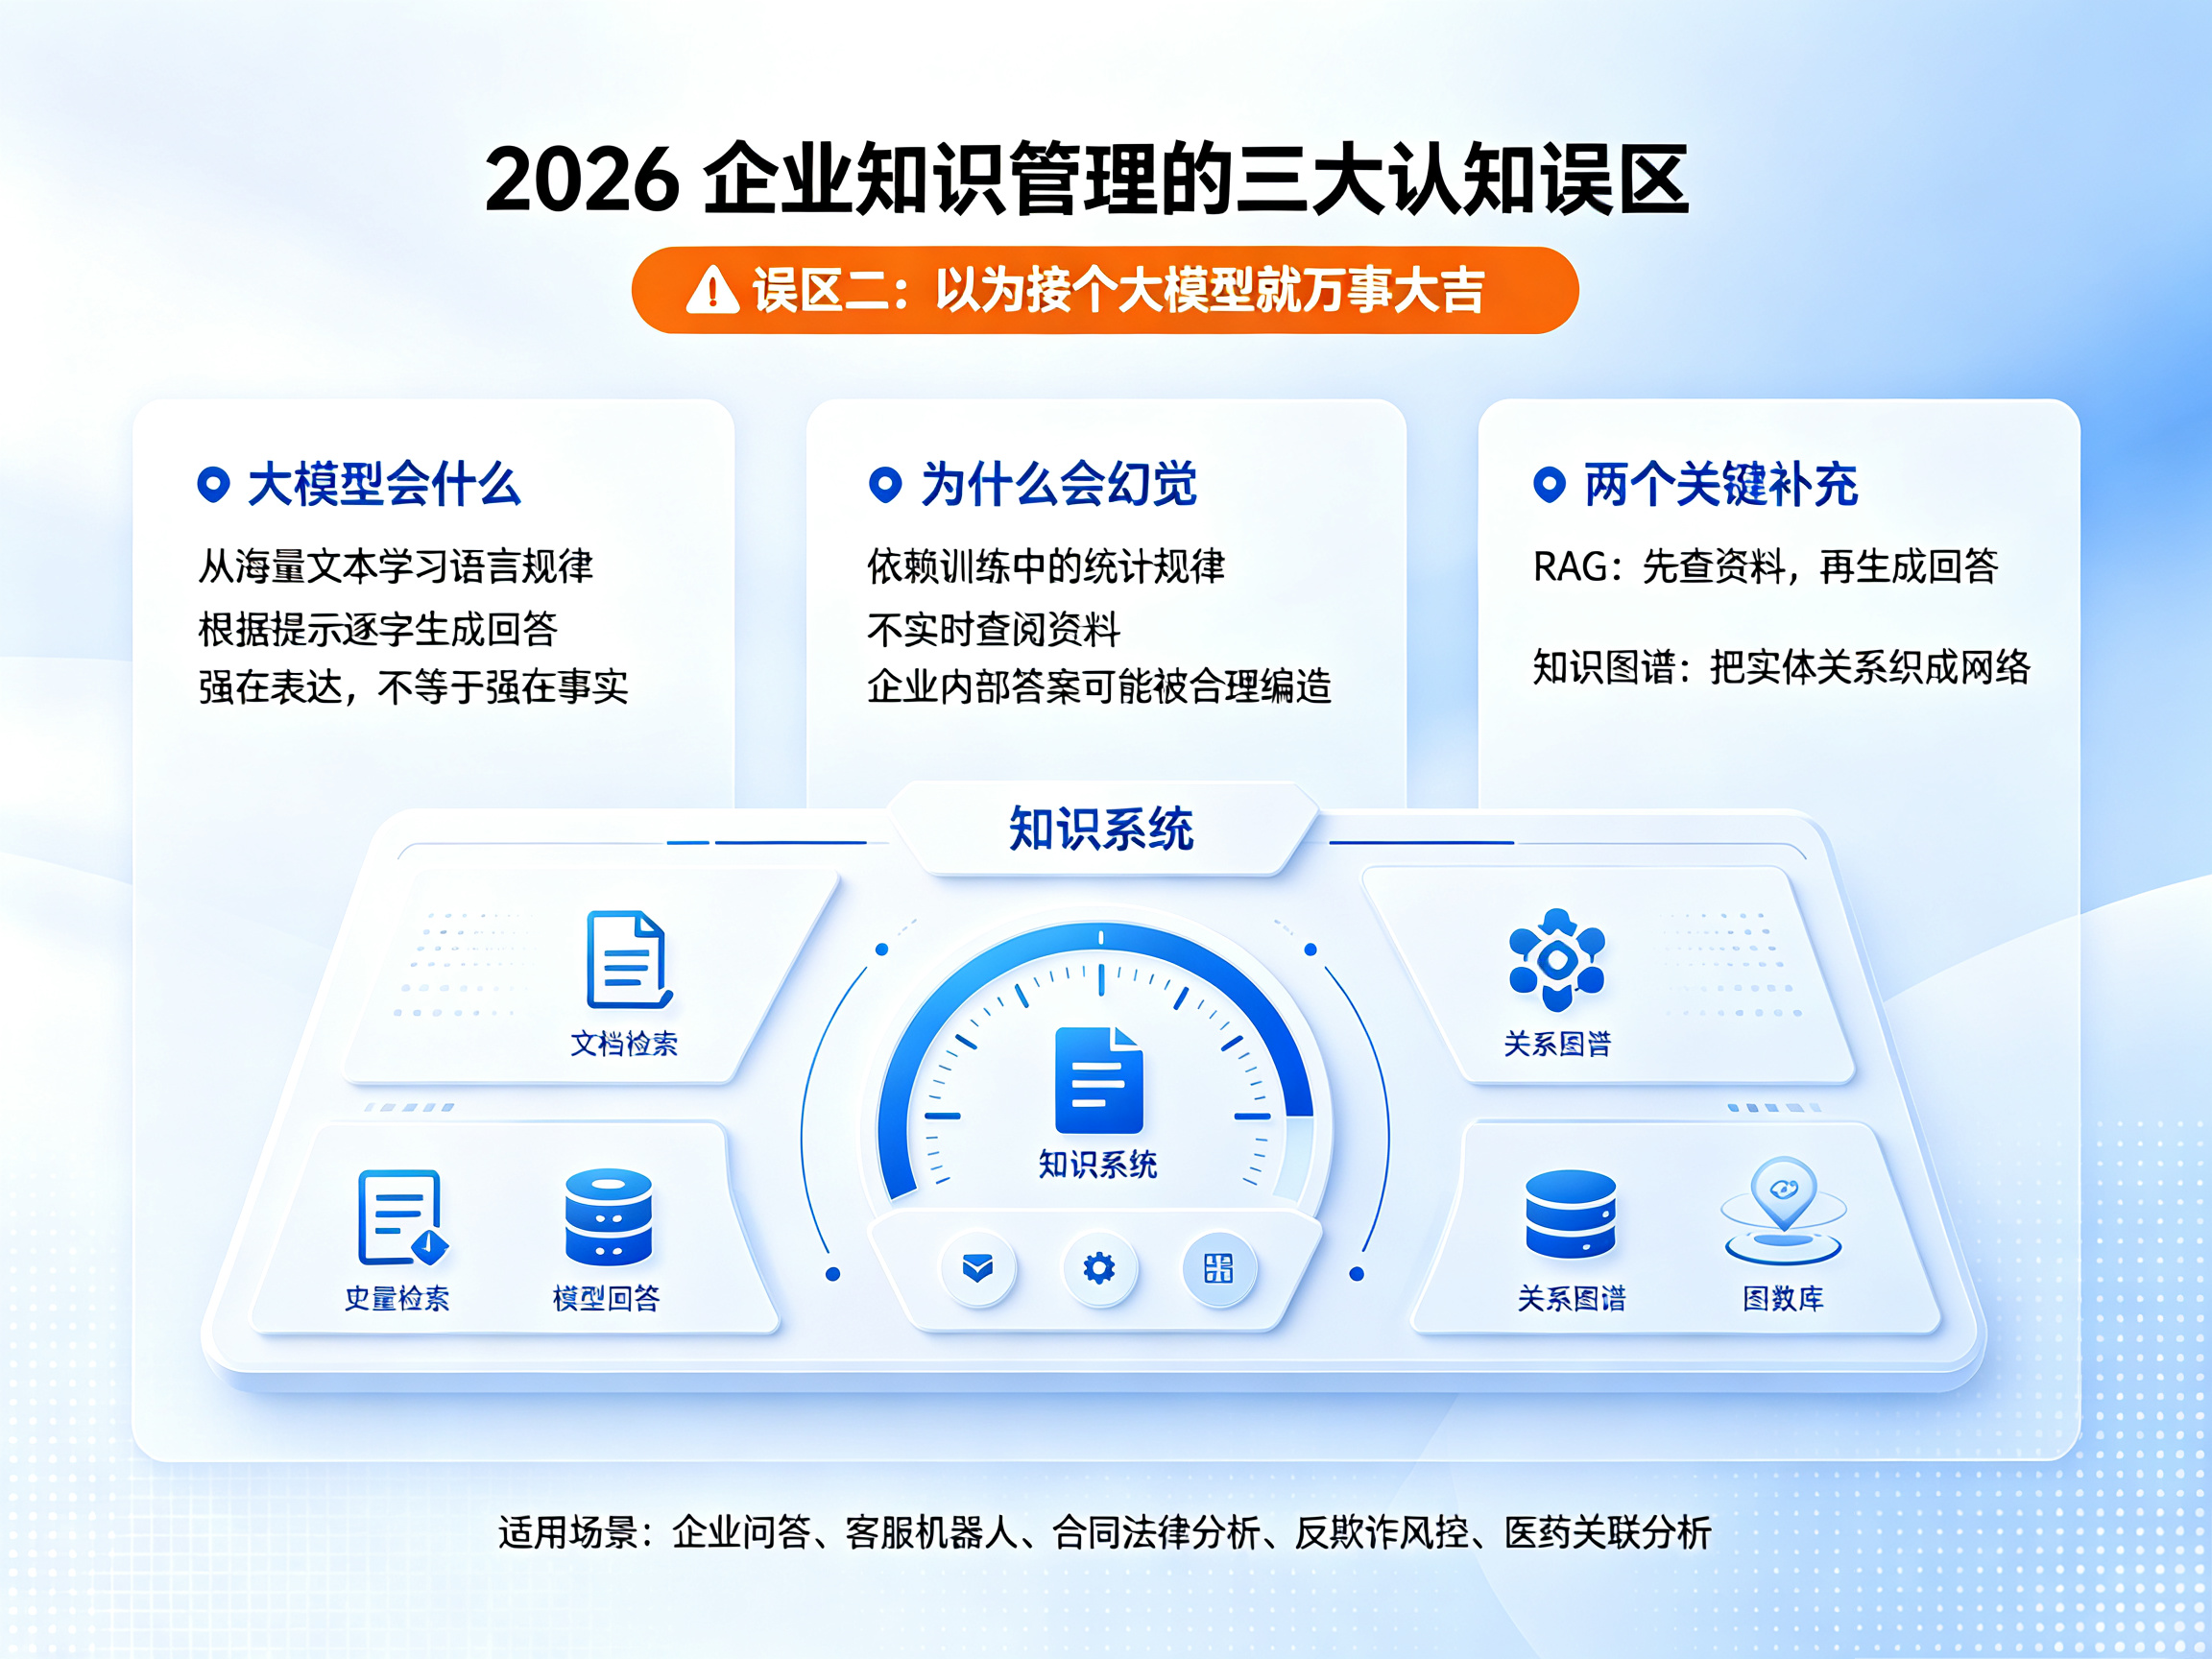
误区二:以为接个大模型就万事大吉
大模型的工作机制,是从海量文本里学习语言规律,再根据提示逐字生成回答。它擅长组织语言,却不擅长保证事实准确,因为它依赖的是训练阶段记住的统计规律,而非实时查阅资料。当被问到企业内部的具体问题时,模型容易生成听起来合理、实际却错误的内容,这种现象叫做"幻觉"。
为降低部分回答偏离资料的风险,业界发展出"检索增强生成"的思路。它的执行顺序是先查后答:系统先根据用户问题在知识库里检索相关片段,再把这些片段作为依据交给大模型,要求它基于给定材料作答。RAG 这个名称指的就是"先检索、再生成"的这套组合。它的应用包括企业内问答、客服机器人、合同与法律文档分析等,RAG 可用于企业问答、客服、合同文档分析等需要引用资料的场景之一;是否适用需结合数据质量、权限和准确性要求评估。
仅靠检索还不够。许多业务问题的答案藏在实体之间的关系里,比如"某产品的核心零部件供应商是谁""某个项目的负责团队归属哪条业务线"。这类问题需要先把人物、组织、产品、地点等实体从文本中抽出来,再识别它们之间的关联,最终构成一张可查询的关系网络,也就是知识图谱。图谱的底层依赖图数据库,图数据库适合处理关联关系较多的查询;实际查询性能取决于图谱质量、数据规模和部署配置。知识图谱的应用不止于企业问答,还出现在反欺诈风控、智能客服、医药研发中的分子关联分析等领域。
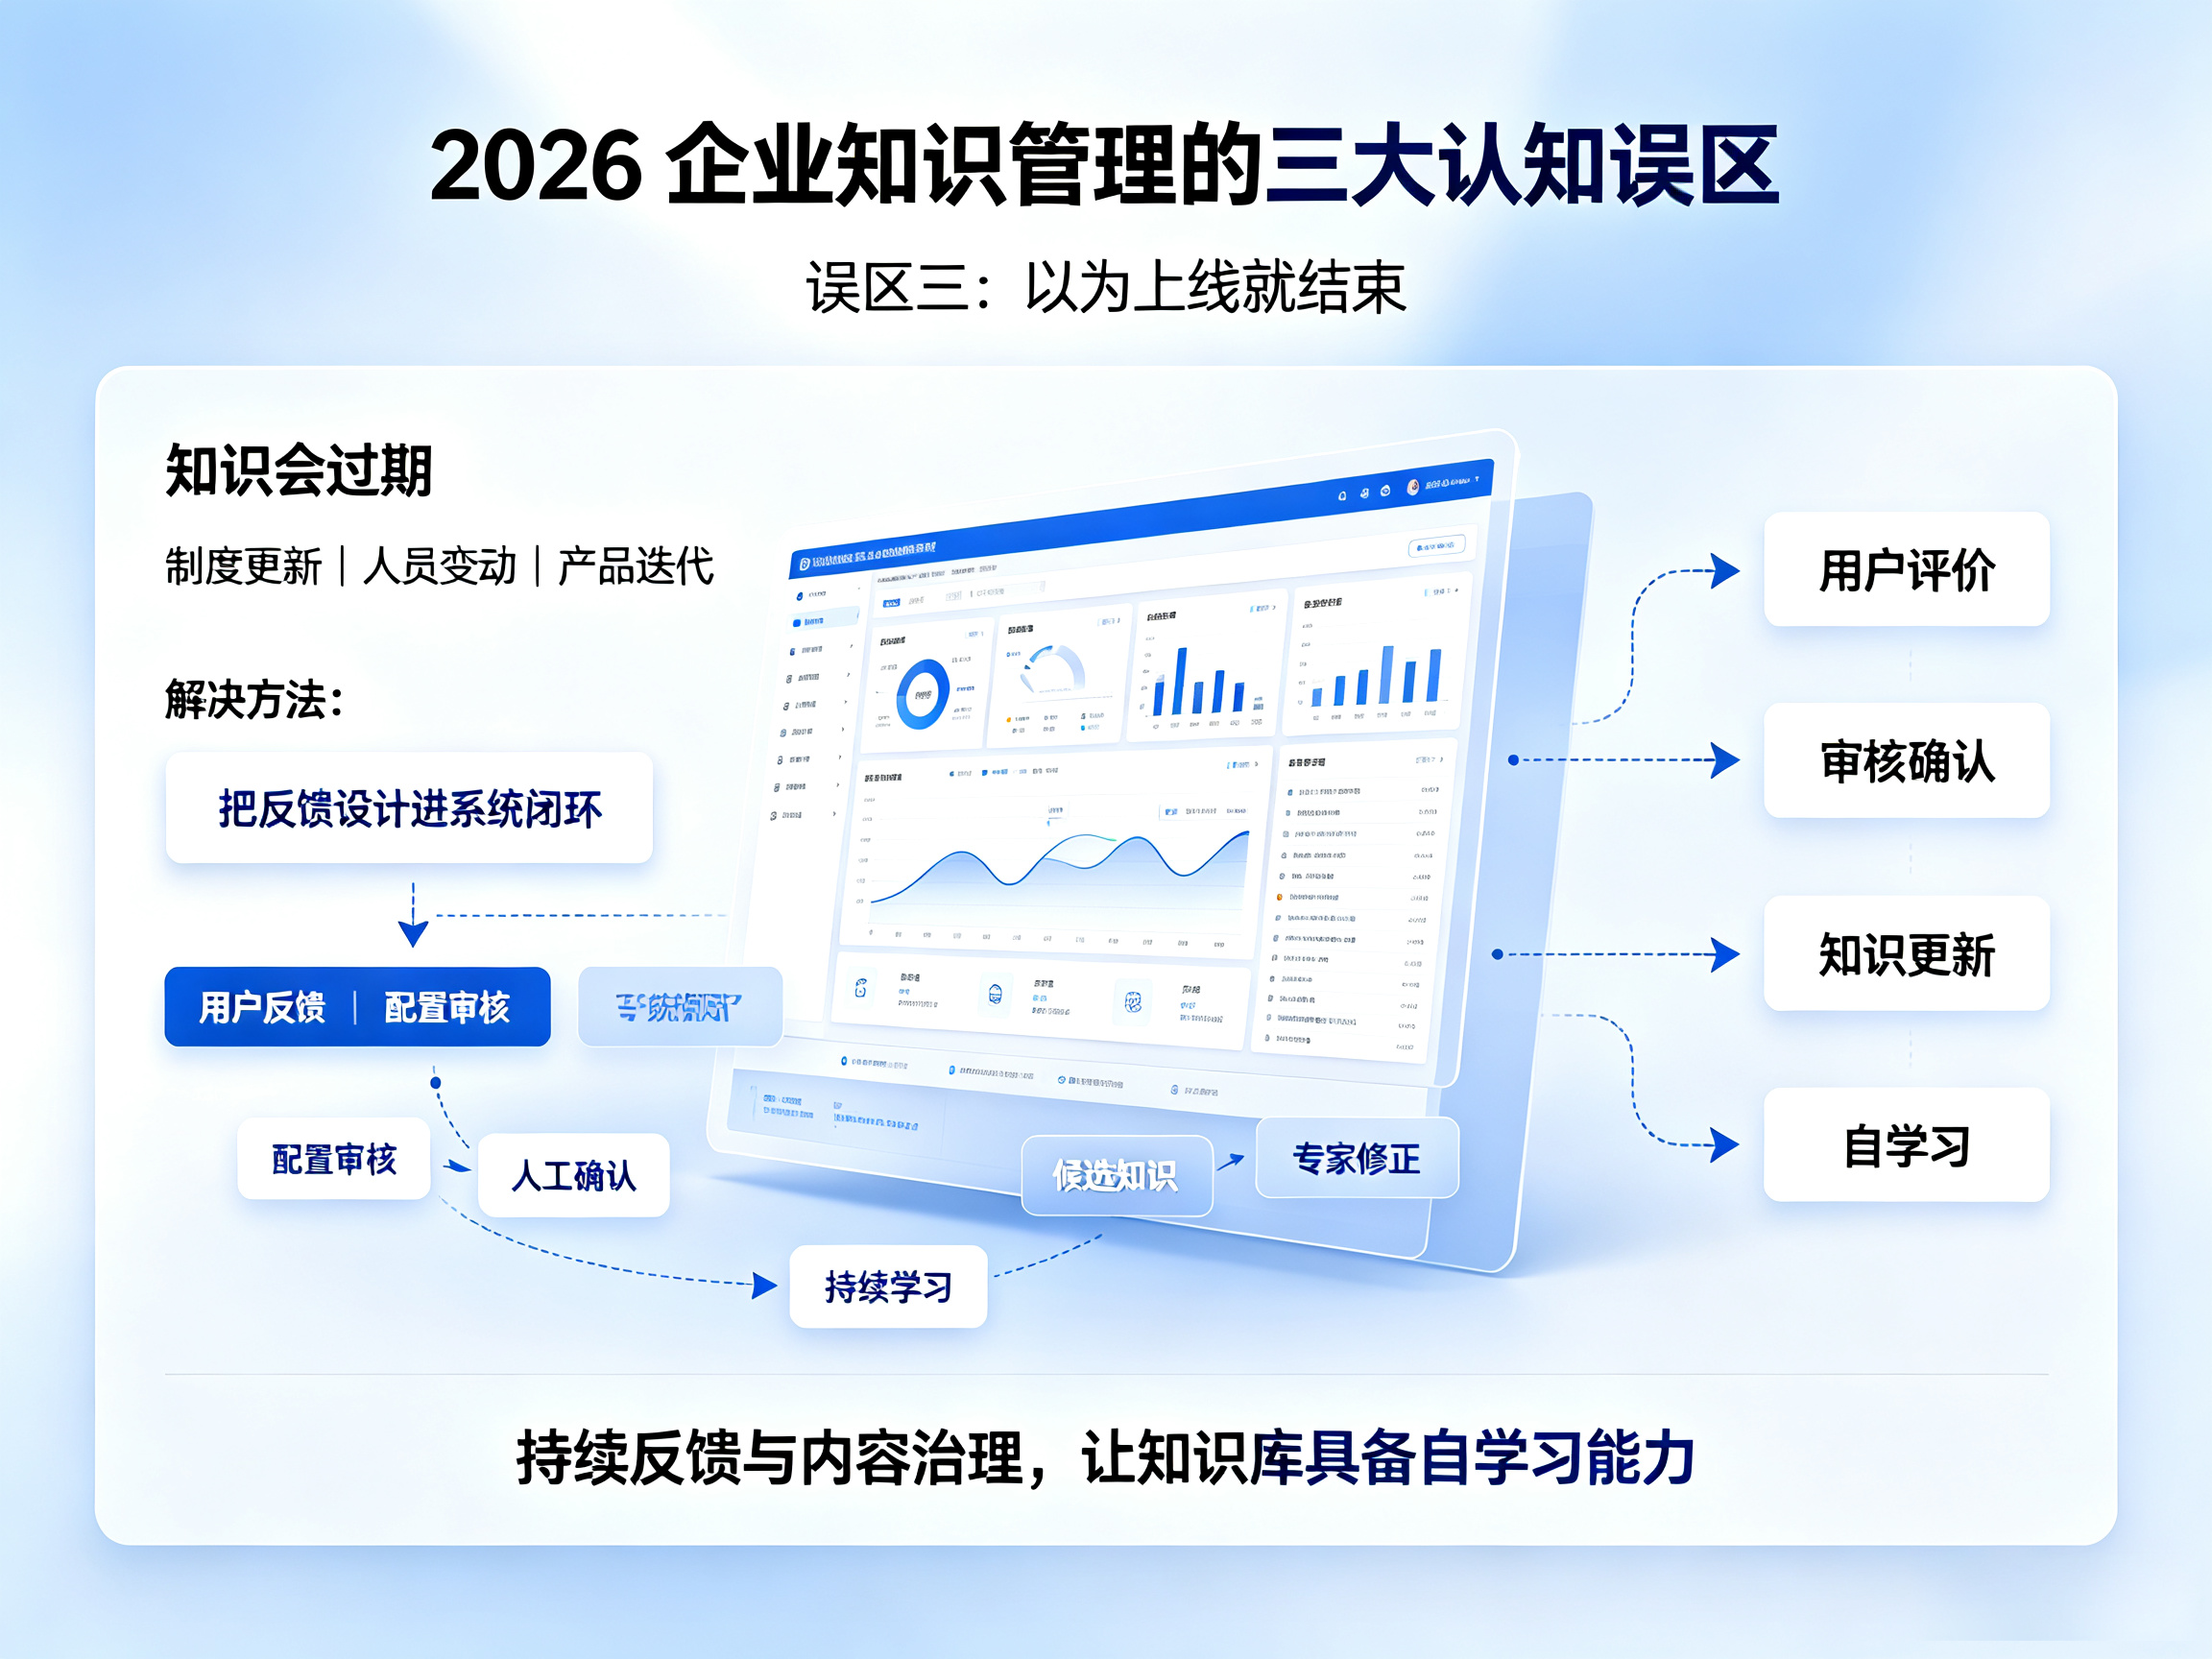
误区三:以为上线就结束
知识会过期。制度更新、人员变动、产品迭代,都会让半年前入库的内容失去准确性。若缺少内容更新与质量治理,过期资料可能增加回答偏差风险。
解决办法是把"反馈"设计进系统运转的闭环。用户在收到回答后可以标记满意或不满意,系统可收集用户反馈,并在配置审核规则或人工确认后,将部分优质问答转化为候选知识条目,对错误回答则支持专家人工修正并纳入后续学习。这套机制让知识库具备自我更新能力,也就是自学习。它持续反馈与内容治理有助于维护知识库质量,实际效果取决于运营机制、审核资源和数据更新频率。在客服质检、内容审核等需要持续校准的场景里,同样的反馈闭环思路也被广泛采用。
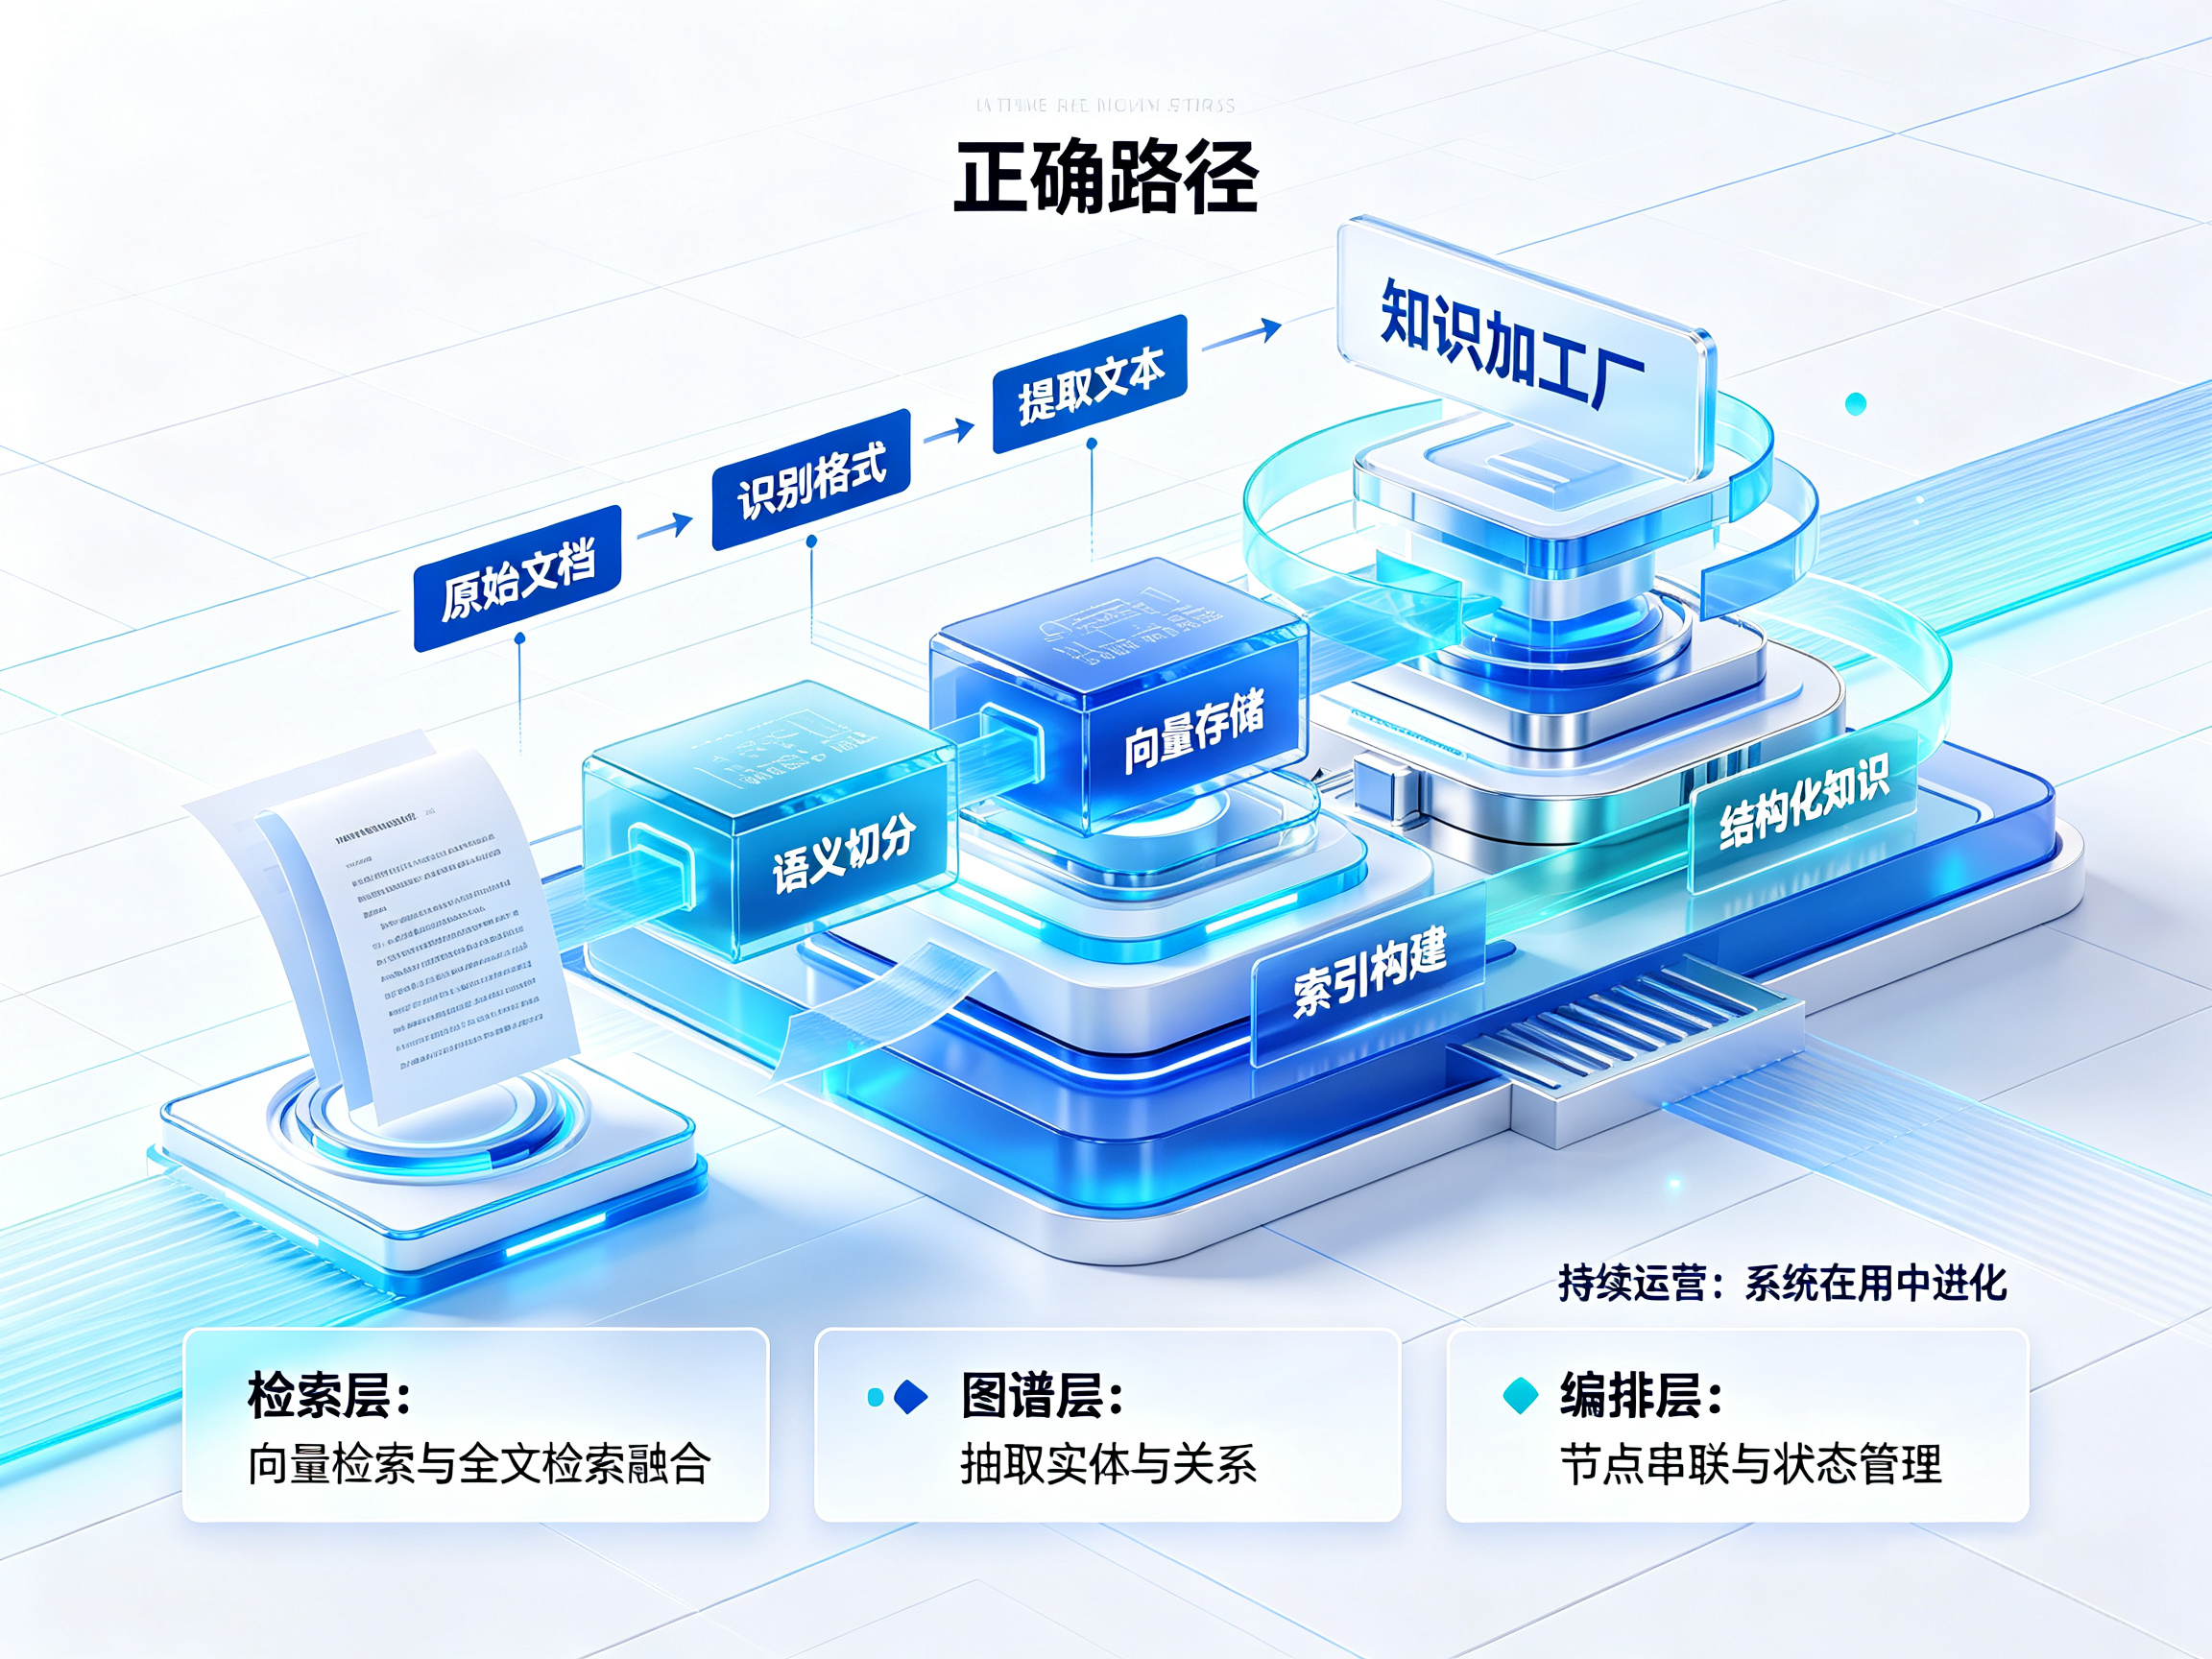
正确路径
避开三大误区,需要以加工和治理思维建设知识库。
加工厂思维要求系统对原始文档做多环节处理:识别格式、提取文本、按语义切分成独立片段、转成向量存入专用库、构建索引。每一步都用于提升材料的可检索性和可管理性,最终产出的是能被检索、能被引用的结构化知识。
工程化能力由三部分支撑。其一,检索层融合向量检索与全文检索,混合检索可结合关键词与语义信号,结果质量应通过业务语料和评测指标验证。其二,图谱层抽取实体与关系,支撑复杂关联推理。其三,编排层把多个能力节点串成自动化流程。这类自动化思路源自把任务拆成节点、用连线定义执行顺序的工作流模型,后来又引入状态机来管理 Agent 在执行中的中间状态与记忆(如 LangGraph 所做的)。编排层支持条件分支、状态传递和并行执行,可将下载、摘要、提取和邮件发送等步骤编排为自动化流程;具体执行仍受权限、接口、异常处理和人工审核要求约束。
持续运营可结合反馈闭环,支持知识库持续优化。
小艾智能体的实践启示
小艾智能体的架构在架构设计中对前述问题设置了相应处理环节。它把文档处理拆成识别、解析、语义切分、向量化、索引构建的覆盖文档识别、解析、切分、索引等流程,减少原始文档直接入库带来的治理问题。技术底座选用 FastAPI 加 Python 构建应用框架,LangGraph 承载 Agent 工作流的状态流转与记忆,DeepSeek、GPT-4、智谱 AI 等当前版本支持接入产品清单所列模型;新增模型或切换需结合接口、授权和测试确认;向量库采用 Milvus,图数据库采用 Neo4j,全文检索采用 Elasticsearch,消息流转通过 RabbitMQ,热点数据缓存使用 Redis。方案可提供检索、图谱与工作流编排相关模块,具体组件和能力以产品版本、部署方案及交付清单为准.
在持续运营一侧,小艾内置反馈收集、知识候选条目转换、人工修正工作流和质量评分标签,形成自学习闭环。它把知识库定位为持续运转的系统:文档经加工成为结构化知识,Agent 工作流把知识转化为支持业务流程联动,反馈又持续为知识库优化提供反馈。该架构针对内容处理、检索、反馈运营等环节提供相应能力,有助于为部分项目风险管理提供支持。
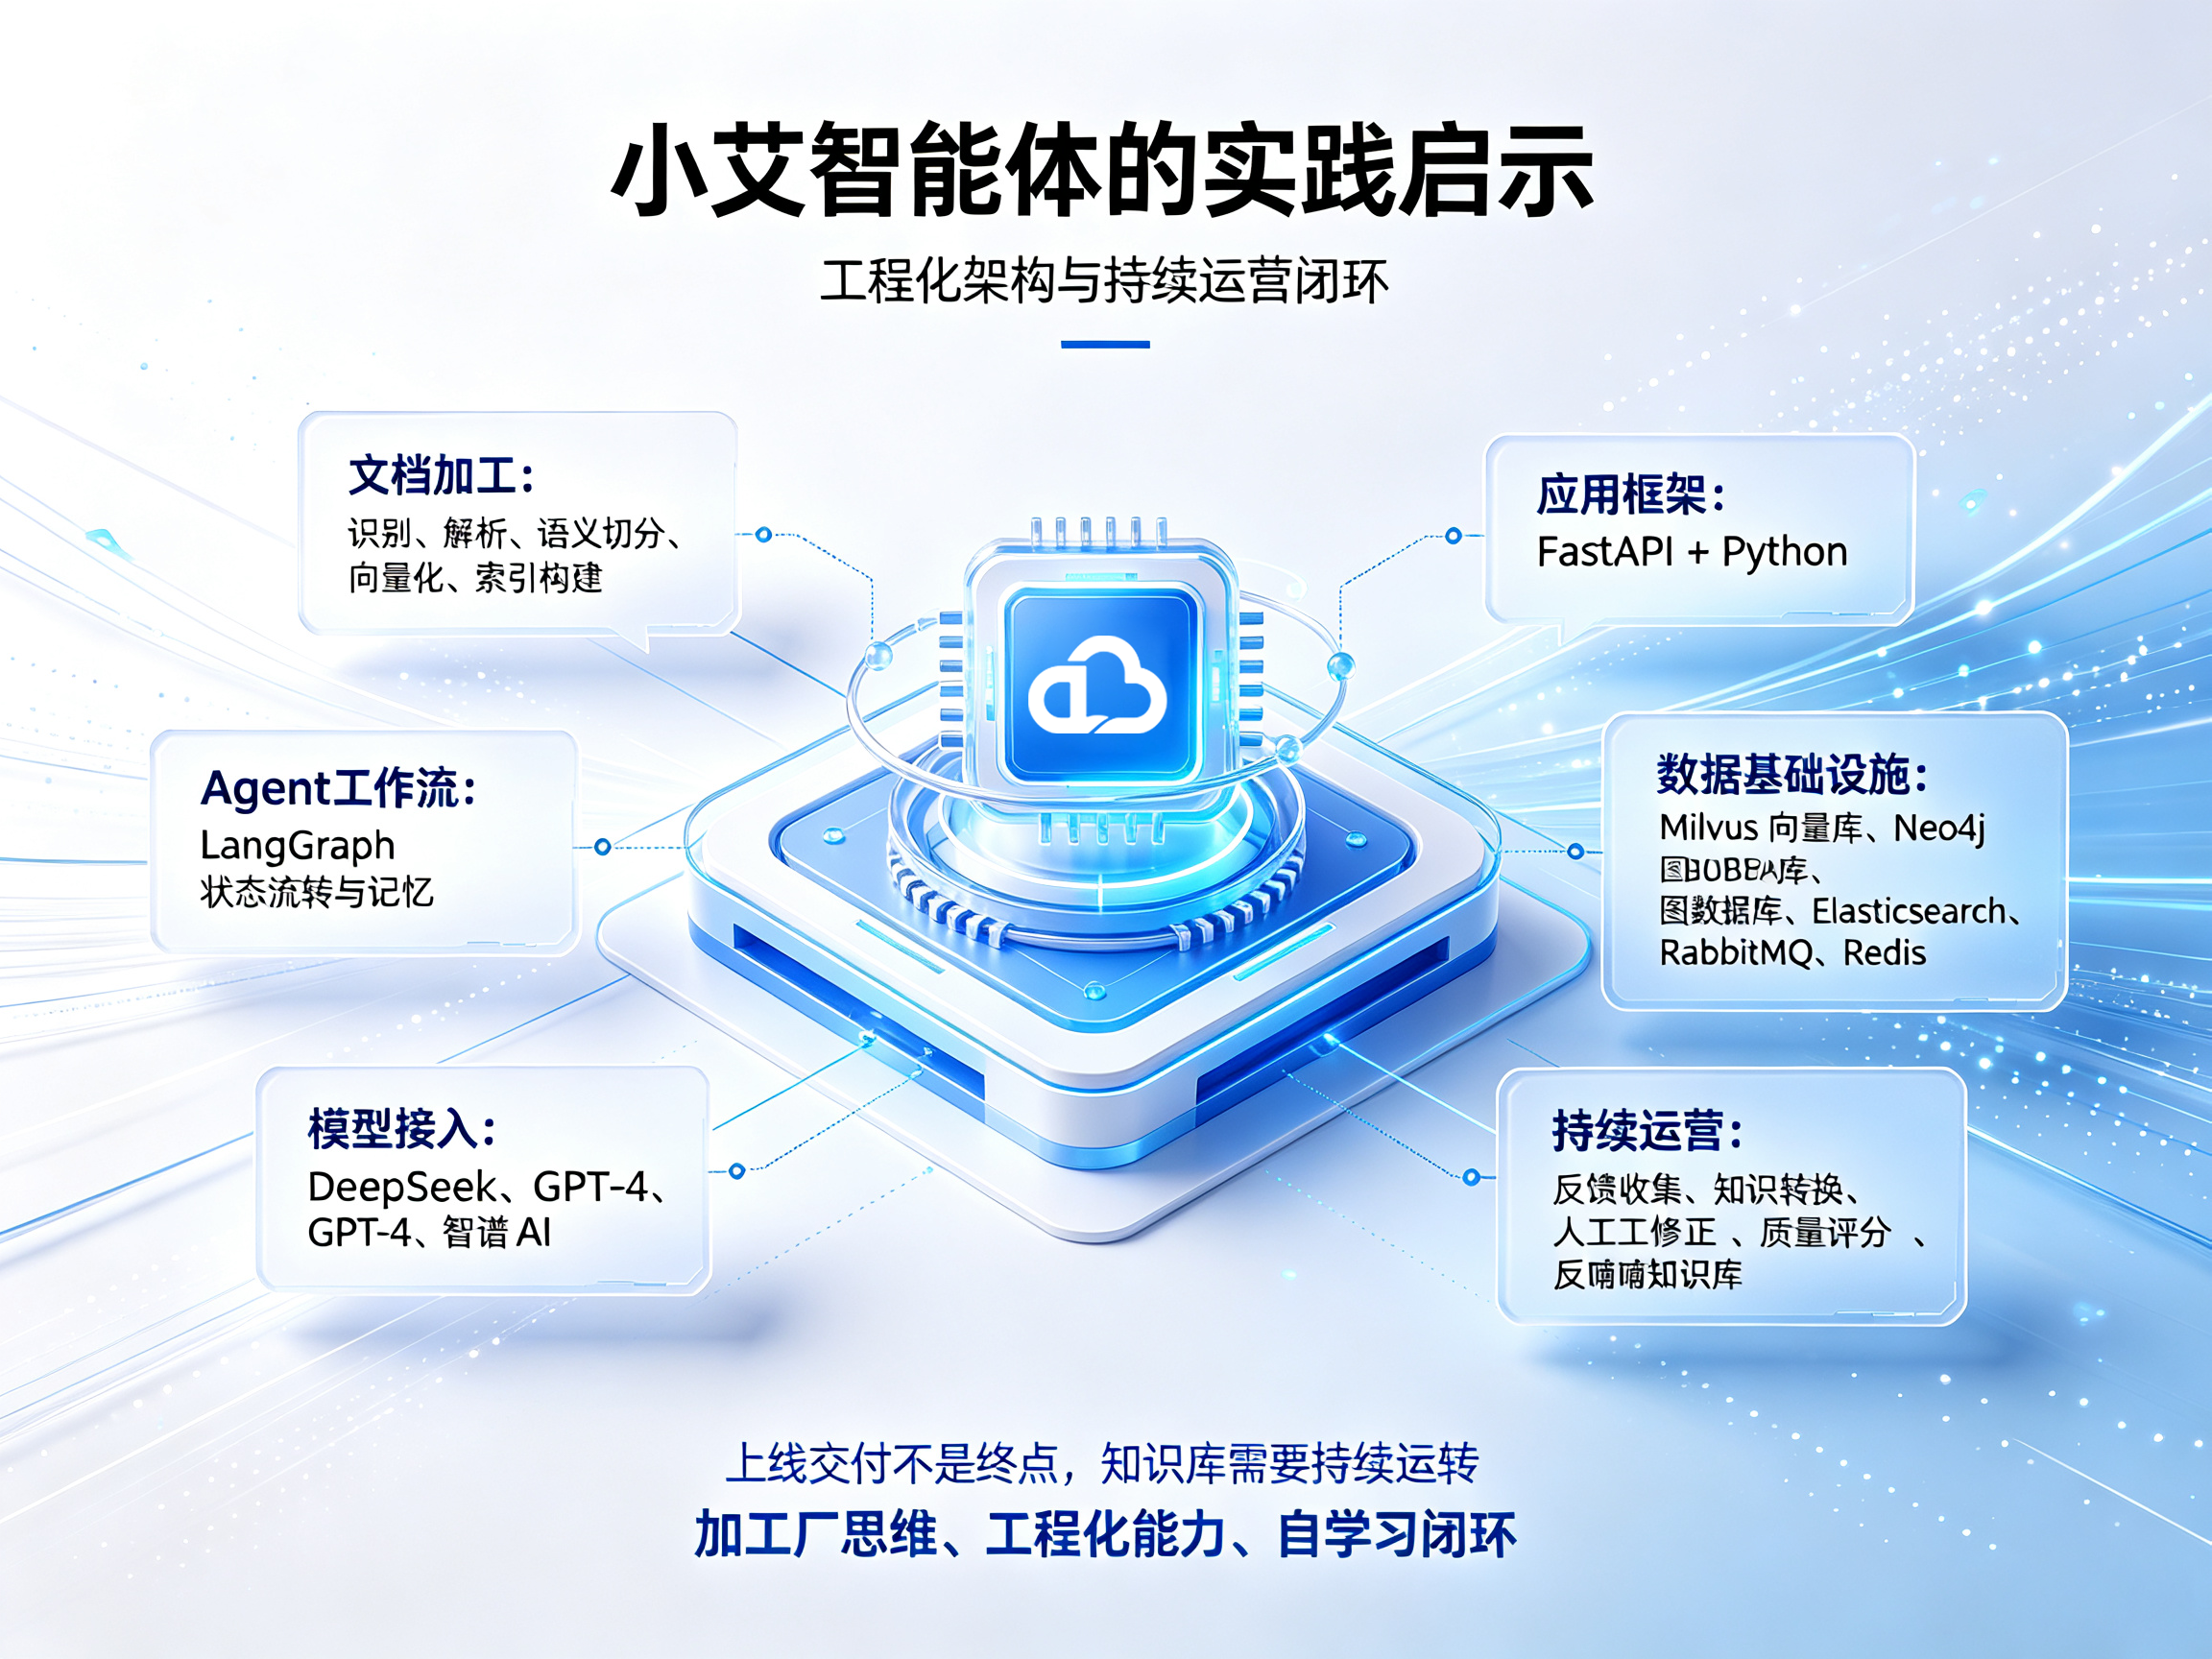
把文档堆进去并不等于拥有了知识。单独接一个大模型,回答依旧不可靠。上线交付也不是项目的终点。AI 知识库能否用起来,七分在方法论,三分在工具。加工厂思维、工程化能力和持续运营闭环,这三类要素通常值得在知识库项目中重点评估。