
 立即咨询
闭源大模型 VS 开源大模型,企业私有化部署到底该怎么选?
企业做私有化部署,重要关口之一是闭源还是开源?不同模型在能力、部署方式、数据处理规则和适用场景上存在差异,应结合测试结果与服务协议评估。闭源与开源各有所长,选型看业务匹配度。涉及核心数据或较高合规要求时,可优先评估本地化或专有环境部署方案,并结合数据分类分级、合同条款和安全评估确定。“对生成质量要求较高、经合规评估允许外部调用的环节,可评估闭源模型作为补充。
大模型的来龙去脉
大模型的源头是统计语言模型,靠词频统计去猜下一个词。神经网络后来接手,用堆叠的参数去拟合语言规律。注意力机制的出现是关键转折,它让模型一次性读完整个句子,长距离的依赖关系不再断掉。先在海量文本里把通用语言能力练出来,再针对任务做二次调整,这条先广后专的路径延续至今。模型把语言、知识和推理压进上亿参数,人用自然语言就能驱动它。参数规模越过某个阈值后,模型还会冒出没被专门训练过也能处理新任务的表现,行内叫涌现能力。
闭源与开源的分水岭
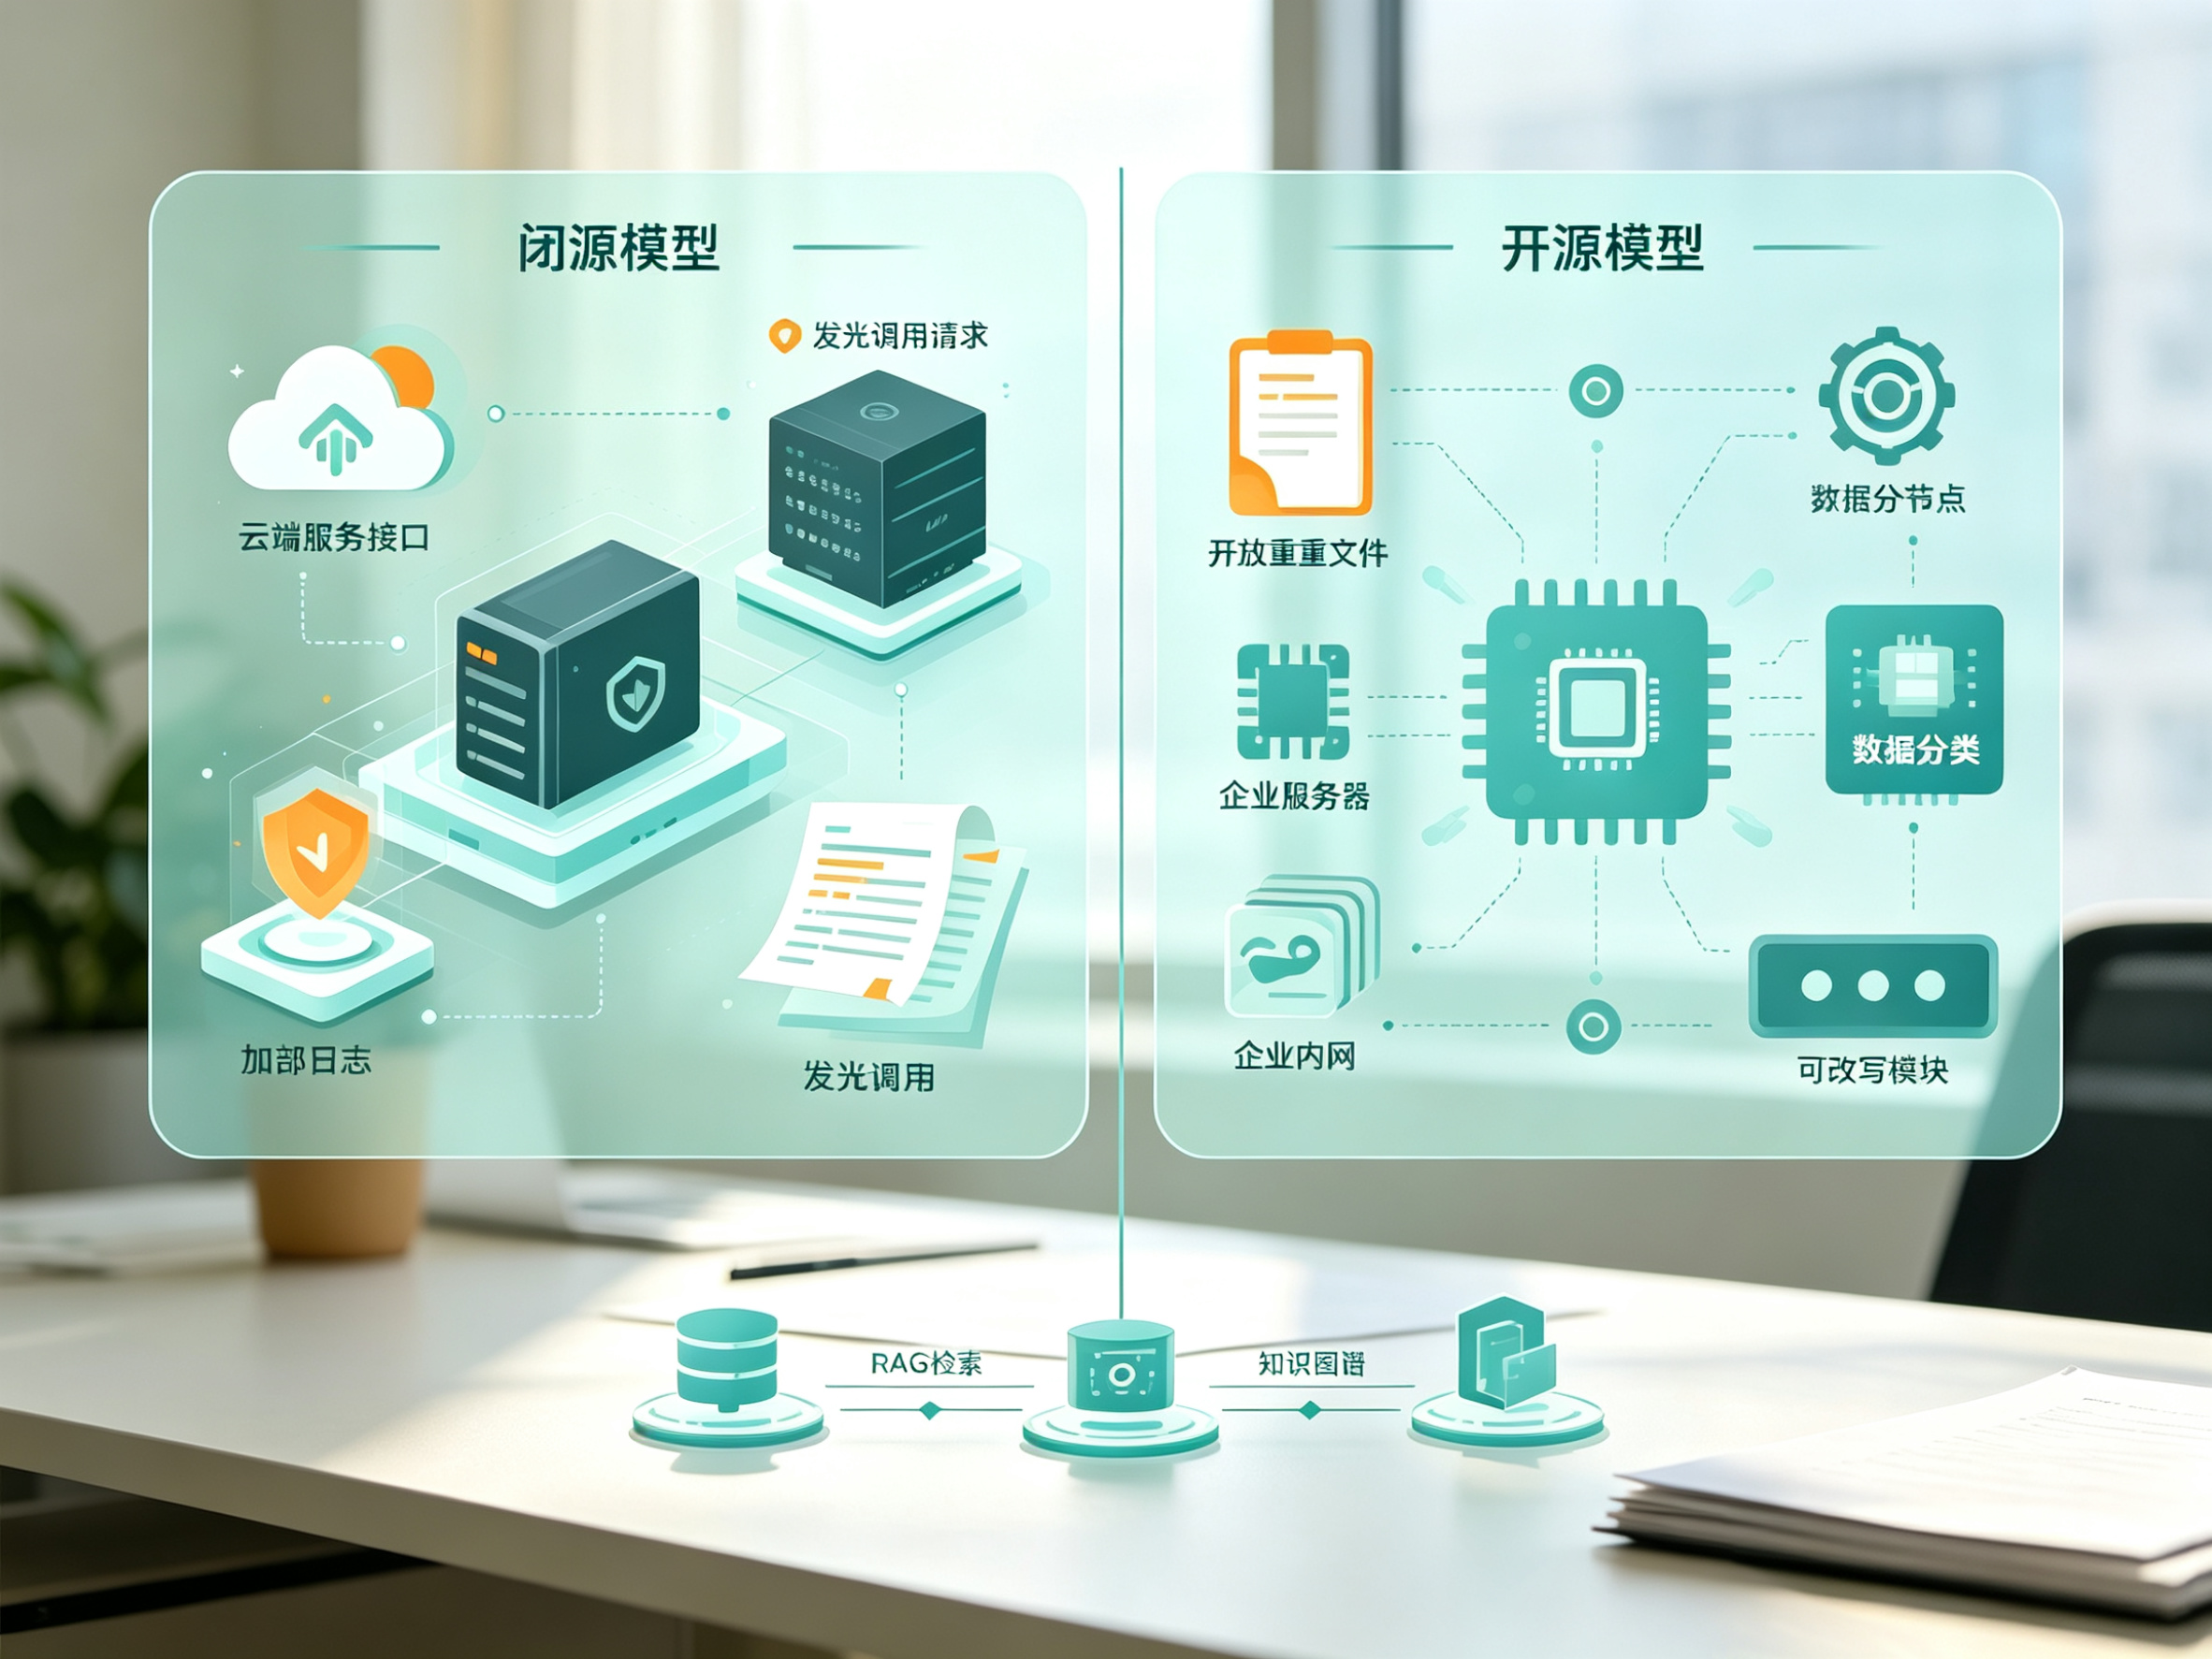
闭源和开源的划分,本就是软件世界老问题的新表现。早年软件按源码是否公开站队,公开源码的任人查看改写,不公开的只发编译好的程序。大模型把这道线移到了权重上。闭源模型通常以服务接口形式提供能力,调用走接口,内部参数对外不可见。开源模型把权重一并放出,企业能拖回自己机器跑。前者运维负担相对较低,后者对企业技术治理能力要求更高。
部分闭源模型在开放式写作、复杂推理或跨语言任务中可能表现较好(建议以目标业务测试结果为准),围绕它的检索、插件、评测工具链也相当完整。对效果要求高、数据敏感度低、合规允许外传的业务,在接口、数据及合规条件具备时,托管服务可能减少部分基础设施建设工作;实际周期取决于集成、测试与审批流程。使用外部模型服务前,应核查服务商的数据处理协议、日志留存策略、地域、训练使用规则和退出机制。闭源服务通常按调用量或套餐计费;成本应结合模型单价、调用规模、并发需求和运维投入测算。
开源和国产模型把运行权还给企业。部分模型可在企业内网或专有环境部署。数据是否出域取决于网络策略、外部接口、运维方式及实际配置,并应通过验收确认。完成部署后,单次调用不再直接按外部 API 计费,但仍需计入算力、能源、运维、存储及升级等持续成本。微调是它一项硬核能力:帮助模型更好适配企业话术与判断口径。微调最早的做法是冻住主体、只动输出层,后来演进为用少量样本全局微调。金融、医疗、制造等行业可能面临更严格的数据、安全或行业监管要求;是否必须本地化,应以具体业务、数据类型和适用规定为准。它在部分尖端任务上和成熟闭源模型还有距离,不过这个差距正快速缩小。但差距缩小不代表可以松懈。
数据安全与合规
私有化部署的根源,是企业不愿把核心数据交出去的本能。早先是自建机房加物理隔离,后来进化为私有云,算力也收归内部。大模型阶段,这条线凝成数据不出域原则。凡是碰客户隐私、产线工艺、财务账目的场景,数据出域后,企业对其后续处理的控制与审计难度可能增加,因此应事先明确处理目的、范围、留存期限和责任边界。在关闭外部调用、日志回传及远程运维等通道,并完成相应配置的情况下,相关数据可按策略保留在企业环境内。内网运行通常更有利于开展审计、留痕和权限管理。结果,强监管行业应优先评估本地化、专有云等部署方式;最终方案需结合适用法律、监管要求与企业内部制度确定。
成本与可控
账要分两头算。闭源按调用次数或token计价,外部服务成本通常随调用量变化;自部署方案的单位成本会随使用规模变化。建议按预计调用量、硬件、运维与使用年限进行 TCO 测算。可控性的落差更明显。托管服务的模型升级与价格策略通常由服务商制定,企业可通过合同、版本管理及多供应商预案降低影响。开源方案通常给企业更多版本管理和演进节奏控制空间。想长期把AI做成核心生产力的企业,这种自主权本身就是资产。
兼容架构与热切换
检索增强生成,业内简称RAG,脱胎于信息检索,系统先从资料库捞相关片段,再交给模型组织成答案。RAG 可为回答提供相关资料片段与引用依据,但不能保证内容完全准确;仍需进行检索质量评测、引用校验和人工复核。检索背后站着向量数据库,它的诞生是因为传统数据库只认精确匹配,碰到语义相近但措辞不同的查询就抓瞎。向量库把文字译成一串数字,用距离衡量意思亲疏,相近的内容自然聚拢。库里常用IVF_FLAT和HNSW两类索引,前者省内存,后者查得快,数据规模决定选哪个。混合检索可结合语义与关键词匹配,其效果应通过企业语料、查询集和统一指标进行评测。
为什么非得让多种模型都插得进来?因为真实业务不会只提一种难度的需求。日常问答用开源保数据,偶发的复杂创作临时切闭源拔效果,理想情况下,模型切换应尽量减少对业务代码的影响。在统一接口、兼容适配和充分测试的前提下,系统可支持部分模型切换;是否需要重启及迁移成本取决于部署架构、会话状态和模型能力差异。
知识图谱从语义网络演化而来,用节点和连线表达概念间关系。大模型时代,系统可辅助抽取实体与关系、构建图谱候选结果;实体消歧、关系校验和推理结果应结合规则或人工审核。
小艾智能体的落地形态
小艾智能体在约定版本和部署方案下,可提供接口网关、检索、向量库、图数据库等组件的私有化部署选项;数据处理边界以架构配置及合同约定为准。模型接入上,它支持接入产品清单所列的模型;新增模型或迁移需视接口、授权、数据格式及适配工作量评估。可提供文档处理、知识图谱、Agent 编排等模块;常见流程可通过配置实现,复杂接口、规则或权限场景可能需要实施服务或二次开发。
闭源和开源是可组合的两套能力,企业可评估将两类能力组合使用。核心数据、强合规、要长期自主的,本地化开源或国产模型做底座。效果要求极高且合规放行的环节,闭源作补充。一种可考虑的做法,是让架构撑住多模型并存与灵活切换,企业按自身业务和合规要求去拼组合。