
 立即咨询
自学习闭环架构设计:从用户反馈到知识自动入库的工程链路
还在把企业知识库当成一个只进不出、一成不变的静态仓库吗?这种观念已经过时了!
很多团队刚上 RAG 的时候都挺兴奋:把文档切一切,丢进向量库,接个大模型,问答就能跑起来。可过两个月就发现,它的回答没有更新,新出的产品参数它漏了,上个月改过的流程它还在搬旧版本。
这背后的矛盾很清楚:企业的信息每天都在涨,规则每周都在改,但不少知识系统仍偏一次性建设,建完就定型,用得越久越脱节。
业务天天变,系统怎么越用越聪明?
传统知识库是人在前面维护,系统在后面检索,中间缺了反馈,也缺了生长。你往里放什么,它才能答什么。
可放错了或者放旧了,它就会一本正经地把错的东西讲给你听。理想状态下,用户在系统里的每一个动作,都是一次给系统补课的机会。
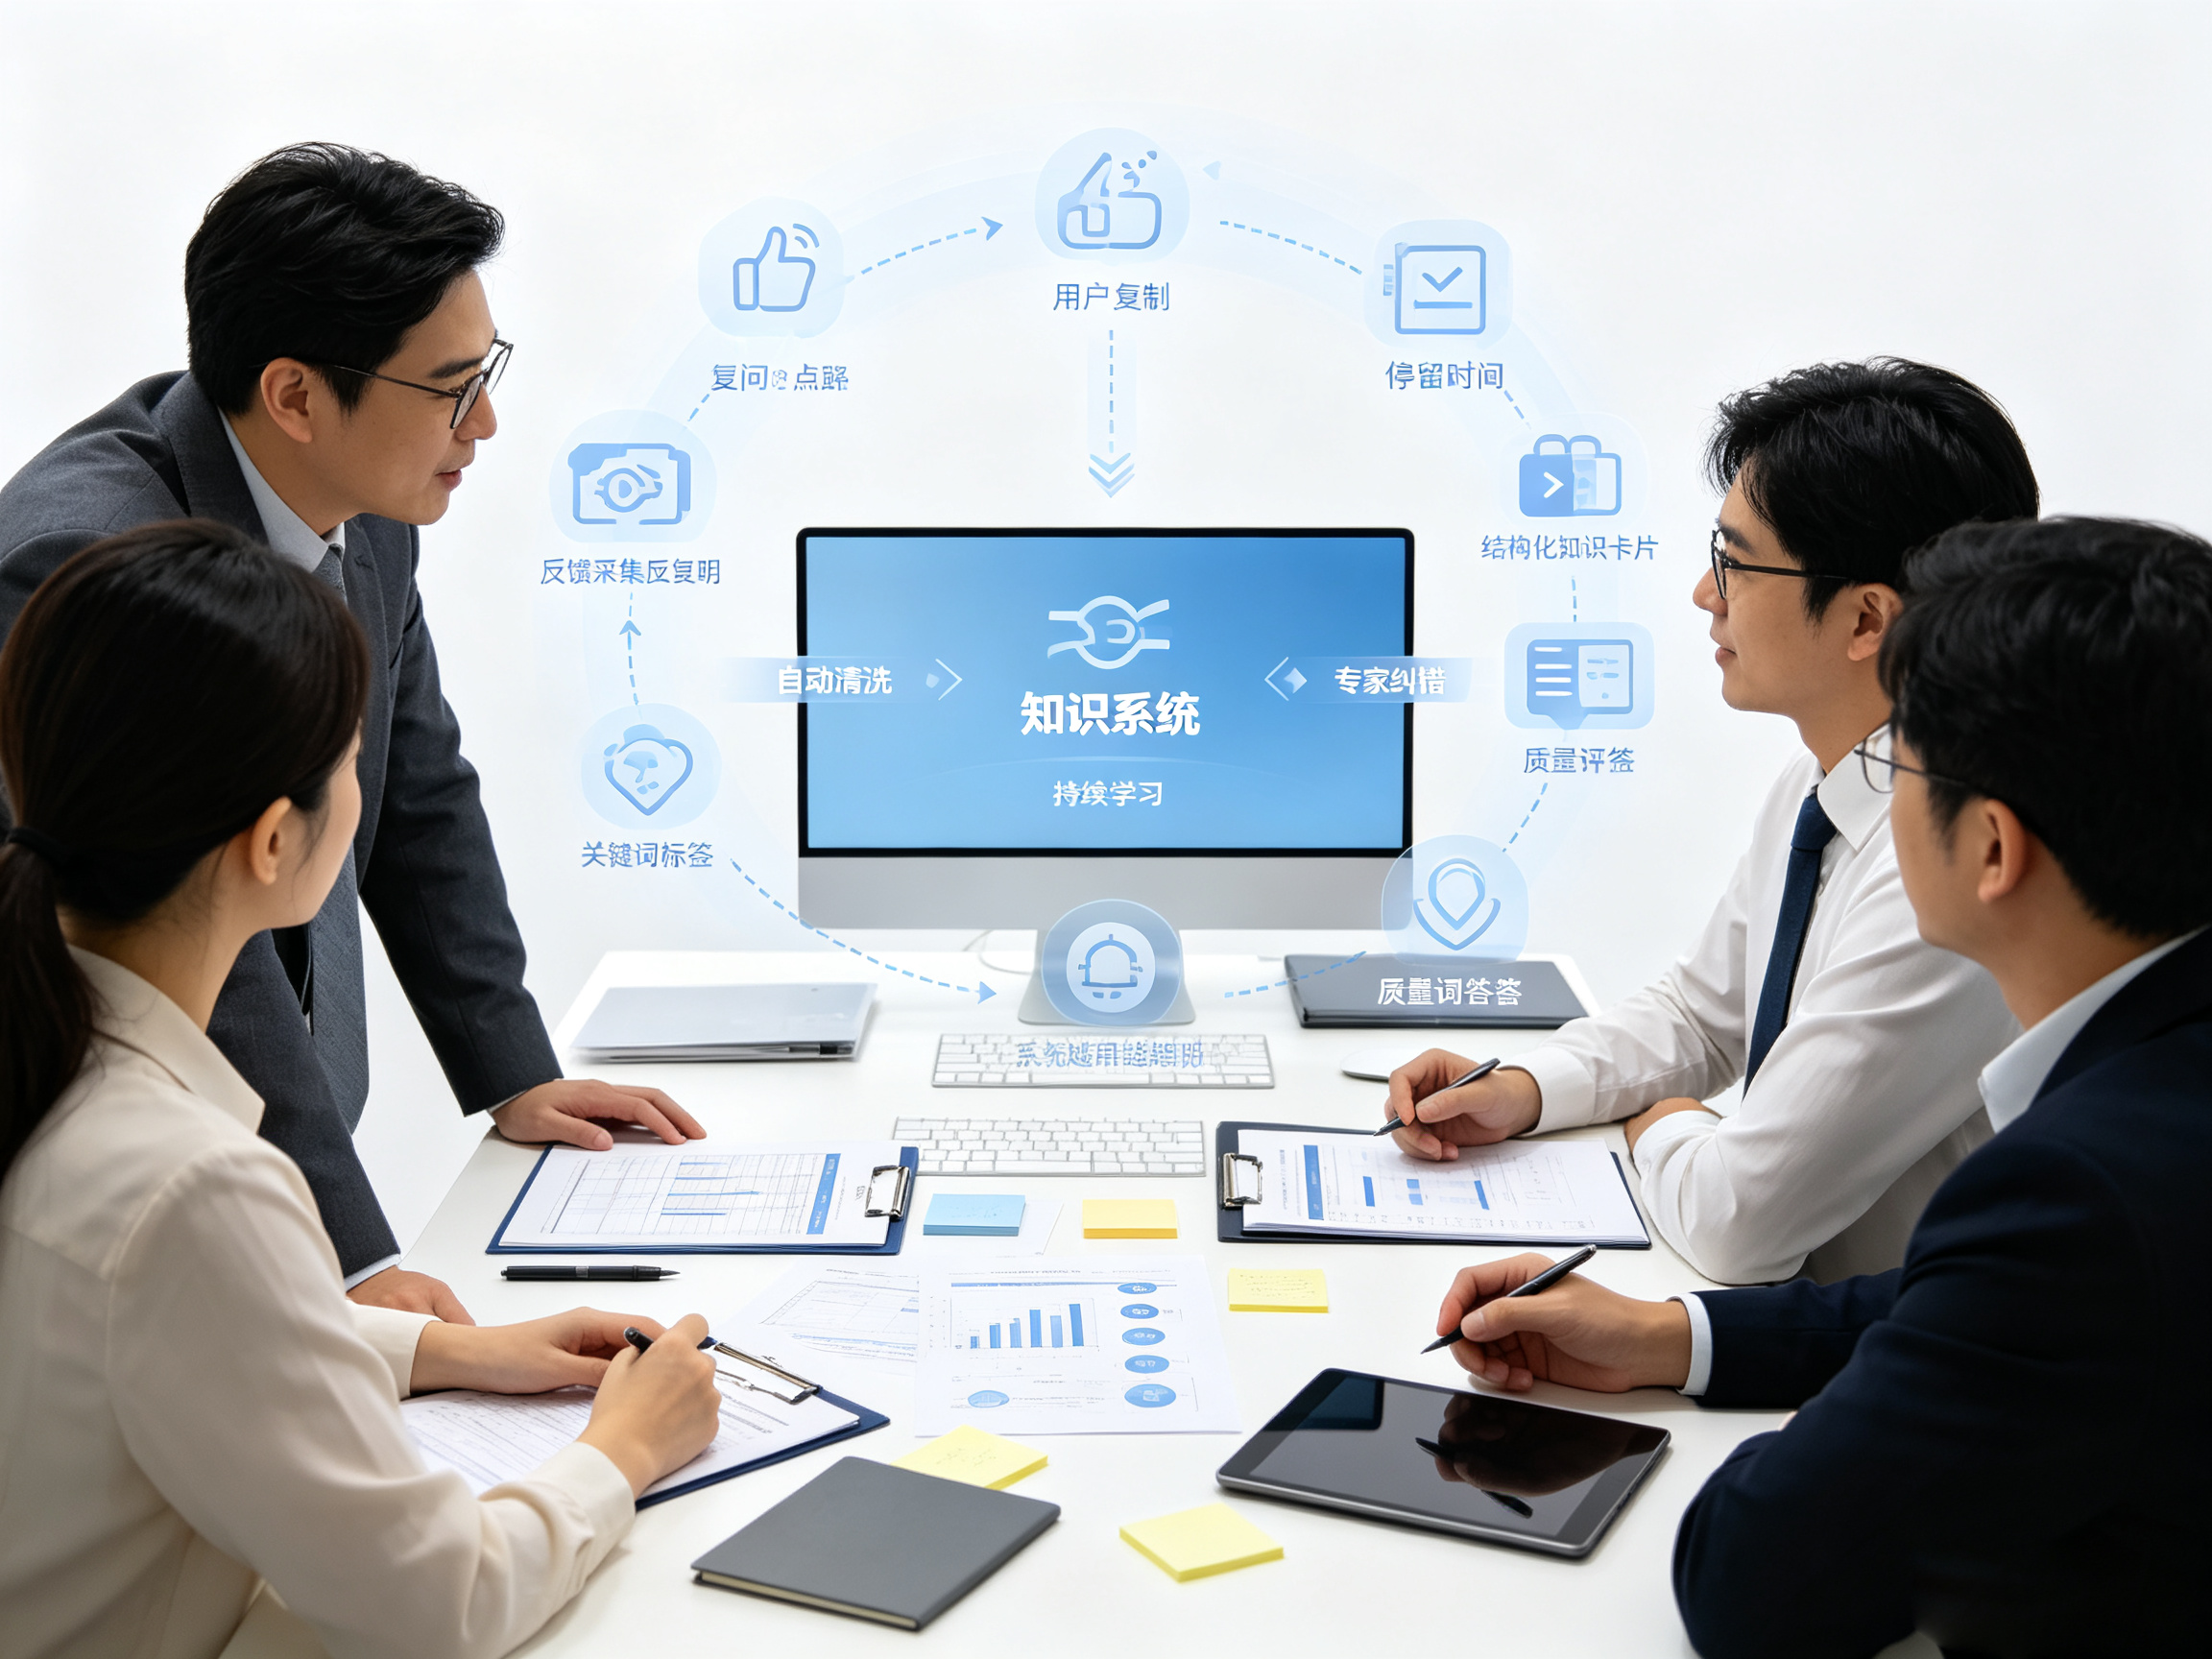
反馈信号采集:点赞、点踩如何实时进入优化回路
要让系统持续进化,第一步是先把“用户的反馈”收进来。
最简单的方式就是点赞和点踩。用户觉得答得好,点个赞;觉得答偏了或者答错了,点个踩。这俩动作看着简单,却是系统判断这条知识价值的原始依据。除了一赞一踩,还可以采集更细的信号:用户是否继续追问、是否复制答案、是否在页面停留较长时间,这些行为都是判断回答质量的有效信号。系统对回答质量的判断,来源于对这些行为信号的综合分析。
学习还有一个关键,在"实时"二字。反馈应尽量及时进入处理回路,降低滞后处理带来的影响,攒到月底再处理就晚了。错的答案早被一百个人看过了,你来得及改吗?
通常前端把动作发到消息队列,后端消费后写进反馈表,同时带上会话 ID、问题原文、命中的知识片段这些上下文。这样每条反馈都带着"当时发生了什么"的线索,后面做知识转换和归因时才有据可查。
反馈的存和用,是两码事。
把优质 Q&A 变成知识库的新条目
怎么让反馈沉淀成知识?
系统给每一轮问答算一个"优质度"。反复被点赞和引用、用户看一眼就走的回答,大概率是靠谱的。这类问答会被自动挑出来,经过一轮清洗和标准化,转成结构化的知识条目,把原本散在对话里的问题、答案和出处收拢到一起,再写回向量库和图数据库。
这一步的价值在于,它把"人和系统聊出来的经验"也收进了知识库。很多一线 know-how 本来只存在于老员工的口头里,现在借由一次高质量的对话,就变成了所有人都能检索到的正式知识。
听起来很美。但老员工凭什么把压箱底的东西,喂给一个他存疑的系统?知识自动入库的前提是信任,而信任是答对三回、再答错一回就崩的东西。所以转换技术好办,让业务方愿意开口才难。
专家纠错如何被纳入学习循环
自动转换可覆盖一部分标准化场景,复杂场景仍需人工校验,但模型会把参数用错版本,也会把两个部门的口径混为一谈,甚至把 A 部门的规矩直接套到 B 部门头上。系统单独做会出岔子。
人工修正工作流就是给专家留的一个入口。发现答错了,专家可以直接在系统中修正为正确版本,系统存下新答案,还把这次出错的前因后果和修正方案写进学习日志。下次再碰到相似的提问路径,Agent 编排引擎会优先参考这条修正记录,避开同一个坑。
这就形成了人机协同的节奏。系统犯的每一个错,都变成它以后少犯一个错的本钱。
可专家也要算投入产出比。你让他改一道错题,他乐意;你让他每天改五十道,他转头就去维护自己的业务了。结果所谓的人机协同,常常卡在人这一端。系统准备好了,专家忙别的事去了。
自动评级与关键词标签
知识越攒越多,新的麻烦是检索费劲、答案存疑。
每一条新进库的知识,系统会给它打个质量分。分数来自几个维度。出处越权威,基础分越高。它被真实反馈验证过的次数,也会拉高总分。跟库内其他知识对得上的条目,召回时更受信任。
与此同时,系统会用模型抽取这批知识的核心关键词,生成智能标签,比如"报销流程""GPU 型号""客户分级规则"。
标签和评分叠在一起,检索先按标签圈定范围,再在圈里挑质量分较高、排序靠前的片段,相似度退居其次。知识组织的效率上来了,回答的可信度也跟着上去。
按理说,评分越高,答案的可信度应该越高。但分是模型打的,模型自己也会看走眼。一条被自动评成高分的错误知识,比一条低分错误知识更危险。因为它会被优先推到用户面前。评分体系可能提升了召回率,但同时也可能在无形中放大了幻觉风险。
小艾智能体如何实现:
用 LangGraph 的 Memory 持久化能力锁住反馈闭环
小艾智能体给出了自己的解法:
它的工作流引擎跑在 LangGraph 上。LangGraph 给每个 Agent 配了一个 Checkpointer,专门负责:把流程跑到哪一步、各个节点产出了什么、上下文是什么,全部持久化下来。一次长任务中途断了,不用重头启动,能从断点接着跑。
在检索侧,小艾智能体走的是企业级 RAG 方案里的混合检索优化路线:向量检索负责语义理解,全文检索负责精确关键词,两者融合后交给大模型生成。知识图谱 RAG 再补一层,把实体和关系织成网,让回答能带上业务逻辑,把零散的句子归到各自的出处。降低RAG幻觉风险的关键之一,就是给模型喂对真实内容,而且每条都标了出处。
用户点踩、专家改答案,再加上系统自动打的分,这些事件都通过 Agent 编排引擎写回 Memory 和知识库,下一轮问答就站在了上一轮纠错的肩膀上。小艾的闭环落在 LangGraph 工作流里,是一节节真实流转的状态。
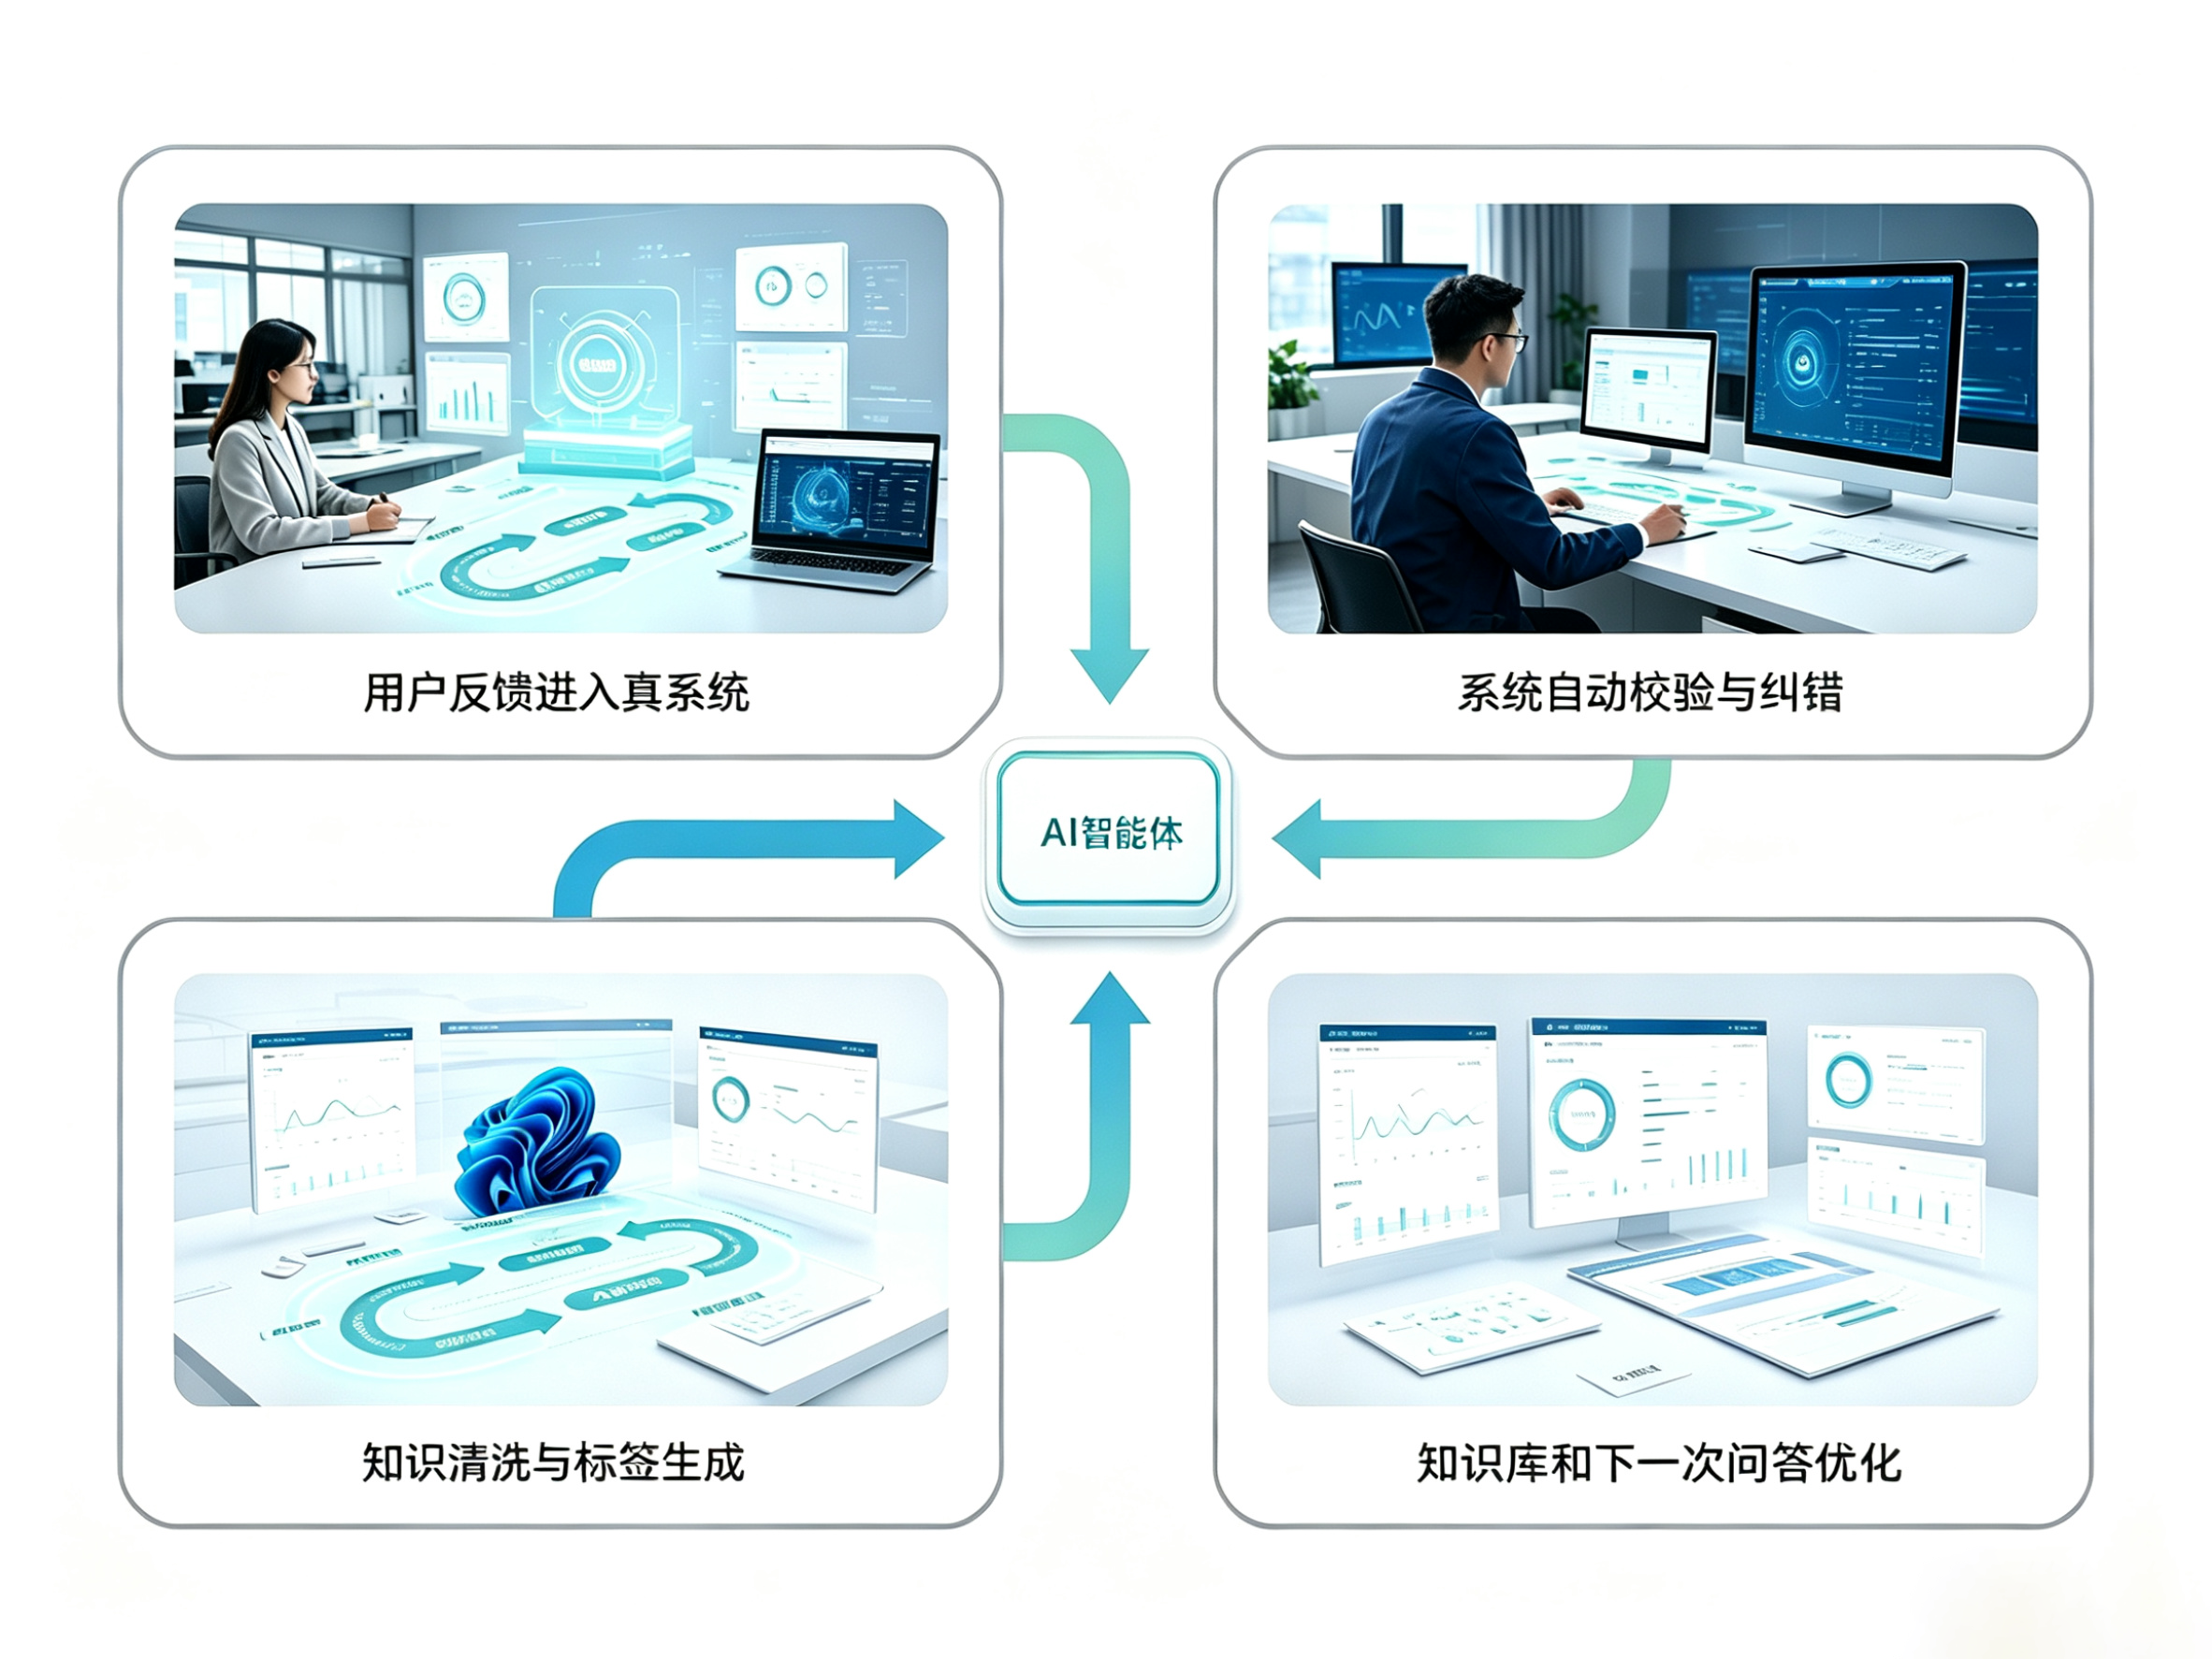
自学习机制,是 AI 系统从"工具"走向"资产"的分水岭
你以为自学习闭环很鸡肋,认为它只是接住反馈,把问答沉淀成知识,让专家改过的答案进循环,再给知识打上标签。但正是这几件事,让企业的知识真正具备了持续积累和进化的能力。每一条经过校验的知识,都有助于提升后续回答质量。