立即咨询
向量检索与 RAG 技术深度解析
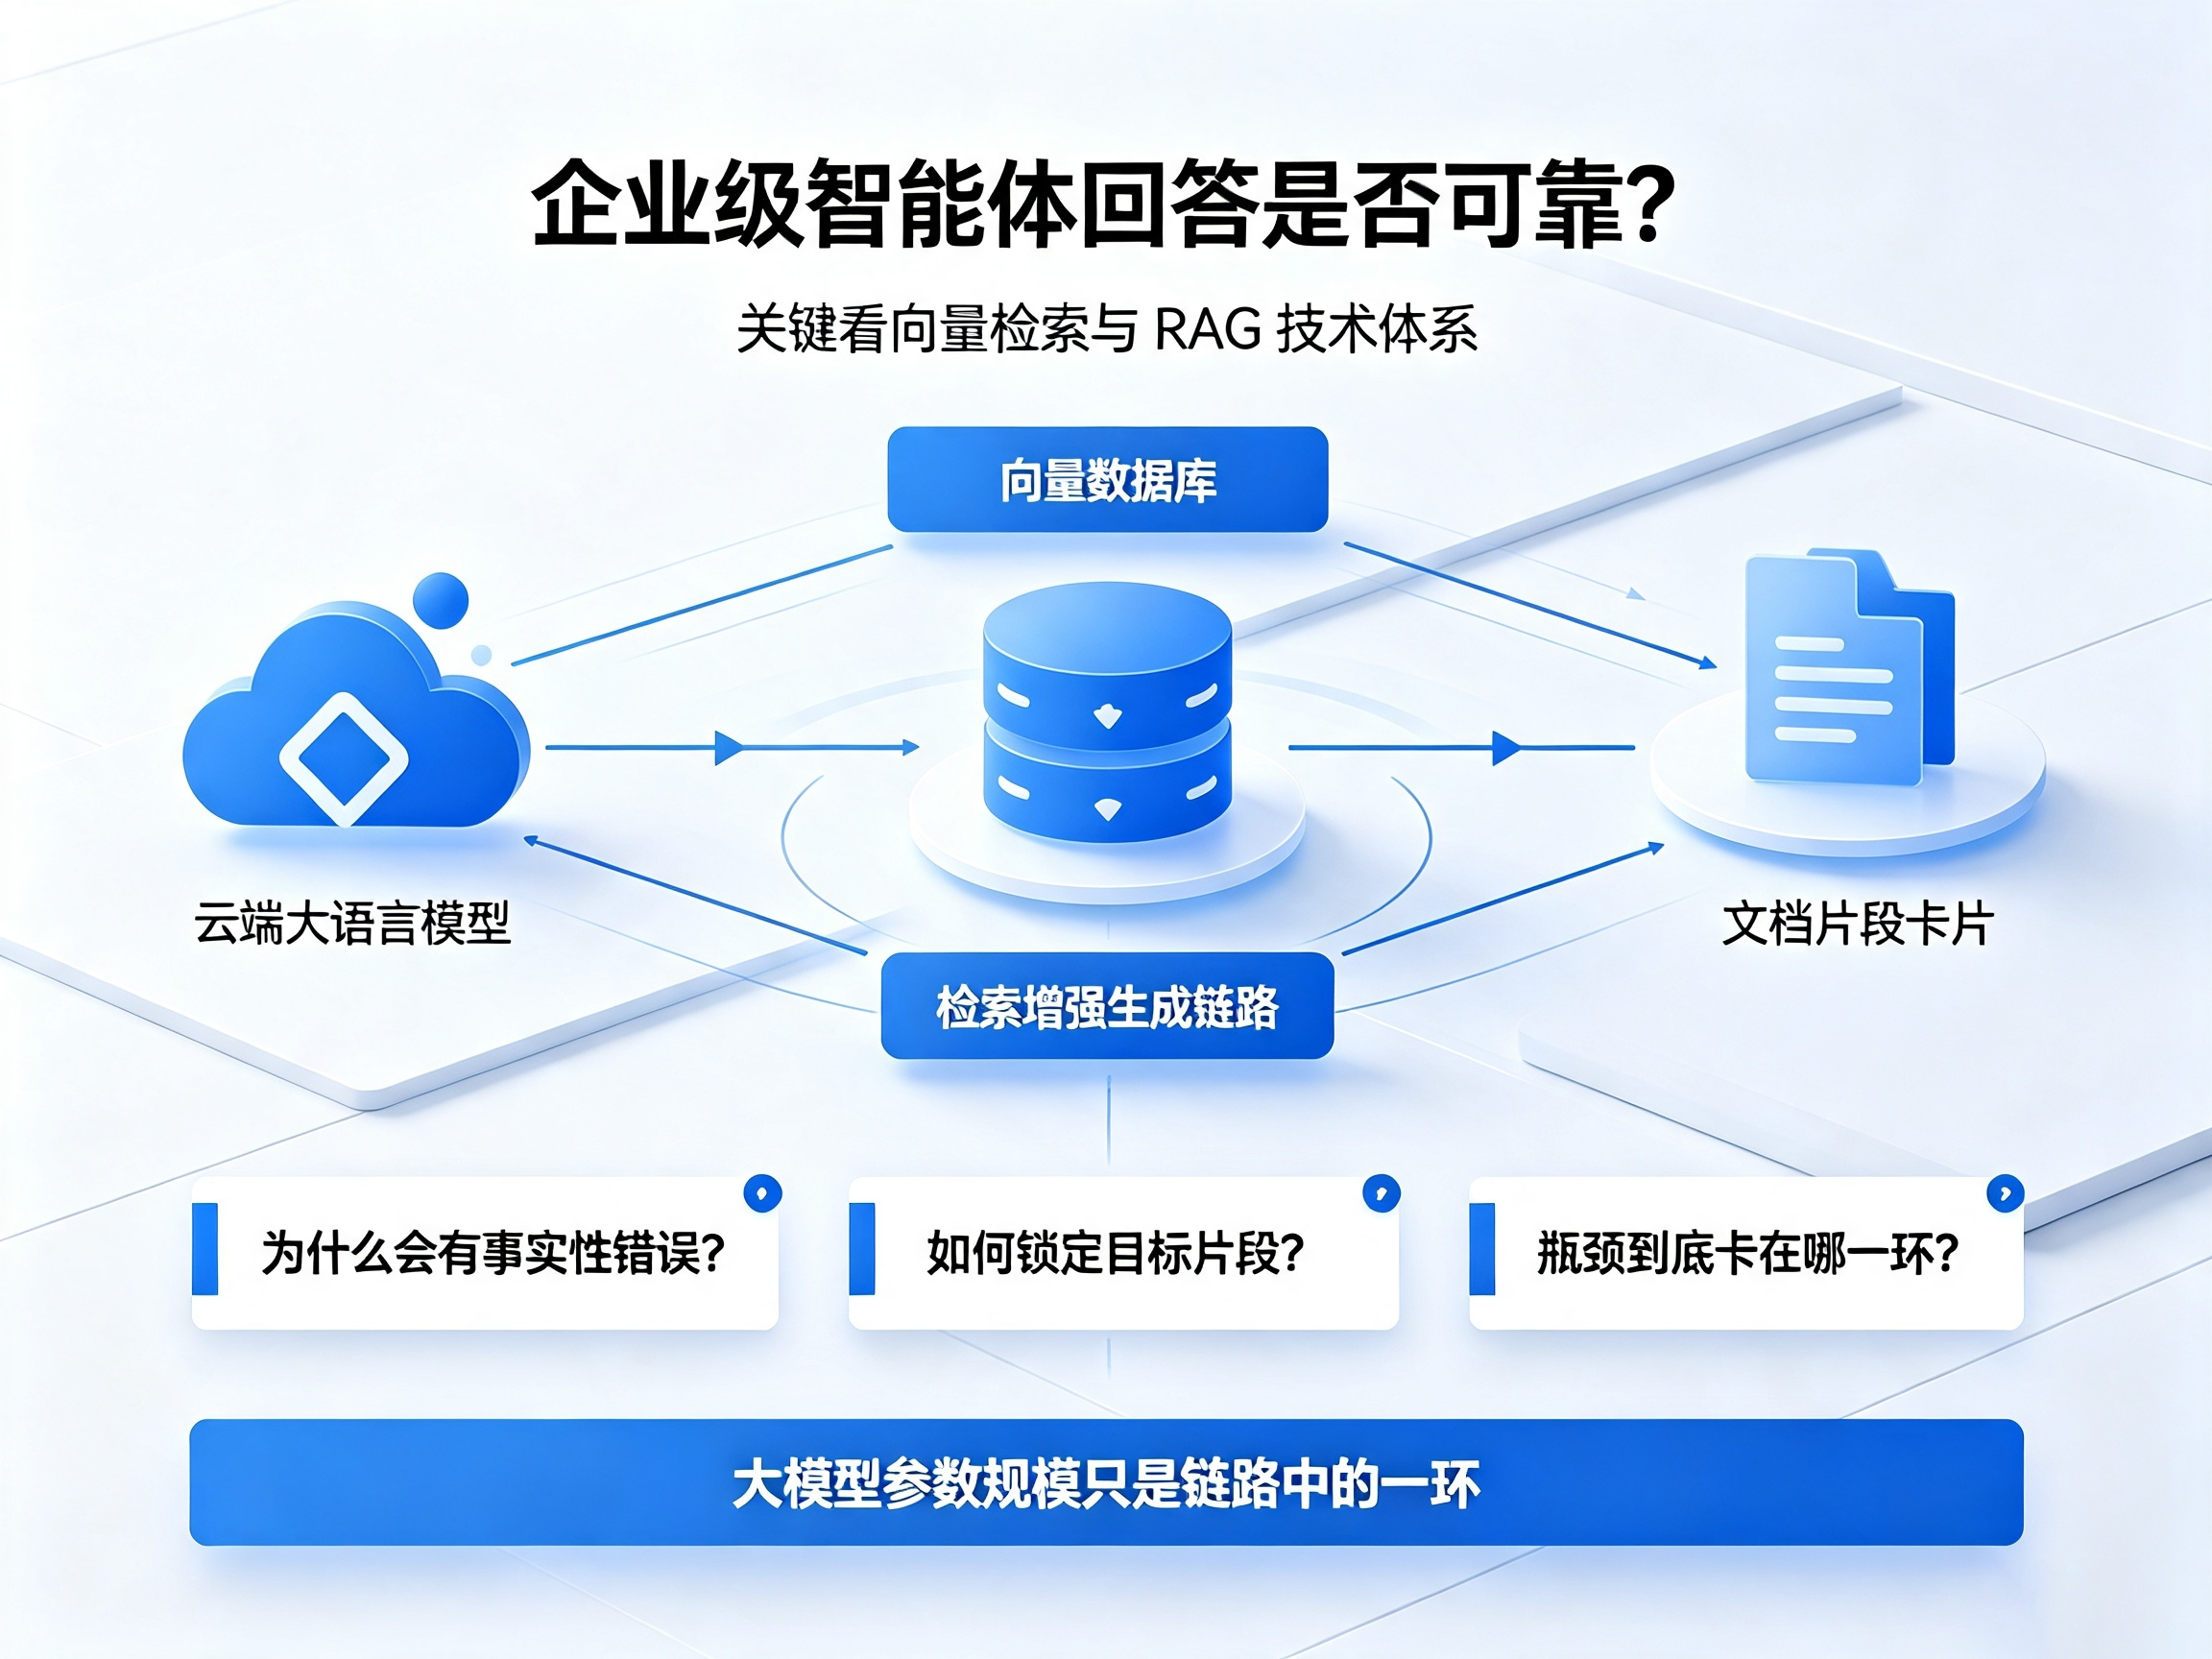
企业级智能体的回答是否可靠,关键看其背后的向量检索与检索增强生成(RAG)技术体系;大语言模型的参数规模,只是这条链路中的一环。本文的核心结论是:大语言模型存在固有的"幻觉"问题如何解决。
进入技术细节前,不妨先想清楚三件事:大语言模型为什么会输出事实性错误?向量检索如何在毫秒级内从百万级文档里锁定目标片段?企业要把这套系统真正用起来,瓶颈到底卡在哪一环?
大语言模型的幻觉成因
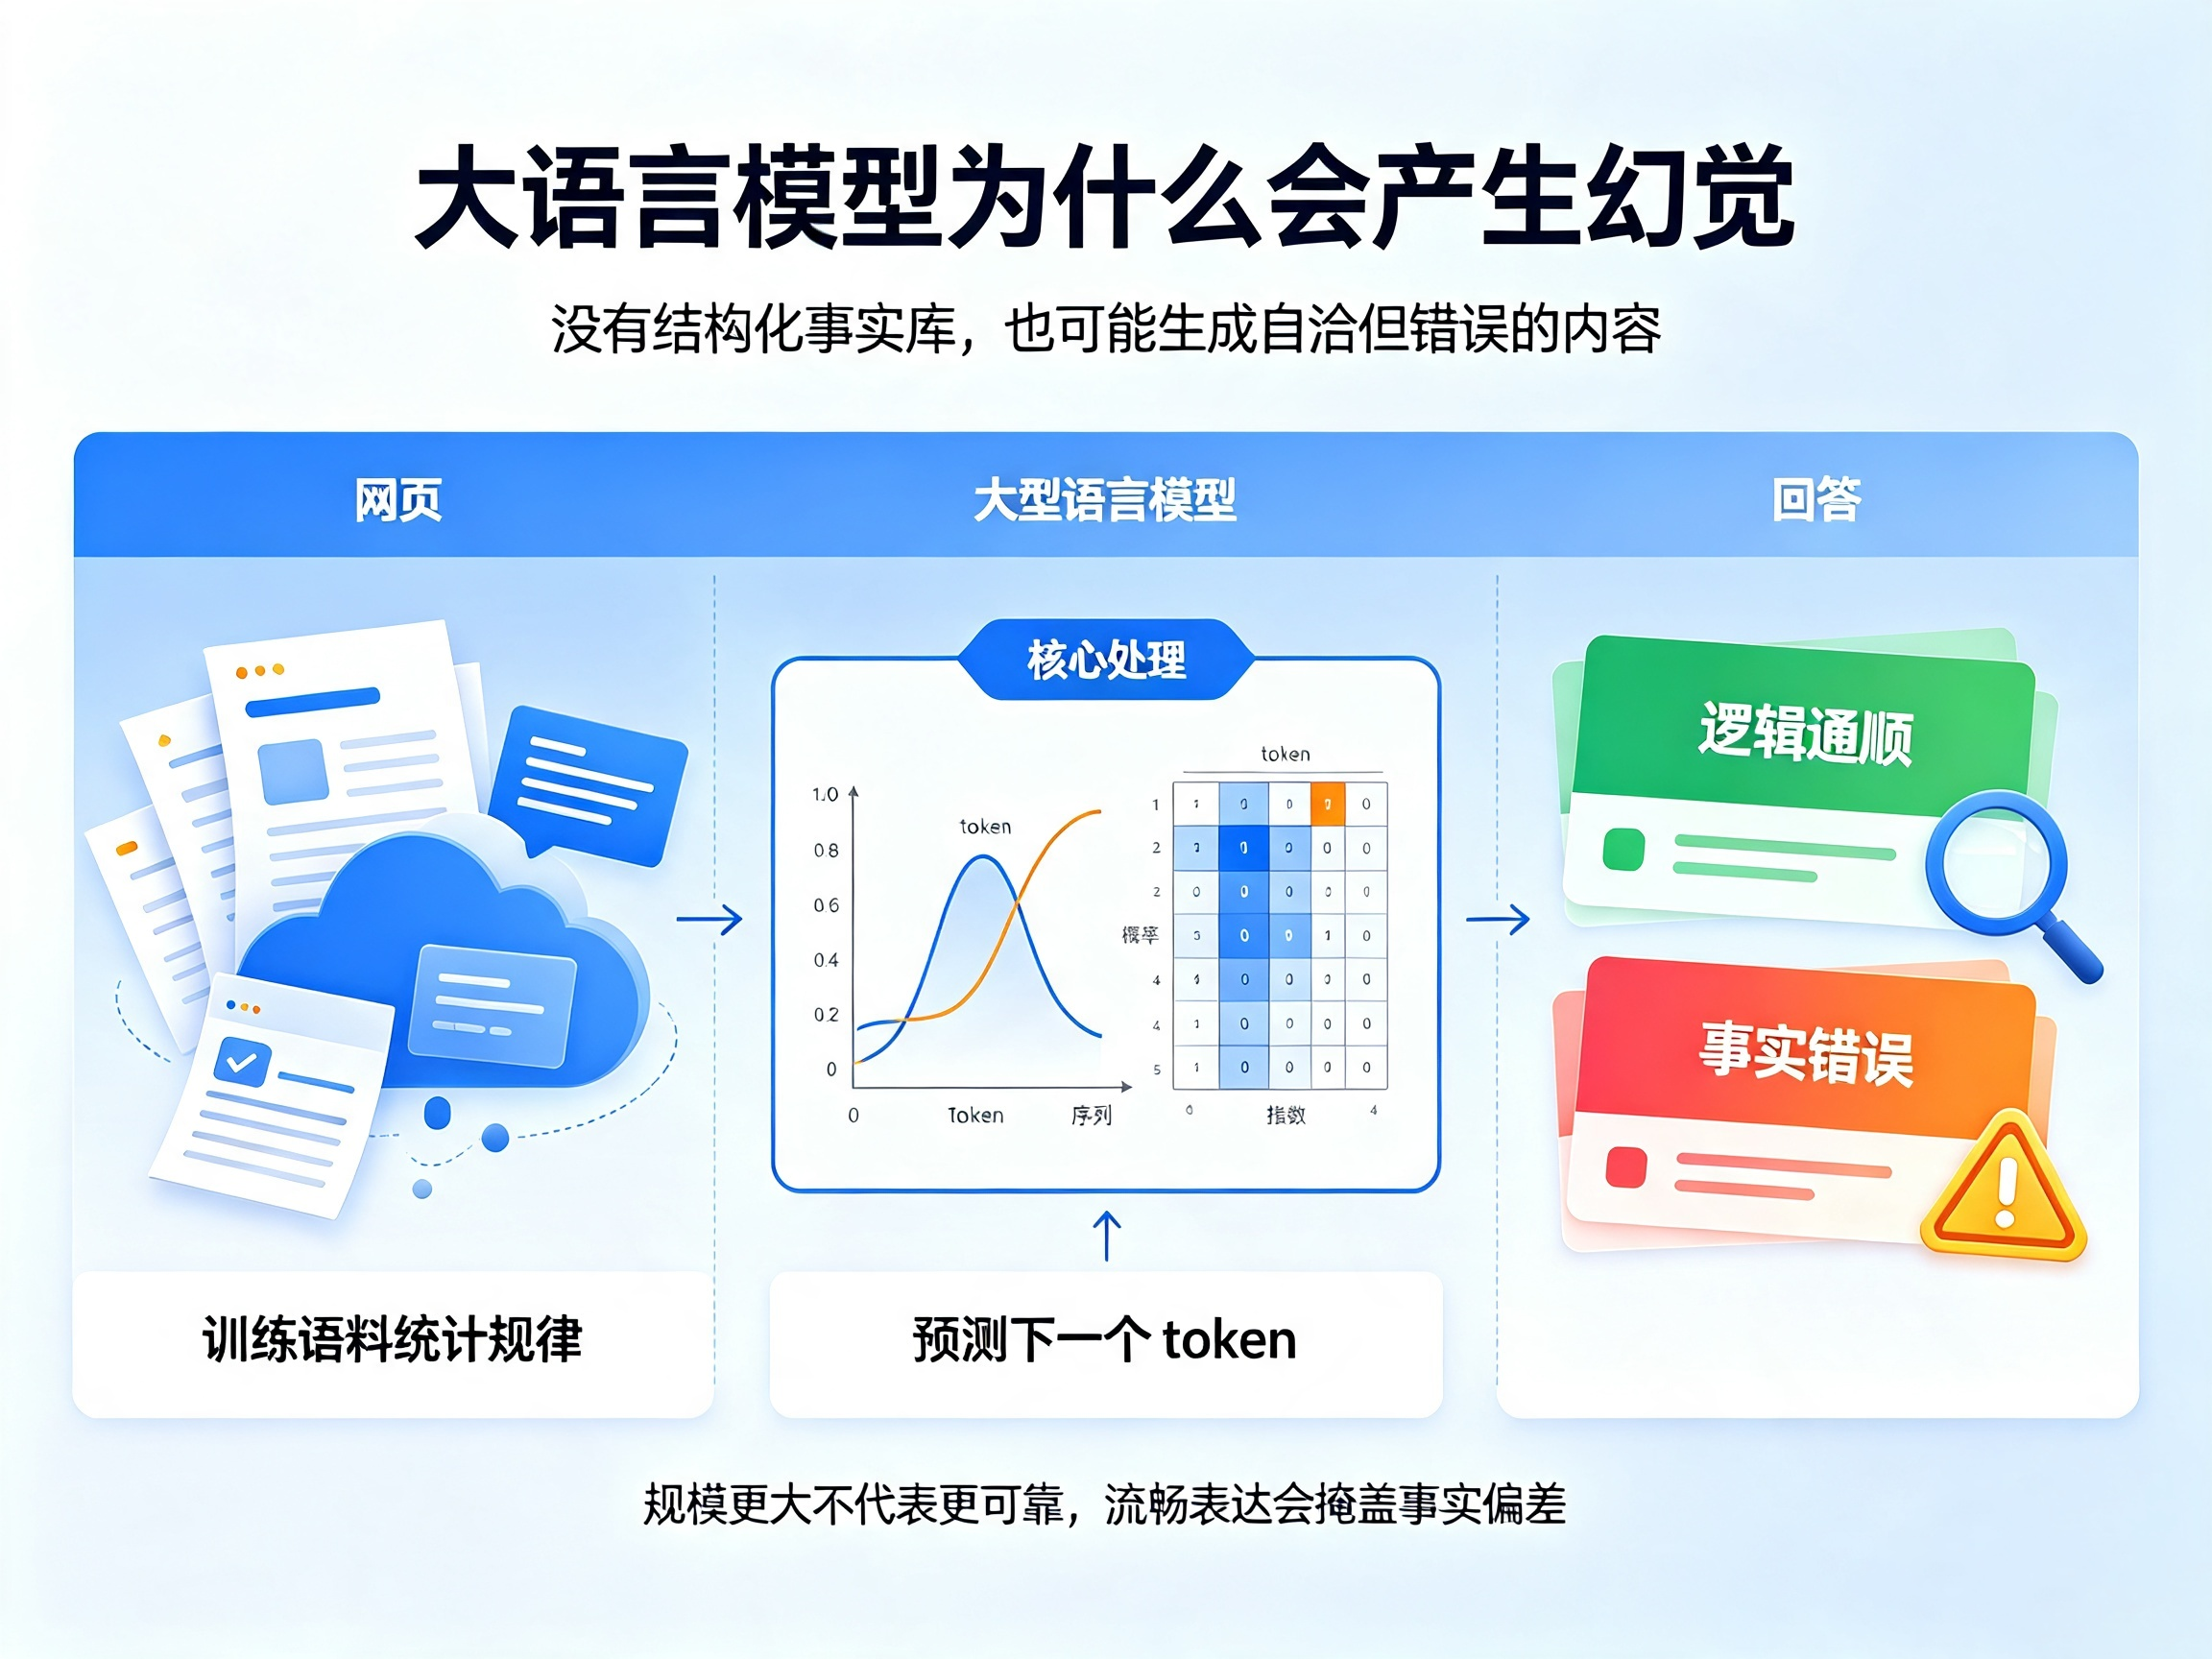
大语言模型本质上是一种基于概率的统计生成系统,其核心机制是根据前文预测下一个 token,预测依据来自训练语料中的统计规律,并不存在一个结构化的事实库作为支撑。当问题涉及模型未充分记忆或记忆混淆的内容时,模型会生成一个在语法与逻辑上自洽、但事实错误的回答。
2023 年发表的综述《A Survey on Hallucination in Large Language Models》(ACM Transactions on Information Systems (TOIS)卷期:Vol. 1, No. 1, Article 1)系统梳理了多项评测结果:即便以 GPT-4 为代表的前沿模型,在事实类与知识密集型问答任务中仍表现出可观比例的幻觉率。在消费级对话场景中,此类错误影响有限;但在企业场景下,一条错误的物料型号、一处偏差的合规条款,均可能引发生产事故或法律纠纷。
有很多人推测:增大模型规模、扩充训练数据即可消除幻觉。然而实证结果恰恰相反——模型参数规模越大、生成越流畅,错误回答的可信度越高,人工审核者越难以从表述中发现异常。
RAG:为模型接入外部知识源
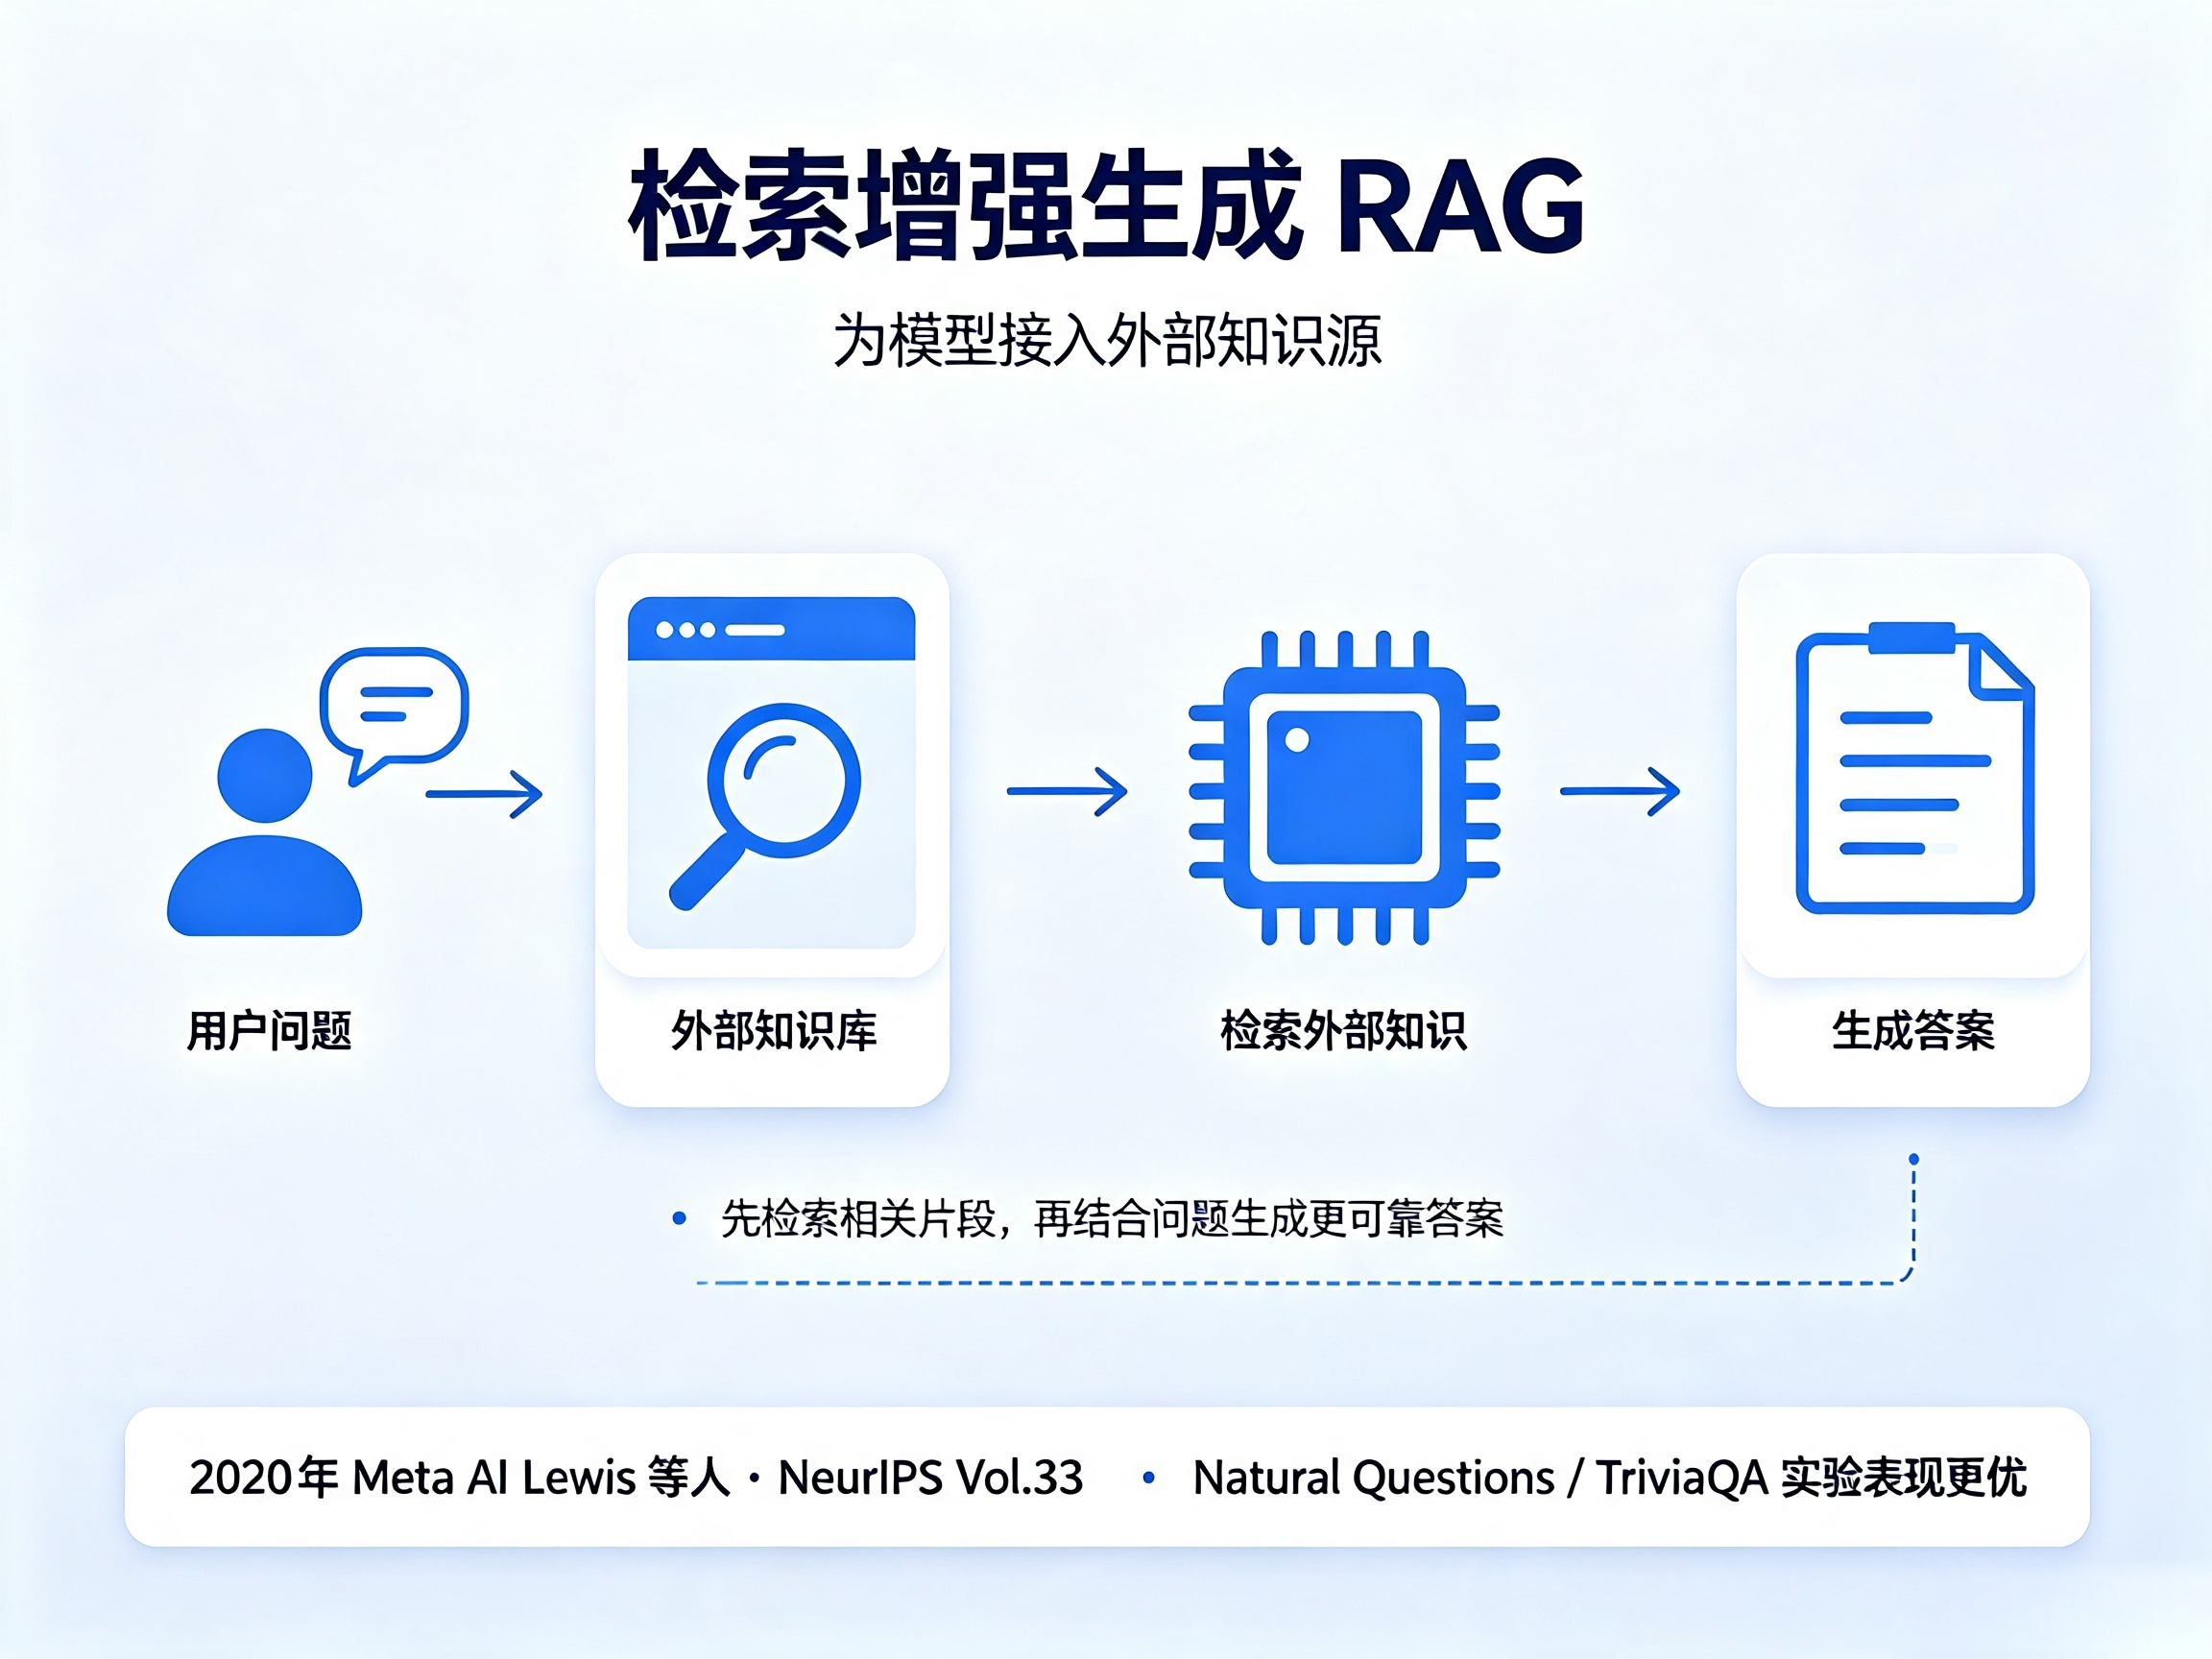
检索增强生成(RAG)的核心思想是在生成前引入检索环节。2020 年,Meta AI 的 Lewis 等人在 NeurIPS 发表《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》(Advances in Neural Information Processing Systems (NeurIPS)卷:Vol. 33),首次将该范式系统化:用户提问后,系统先从外部知识库检索相关片段,再将这些片段与原始问题一并输入大语言模型,引导模型基于真实素材生成答案。
该研究在 Natural Questions、TriviaQA 等基准上的实验表明:引入检索机制后,知识密集型任务的表现显著优于纯生成模型。
向量化
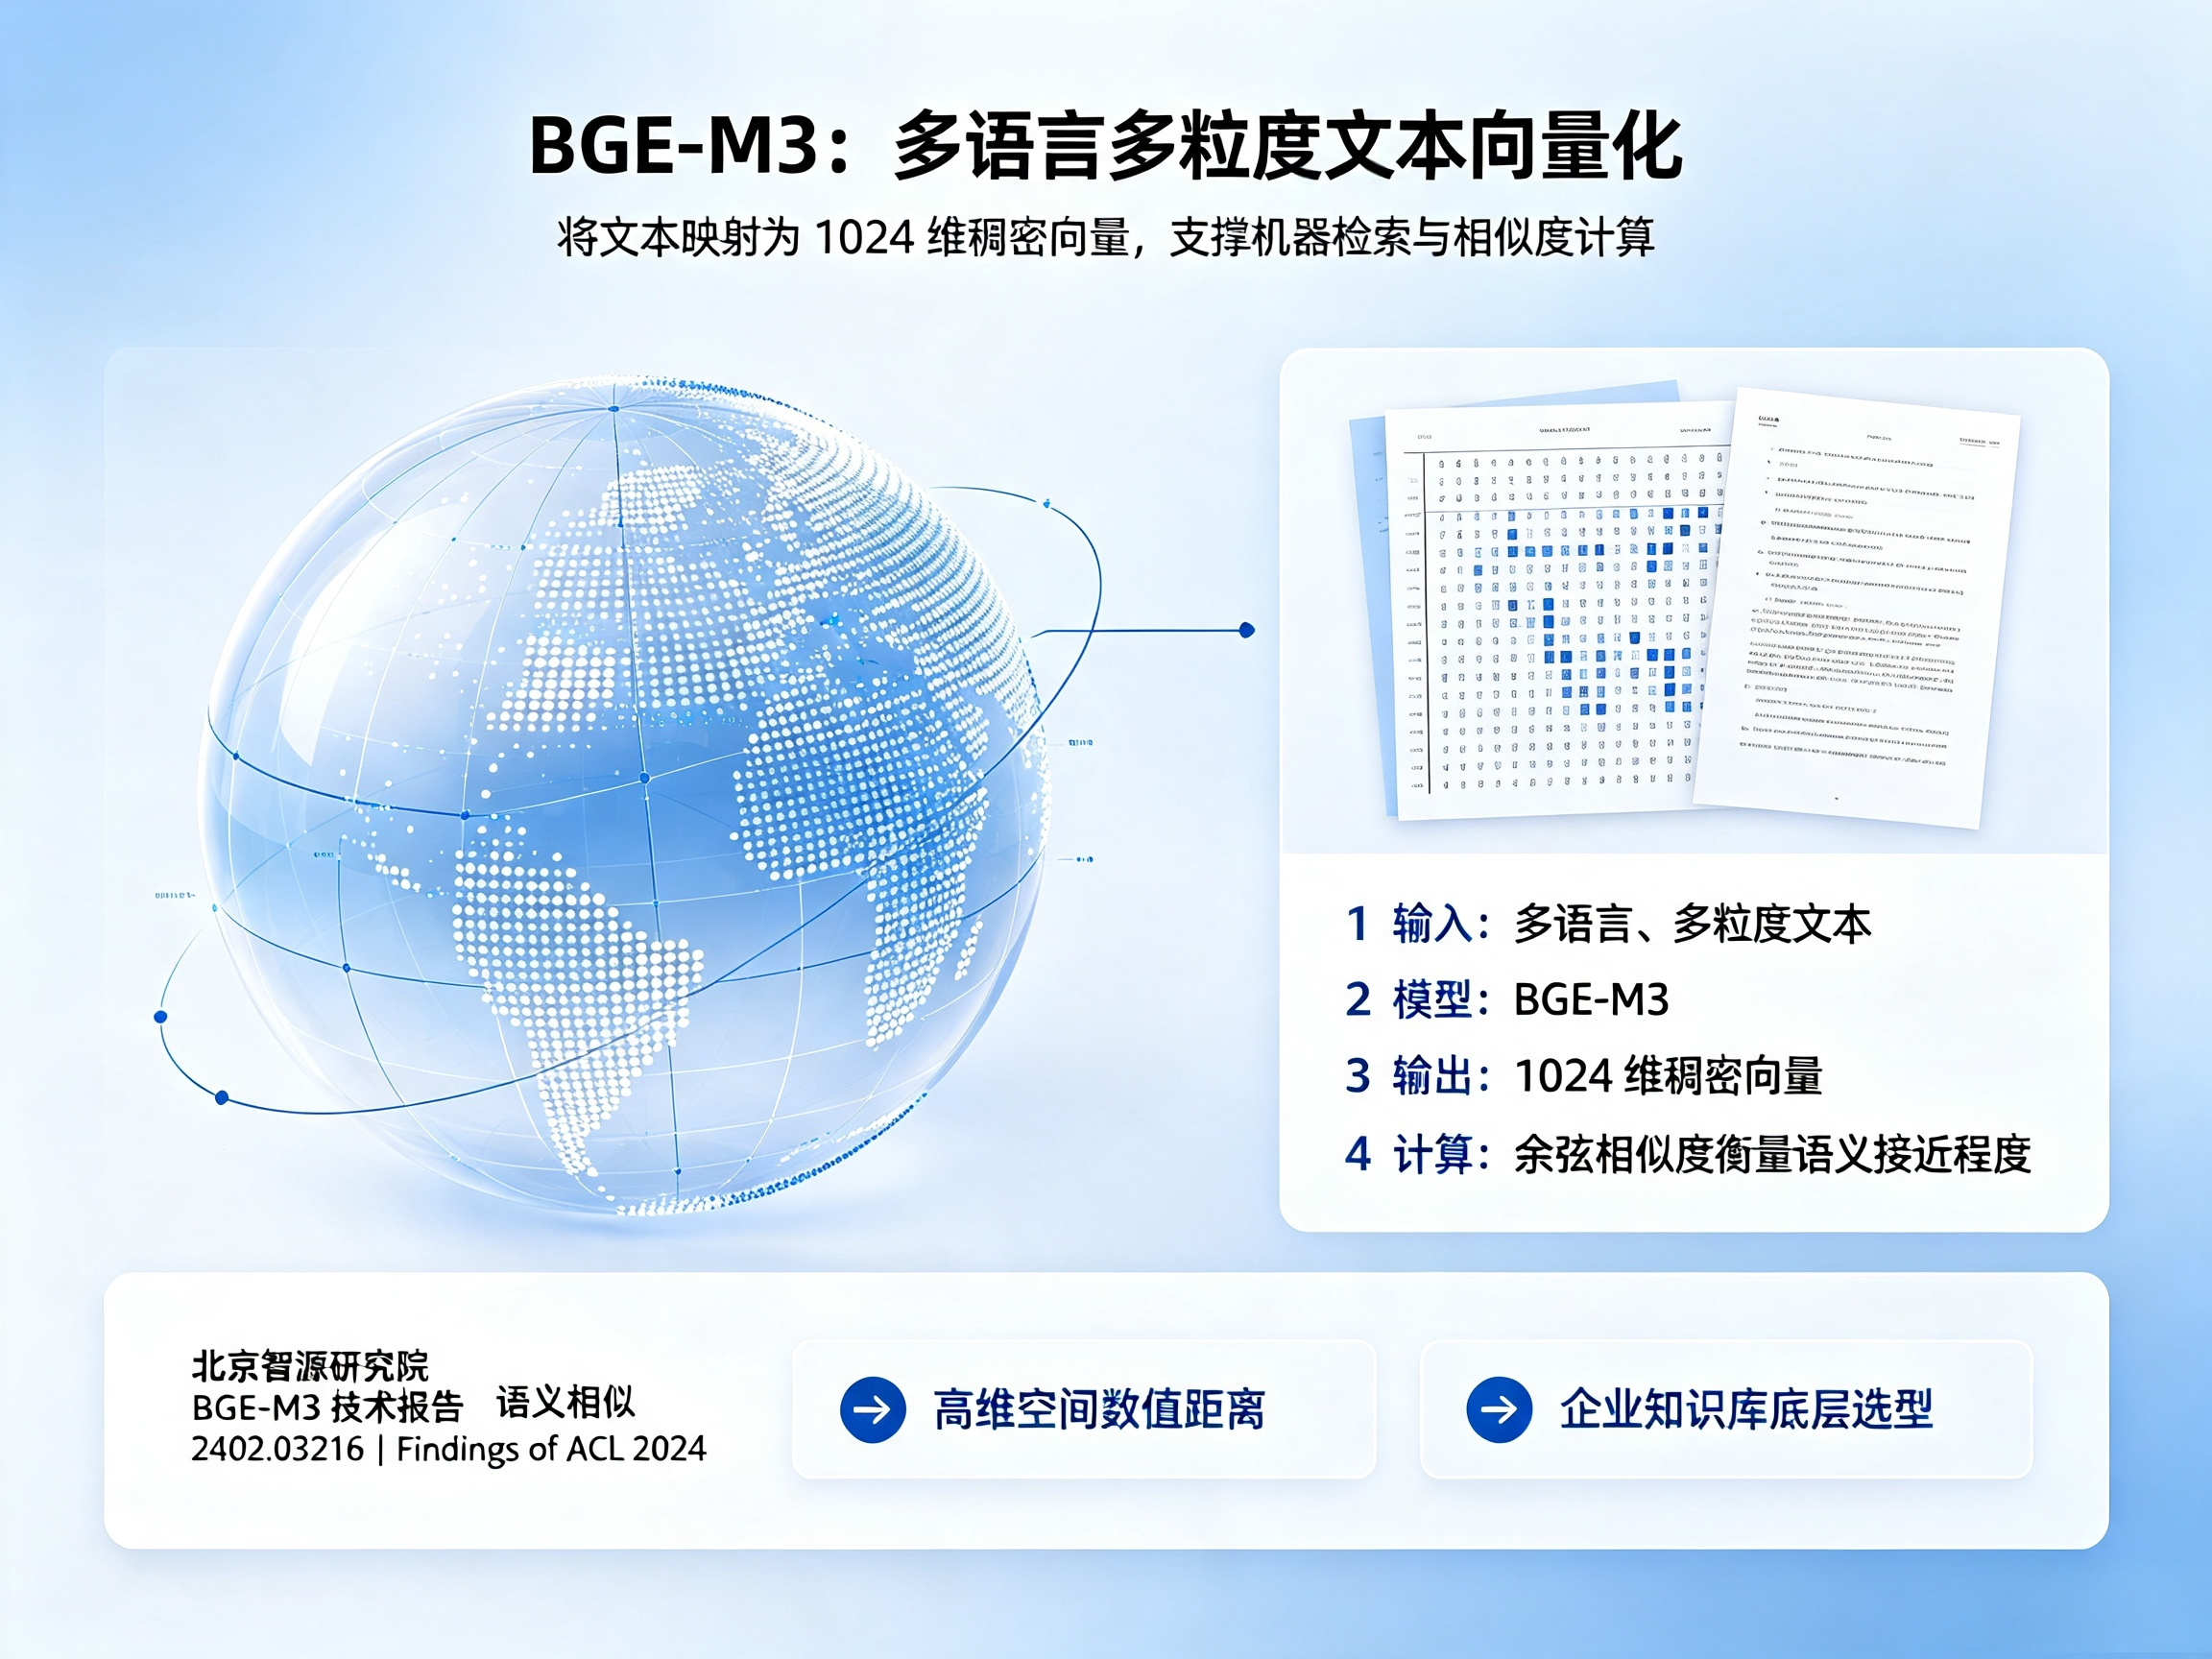
实现机器检索的第一步是将文本转化为数值表示。Embedding(向量化)模型承担此职责:它将一段文本映射为固定长度的稠密向量。以业界广泛采用的 BGE-M3 模型为例,其默认输出维度为 1024。两段文本语义越接近,在 1024 维向量空间中的距离越近,通常使用余弦相似度度量。
语义相似性的判断对人类依赖词义与语境,对机器则依赖高维空间中的数值距离。北京智源研究院于 2024 年发布的 BGE-M3 技术报告表明(2402.03216(2024),Findings of ACL 2024),该模型支持多语言、多粒度文本的稳定向量化,因而成为众多企业知识库的底层选型。
检索策略
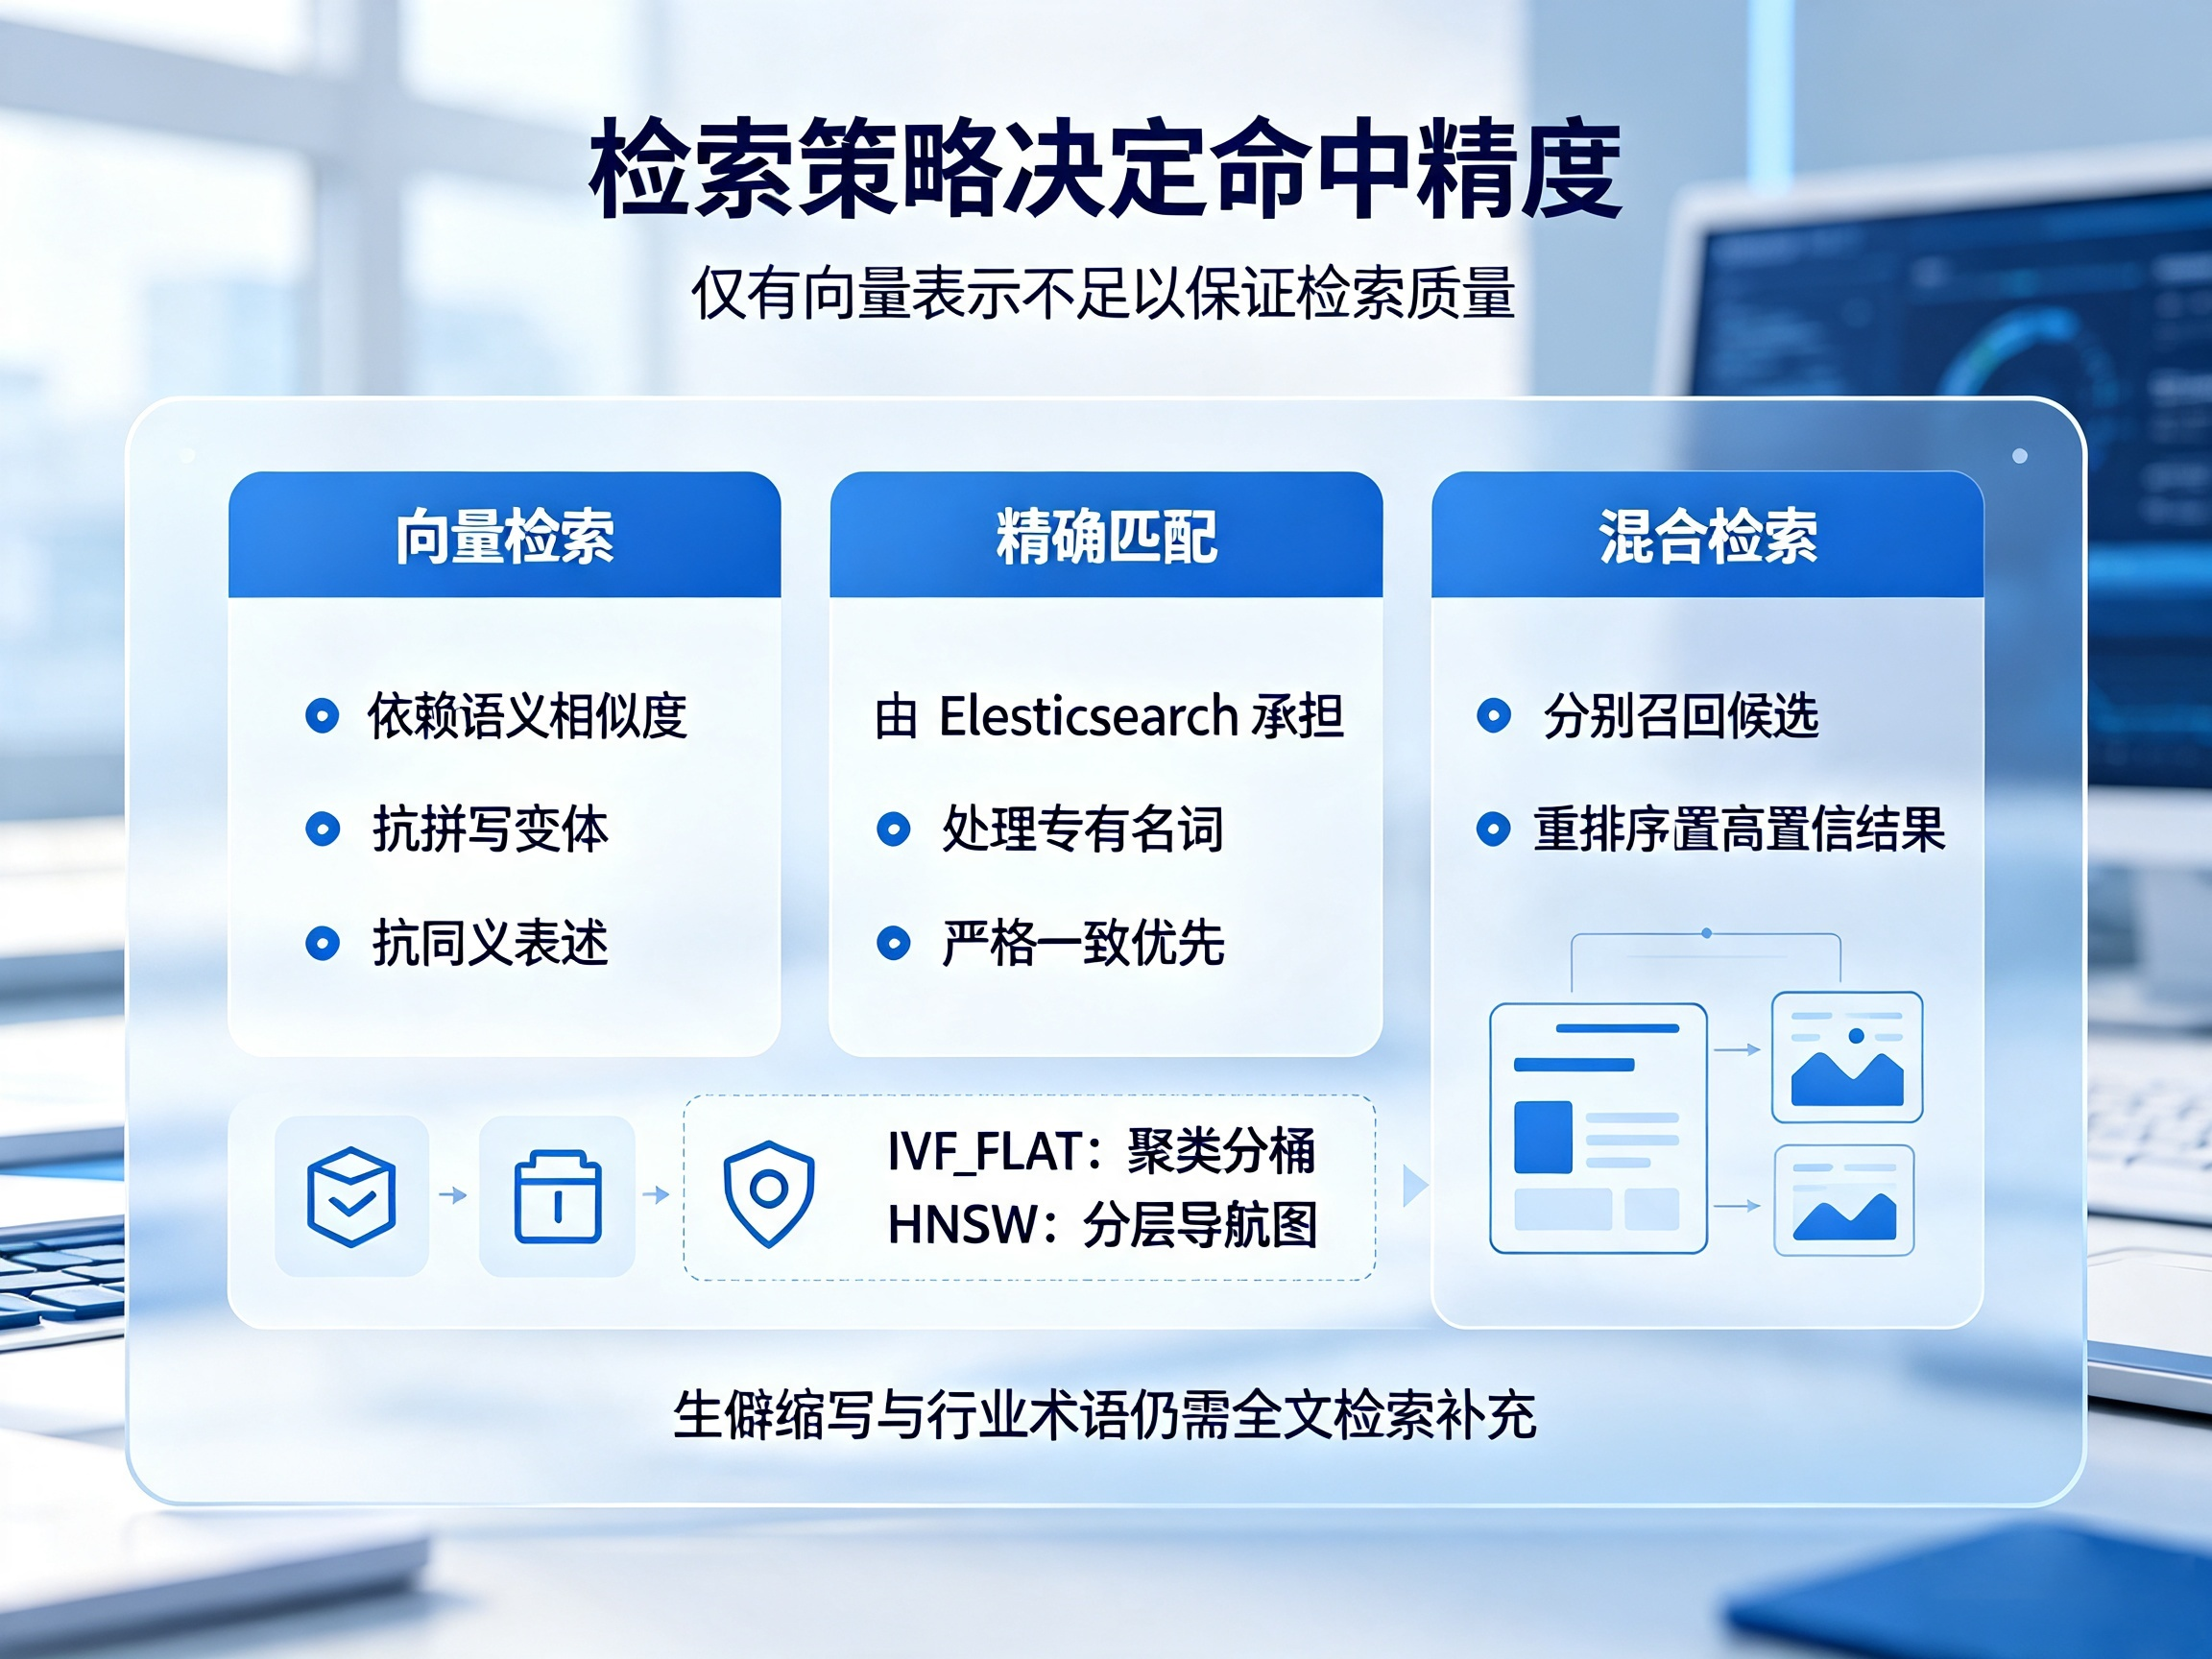
仅有向量表示不足以保证检索质量,检索策略直接决定命中精度。当前主流方案包含三种。
向量检索依赖语义相似度,对拼写变体与同义表述具备抗干扰性,这是其优势。关键词层面的精确匹配则由 Elasticsearch 承担,专门处理专有名词与产品代号这类必须严格一致的内容。混合检索取两者之长:先分别召回候选,再用重排序算法把高置信结果前置。
索引结构同样影响检索效率。IVF_FLAT 通过聚类将向量分桶;HNSW 则构建分层可导航小世界图,查询时沿图结构快速逼近目标。
但向量检索并不能完全替代其他方案。面对生僻缩写、行业术语等场景,纯向量检索可能存在局限,这时就需要全文检索构成的精确匹配。
Milvus
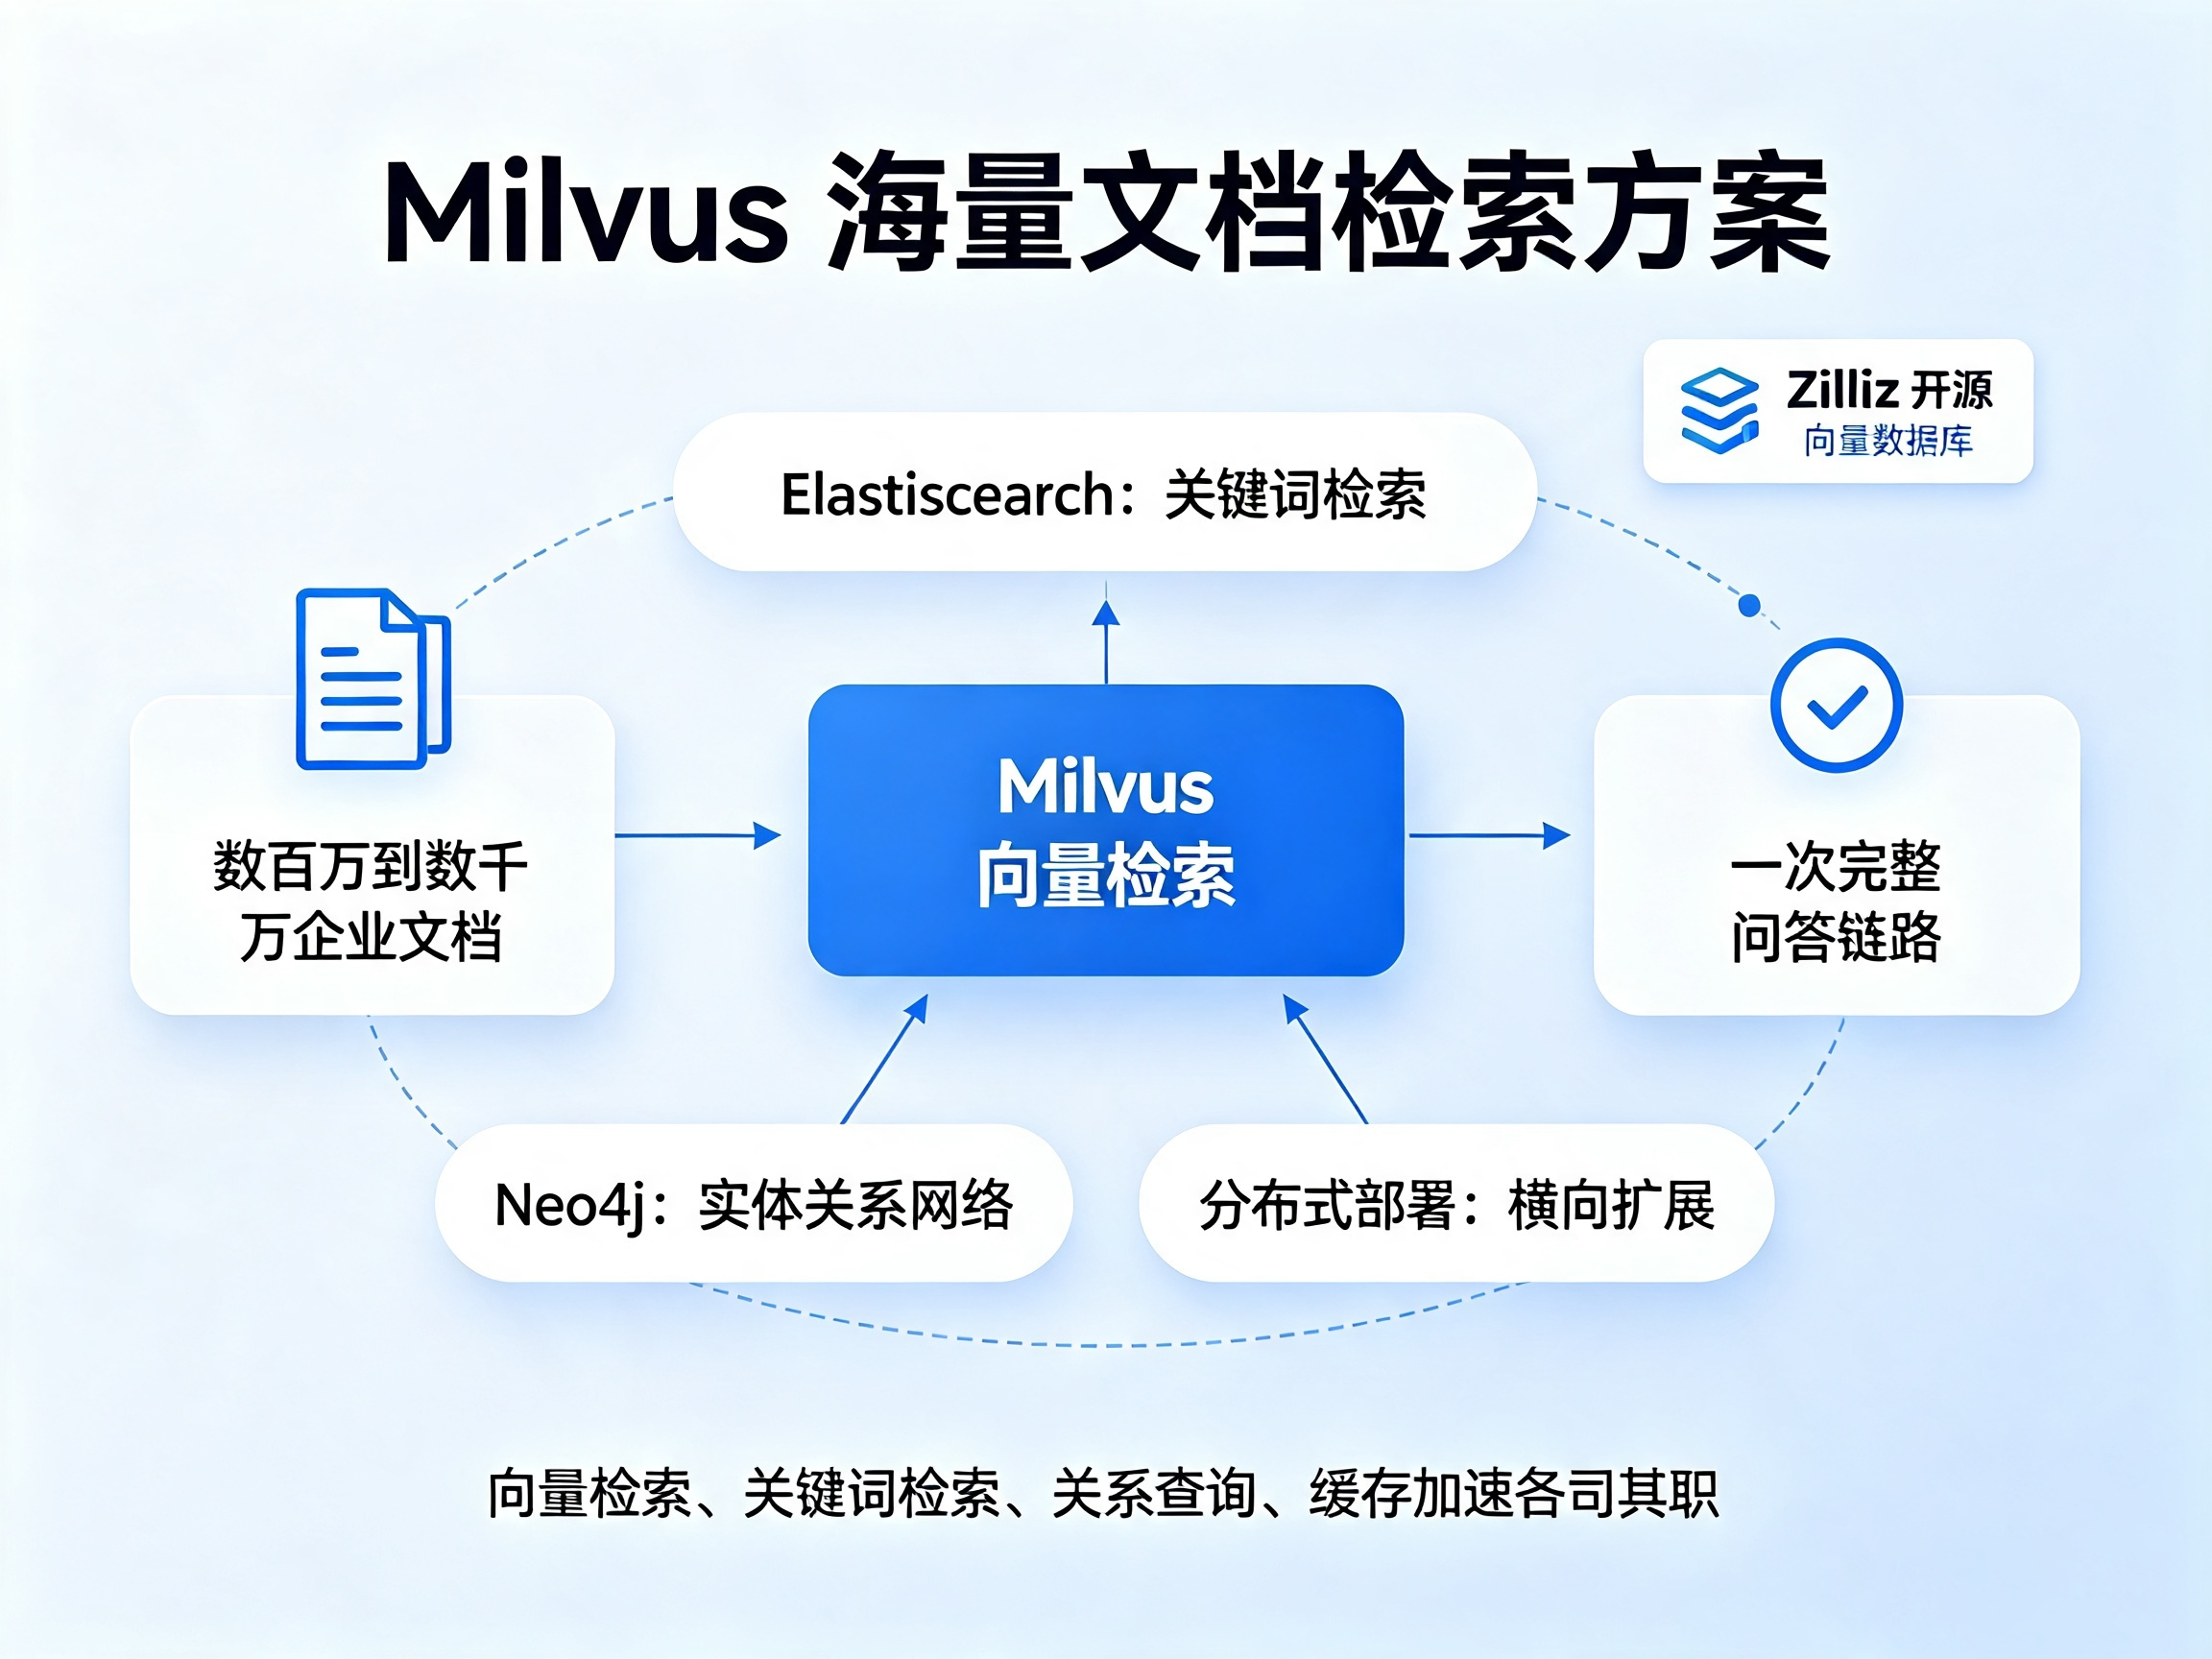
企业文档规模达到数百万乃至数千万时,单机内存方案无法支撑。Milvus 是由 Zilliz 开源的高性能向量数据库,专为海量非结构化数据设计,支持分布式部署。
在典型架构中,Milvus负责向量检索,关键词检索走 Elasticsearch ,实体关系网络落到 Neo4j,频繁访问的数据则交由 Redis 缓存加速。这种分工使一次完整问答链路中的各环节均有专用引擎支撑。
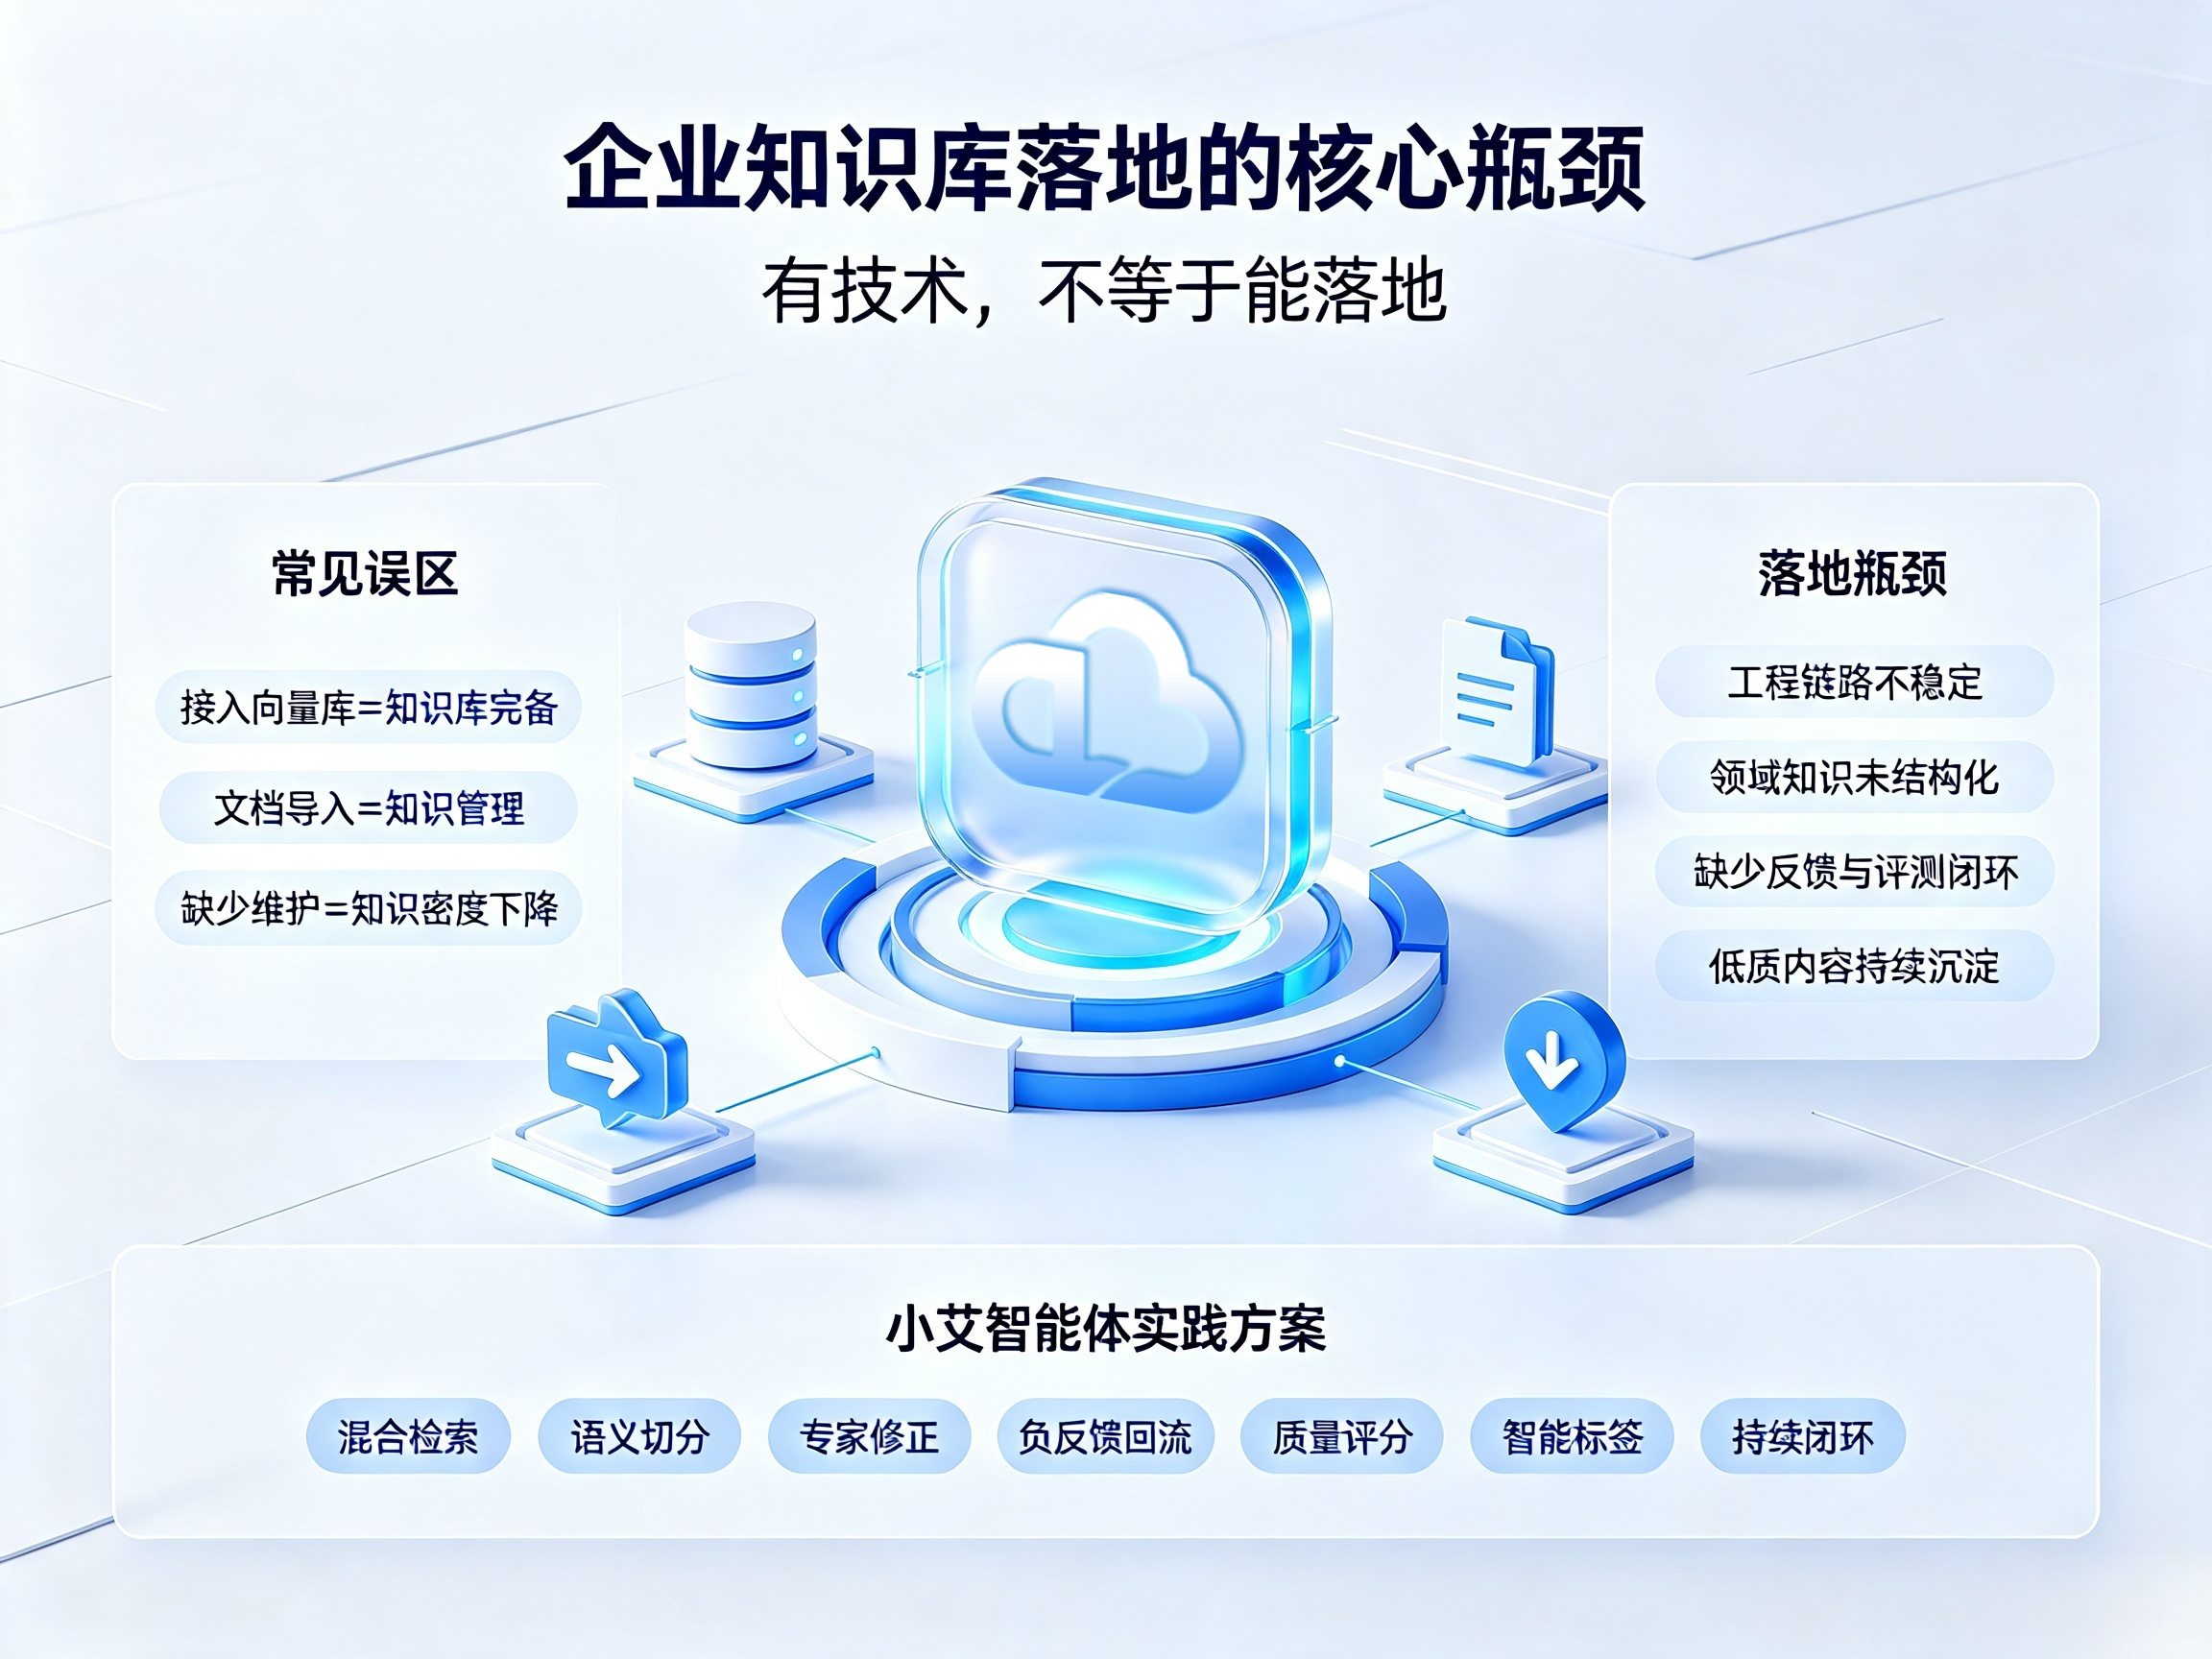
企业落地的核心瓶颈
有技术和能落地并不是一回事。许多团队在接入开源向量库后,便假定知识库已自动完备,结果知识库迅速退化为低质信息仓。
从实操流程上看,首先是工程,检索、重排序与兜底机制必须稳定串联。业务侧:领域 Know-how得有人整理成可检索的结构化文档。数据这一环则要求持续沉淀专家经验、错误案例与反馈并开展评测。将文档导入数据库并不等同于知识管理。缺乏维护机制的知识库,知识密度会越来越低。
小艾智能体系统采用 BGE-M3 ,将企业散落的 PDF、Word、Excel 文档切分为语义片段并存入 Milvus,叠加 Elasticsearch 全文检索层,通过混合检索将无序文档转化为可问答的知识流。其自学习机制进一步将用户负反馈标记的回答交由专家修正,并回流为新的知识条目,辅以质量评分与智能标签自动生成。通过持续运转"检索—生成—反馈—再检索"闭环,小艾智能体提供了可参考的实践方案。